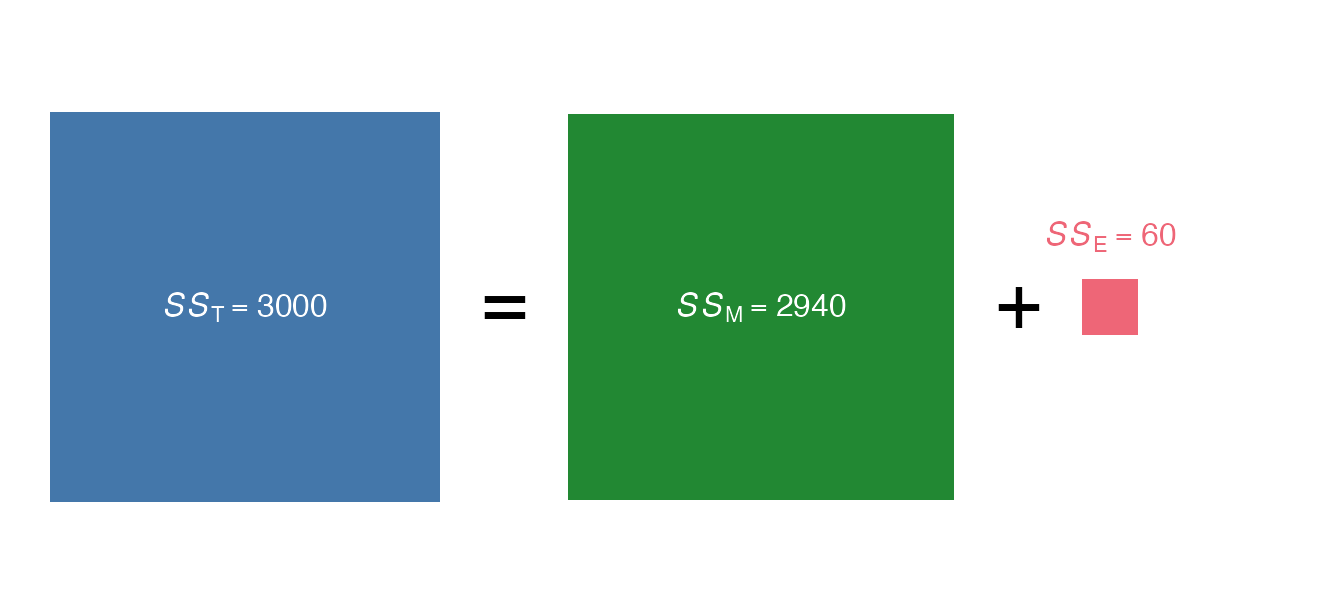0. Opfris — enkelvoudige regressie vóór het echte werk
Sjonge sjonge — daar gaan we weer
“Sjonge sjonge,” zei de das, en hij bleef in zijn hol liggen. “Alleen opstaan kost me al moeite. En dan nog extra moeite per ding dat ik vandaag moet doen. En dat zijn er nogal wat.”
Aan het begin van MVDA is dat een bekend gevoel. Regressie ophalen, want dat heb je ooit gehad. ANOVA ergens vandaan halen — die was anders, of niet? ANCOVA, MANOVA, logistische regressie, repeated measures, mediatie — dat komt allemaal nog. Sjonge sjonge.
Dus voor we daaraan beginnen, eerst dit: één kort hoofdstuk waarin we enkelvoudige regressie ophalen — niet om je voor schut te zetten als je het niet meer weet, maar omdat het echt wat helpt. Het is een tijdje geleden voor de meesten. Geen schaamte. Even terug naar het simpelste model dat we hebben.
En kijk: in wat de das zei, zit eigenlijk al alles wat je over enkelvoudige regressie hoeft te weten. “Alleen opstaan kost me al moeite” — dat is een basisniveau: wat er al is bij nul dingen, als . “Extra moeite per ding” — dat is een helling: hoeveel er per eenheid bijkomt. Samen vormen die twee getallen een lijn. En een lijn — dat is wat een regressiemodel doet.
De das gaat ervan uit dat elk ding hem iets kóst. Of dat klopt, zie je zo meteen in de data: een ding kan ook iets opleveren.
We doen dit hoofdstuk in zeven stappen:
Negen sjacherijns — een mini-dataset waarbij je de regressielijn met het potlood kunt tekenen, zonder formule.
Formules erbij — pas dan praten we over en , wat ze betekenen, en hoe ver je de lijn mag doortrekken.
Hoe goed werkt onze lijn? — DATA = FIT + RESIDU, de drie kwadratensommen als plaatje, en als hoofdmaat.
Toetsen — vrijheidsgraden, de ANOVA-tabel als sudoku, wat een -toets eigenlijk zegt, en waarom en hier hetzelfde zeggen.
, en — drie getallen, één verhouding.
Waarom MVDA straks anders wordt — vooruitkijk naar wat er verandert zodra er meer dan één voorspeller in het spel is.
Wat hierna komt — een korte teaser per thema, zonder uitleg.
Wat een toets eigenlijk zegt, komt hier één keer langs, met een bakker erbij. Hoe je toetsen rapporteert en wanneer je welke kiest, hoort bij thema 1 en verder.
TipWat je na dit hoofdstuk moet kunnen
Dit hoofdstuk is de bodem onder thema 1. Na dit hoofdstuk kun je:
en uit de uitvoer van lm() halen, in gewone woorden zeggen wat ze over vertellen, en zeggen of iets betekent;
bij een gegeven de voorspelde en het residu uitrekenen;
de variantie in splitsen in wat het model verklaart en wat overblijft (), en daaruit halen;
een halve ANOVA-tabel aanvullen: de ontbrekende , , en terugrekenen uit wat er wél staat;
de nulhypothese opschrijven als uitspraak over de populatie, en zeggen wat de -waarde wel en niet zegt;
de -toets van het model en de -toets van de helling lezen, en zien dat ze bij één voorspeller hetzelfde zeggen;
uitleggen waarom bij één voorspeller het gestandaardiseerde gewicht gelijk is aan de correlatie.
In R doe je dat met lm(), summary() en anova().
0.1 Negen sjacherijns — intuïtief zien
De dag is begonnen. Negen diertjes liggen, hangen, of staan ergens — geen van allen heeft zin. Een das blijft in zijn hol. Een muis kijkt naar zijn nestje vol zandkorrels en weet wat-er-zou-moeten, maar het hoeft niet. Een mus kuiert wat door de struiken zonder zelfs te neuriën.
De vraag voor vandaag: als ze toch wat taakjes oppakken — hoe groot is het verschil aan het eind van de dag in hoe rustig ze kunnen slapen?
Elk diertje heeft één hoofdtaak voor vandaag. Sommige doen ’m niet (das blijft in hol), sommige doen ’m één of twee keer, en de bunzing — die ondanks zichzelf onafgebroken sluiproutes is gaan verkennen — doet hem acht keer. De ironie van de meest-sjacherijn-zijnde sjacherijn die de meeste rondjes afmaakt zonder het te merken.
We vragen: hoe is hun slaaprust ’s avonds, op een schaal van tot ?
OpmerkingVraag 0.1.a — Pen-en-papier (eerst kijken, dan rekenen)
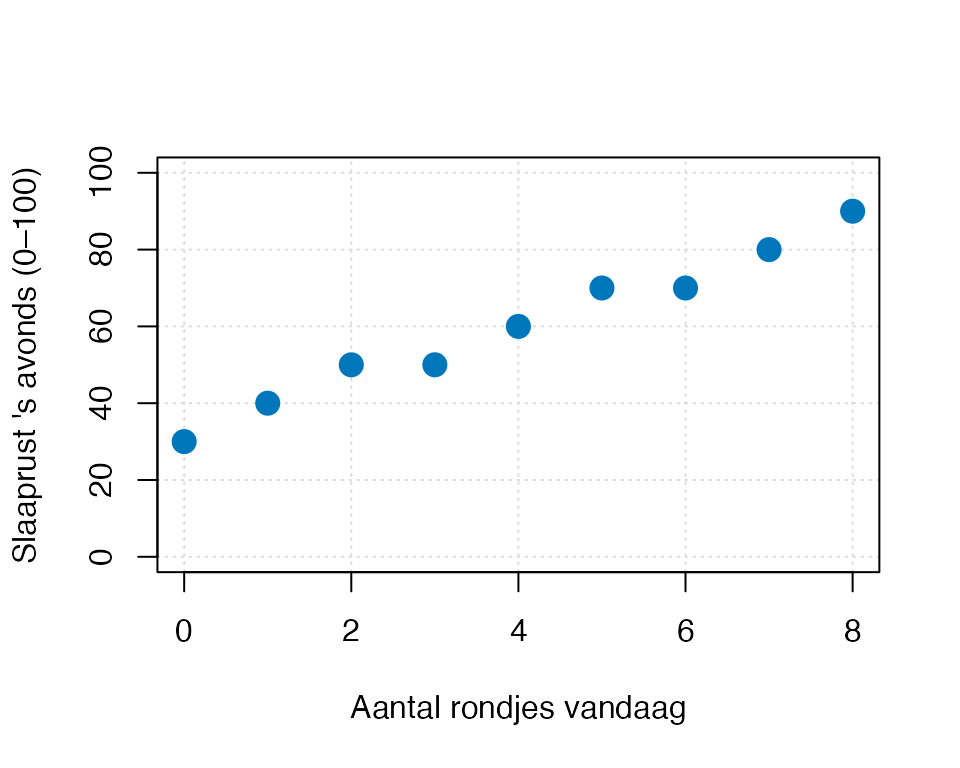
Hieronder zie je de scatter van de data. Geen formule nog. Geen R. Alleen kijken.
Figuur 1: De negen sjacherijns: per diertje het aantal rondjes dat het vandaag deed, tegen zijn slaaprust ’s avonds (0–100).
a) Pak een potlood (of denk in je hoofd). Teken de lijn die volgens jou het beste door deze negen punten loopt. Niet uitrekenen — gewoon zien.
b) Waar snijdt jouw lijn de y-as? Dat is het basisniveau — een sjacherijn die nul rondjes doet (de das, die in zijn hol blijft): hoe rustig slaapt hij ’s avonds?
c) Hoeveel stijgt jouw lijn als je één eenheid naar rechts gaat? Dat is de helling — per extra rondje, hoeveel rustiger slaap je?
OpgeletAntwoord 0.1.a — open na je eigen poging
a) De punten liggen bijna op een rechte lijn. Met het oog trek je hem ergens van de das linksonder, , naar de bunzing rechtsboven, . De lijn die je zo meteen uitrekent, loopt net iets vlakker: van naar , omdat de zeven punten ertussen ook meetellen.
b) Jouw lijn snijdt de y-as ergens rond de (op schaal –); de uitgerekende lijn doet het bij . Dat is je intuïtieve : de slaaprust die de lijn voorspelt voor een sjacherijn die nul rondjes doet. De das zelf, die in zijn hol bleef, zit op . Niet bovenmatig laag, niet bovenmatig hoog. Sjacherijn-baseline. Hij is er, hij ademt, hij eet ergens een wortel, maar veel verder komt hij niet zomaar.
c) Per extra rondje stijgt de lijn met ongeveer . Dus per taakje dat hij vandaag oppakt: slaaprust ’s avonds. Niet veel per taakje. Maar hij heeft het niet door dat dit gebeurt. De sjacherijn die ondanks zichzelf het meeste deed, de bunzing met rondjes, slaapt het rustigst.
Inzicht. Je hebt zojuist met je oog gedaan wat een regressiemodel doet: een rechte lijn door een wolk punten leggen. Het basisniveau heet straks (de intercept), de helling heet . Aandacht doet meer dan je denkt — ook voor sjacherijns. Hieronder zien we hoe je dat exact uitrekent.
0.2 Formules erbij — eindelijk
De regressievergelijking zegt: de uitkomst ligt op een rechte lijn van , plus een beetje toevalsruis :
In gewone woorden, en met de woorden van de das:
= basisniveau. “Alleen opstaan kost me al moeite” — wat er al is op het moment dat . Bij ons: de slaaprust van een sjacherijn die geen enkel rondje afwerkt.
= helling. “Extra moeite per ding” — hoeveel verandert per eenheid stijging in . Bij ons: hoeveel extra slaaprust per extra rondje. Hier had de das het mis: bij hem kost elk ding iets, bij onze sjacherijns levert elk rondje rust op.
= residu. Wat het model nog niet snapt — de afwijking van punt van de lijn.
Voor enkelvoudige regressie zijn en rechtstreeks uit de data te halen:
waarbij:
De formule voor zegt ook iets over de lijn zelf: hij loopt altijd door het punt , het midden van de wolk.
OpmerkingVraag 0.2.a — Pen-en-papier (uit het hoofd te doen)
Voor onze negen sjacherijns:
a) Bereken en . (Tip: — wat is de som? En de som van ?)
b) Bereken .
c) Bereken .
(Tip bij b en c: zet het in een tabel met één rij per diertje en kolommen voor , , hun kwadraten en hun product. De somrij geeft je de antwoorden.)
d) Bereken en .
e) Toets je antwoord tegen de R-output hieronder.
m_sj <-lm(slaap_rust ~ rondjes, data = sjacherijns)round(coef(m_sj), 3)
(Intercept)     rondjes
         32           7
OpgeletAntwoord 0.2.a — open na je eigen poging
a) , dus . , dus .
b) en c) De hele tabel, met de somrij onderaan:
De negen sjacherijns en hun afwijkingen van het gemiddelde
Dier
das
0
30
−4
−30
16
900
120
muis
1
40
−3
−20
9
400
60
mus
2
50
−2
−10
4
100
20
egel
3
50
−1
−10
1
100
10
kikker
4
60
0
0
0
0
0
konijn
5
70
1
10
1
100
10
merel
6
70
2
10
4
100
20
veldmuis
7
80
3
20
9
400
60
bunzing
8
90
4
30
16
900
120
Som
60
3000
420
Note. = aantal rondjes, = slaaprust (0–100). De somrij telt de laatste drie kolommen op.
en staan in de somrij. De kolom telt op tot ; die heb je nu nog niet nodig, en hij komt terug als , de totale kwadratensom.
d) . .
e) De R-uitvoer zegt hetzelfde: en , precies.
Inzicht. Je schatting met het oog bij 0.1.a (rond de , en zo’n per rondje) zat er dicht bij. Een regressielijn is geen mysterieuze machine — je oog deed feitelijk hetzelfde wat de formule doet, alleen ruwer. Aandacht is wat erbij komt, niet wat het leven dragend houdt.
WaarschuwingTrek de lijn niet verder door dan je data
Hier mag je gewoon lezen als de slaaprust die de lijn voorspelt voor een sjacherijn die nul rondjes doet: de das ís zo’n dier (zelf zit hij op ), dus ligt in je data. Dat is lang niet altijd zo. Ligt buiten je data (bij lengte in centimeters is niemand ), dan is alleen het punt waar de lijn de y-as snijdt — gebruik hem voor de lijn, maar zeg niets over .
Hetzelfde geldt aan de andere kant. Trek de lijn door naar rondjes en hij voorspelt : meer slaaprust dan de schaal van tot toelaat. Een lijn geldt waar je data liggen; daarbuiten gok je.
0.3 Hoe goed werkt onze lijn? — DATA = FIT + RESIDU
We hebben een lijn: . Maar hoe goed past die lijn? Voor elk diertje kunnen we drie getallen naast elkaar leggen:
DATA () — wat we werkelijk gemeten hebben (de slaap_rust uit de tabel)
FIT () — wat het model voorspelt voor dit dier (uit de formule)
RESIDU () — wat het model voor dit dier niet snapt
Het is een heel eenvoudige optelling: DATA = FIT + RESIDU. Letterlijk:
Wat het model snapt komt in de FIT, wat het niet snapt blijft achter in het RESIDU. Voor onze negen sjacherijns:
# Het dollarteken zet een nieuwe kolom bij de data.sjacherijns$fit <-32+7* sjacherijns$rondjes # b0 + b1 * Xsjacherijns$residu <- sjacherijns$slaap_rust - sjacherijns$fit# De komma in [ , ... ] betekent: alle rijen, deze kolommen.sjacherijns[, c("sjacherijn", "rondjes", "slaap_rust", "fit", "residu")]
# Lees |> als "en dan": neem sjacherijns, en dan mutate().# mutate() zet kolommen erbij en geeft de hele tabel terug. Binnen dezelfde# mutate() mag residu al leunen op fit, dat een regel eerder ontstaat.sjacherijns <- sjacherijns |>mutate(fit =32+7* rondjes, # b0 + b1 * Xresidu = slaap_rust - fit)# select() kiest de kolommen die je wilt zien, bij hun kale naam.sjacherijns |>select(sjacherijn, rondjes, slaap_rust, fit, residu)
d) Tel alle residuen bij elkaar op. Wat krijg je? Waarom?
OpgeletAntwoord 0.3.a — open na je eigen poging
a) Das: . Residu . Het model voorspelt iets hoger dan de echte slaap_rust van de das.
b) Muis: . Residu . De muis slaapt nét rustiger dan het model voorspelt.
c) Bunzing: . Residu . Ook bij de bunzing zit het model nét eronder.
d) .
Niet toevallig: de regressielijn wordt zo gekozen dat de residuen optellen tot nul. Het is een eigenschap van de kleinste-kwadraten-fit: de residuen zijn gebalanceerd rond nul. Anders zou je de lijn nog kunnen verschuiven.
Drie kwadratensommen — , ,
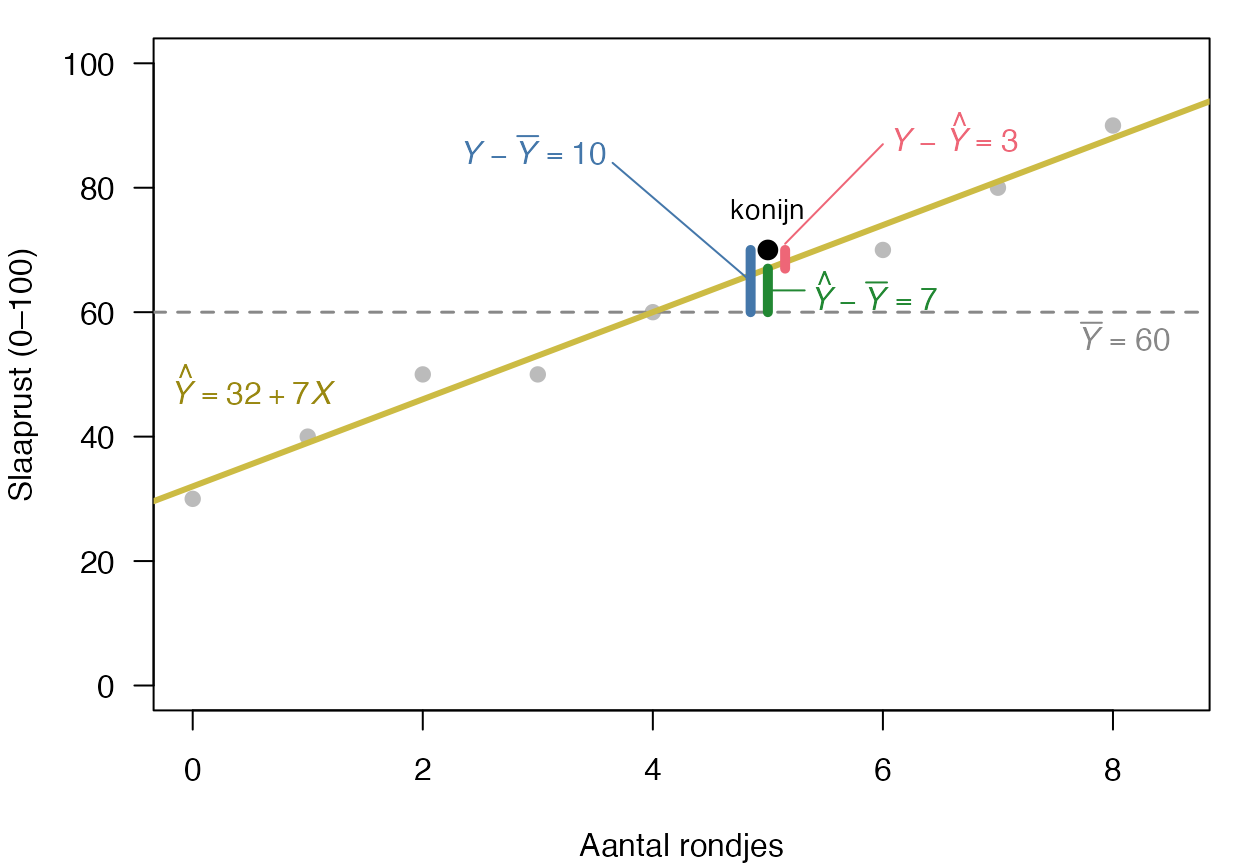
Stel dat je het aantal rondjes niet kende. Dan was je beste gok voor elk diertje gewoon het gemiddelde, : een platte streep door de wolk. Elk diertje wijkt van die streep af, en die afwijking valt in twee stukken uiteen — wat de lijn ervan verklaart, en wat overblijft:
Toon code (tekening van de drie stukjes)
par(mar =c(4, 4, 1, 1))# Dezelfde y-as van 0 tot 100 als de scatter in 0.1, zodat je de twee naast elkaar kunt leggen.plot(X, Y, xlim =c(0, 8.5), ylim =c(0, 100),xlab ="Aantal rondjes", ylab ="Slaaprust (0–100)",pch =19, col ="#BBBBBB", las =1)abline(h =mean(Y), col = col_ybar, lty =2, lwd =1.5)abline(a = b0, b = b1, col = col_line, lwd =3)text(8.5, mean(Y) -4, bquote(bar(italic(Y)) == .(mean(Y))), col = col_ybar, adj =1)text(1.2, b0 +7*1.2+8, bquote(hat(italic(Y)) == .(b0) + .(b1) *italic(X)),col ="#998811", adj =1, font =2)# Drie verticale streepjes naast elkaar, zodat ze niet over elkaar vallen.xk <- X[k]; sh <-0.15segments(xk - sh, mean(Y), xk - sh, Y[k], col = col_total, lwd =5)segments(xk, mean(Y), xk, Yhat[k], col = col_model, lwd =5)segments(xk + sh, Yhat[k], xk + sh, Y[k], col = col_error, lwd =5)# Y en X staan cursief, zoals elk Latijns symbool voor een grootheid. Elk label# staat op een lege plek: blauw linksboven en rood rechtsboven, elk met een dun# streepje naar zijn eigen stuk; groen rechts, tussen de stippellijn en de gele# lijn, op de hoogte van zijn eigen streep, ook met een streepje, dat onder het# rode stuk door naar de groene streep loopt.segments(xk - sh, mean(Y) + k_tot /2, 3.65, 84, col = col_total, lwd =1)text(3.6, 86, bquote(italic(Y) -bar(italic(Y)) == .(k_tot)),col = col_total, adj =1, font =2)segments(xk +0.04, mean(Y) + k_mod /2, xk +0.32, mean(Y) + k_mod /2,col = col_model, lwd =1)text(xk +0.35, mean(Y) + k_mod /2, bquote(hat(italic(Y)) -bar(italic(Y)) == .(k_mod)),col = col_model, adj =0, font =2)segments(xk + sh, Y[k] +1, xk + sh +0.85, 87, col = col_error, lwd =1)text(xk + sh +0.9, 89, bquote(italic(Y) -hat(italic(Y)) == .(k_res)),col = col_error, adj =0, font =2)points(xk, Y[k], pch =19, col ="black", cex =1.3)text(xk, Y[k] +5, "konijn", adj =c(0.5, 0), cex =0.9)
Figuur 2: Het konijn (, ) in drie stukjes. De blauwe streep loopt van de grijze stippellijn (het gemiddelde, ) omhoog tot het konijn: . Ernaast staan twee strepen die op elkaar aansluiten. De groene loopt van het gemiddelde tot de gele regressielijn, : dat stuk verklaart de lijn. De rode begint waar de groene ophoudt en loopt van de lijn tot het konijn, : dat stuk blijft over. Groen en rood samen reiken precies zo hoog als blauw: . De grijze stippen zijn de andere acht sjacherijns.
Kijk ook even waar de gele lijn de grijze stippellijn kruist: precies bij . Dat is het punt , waar de lijn altijd doorheen loopt.
De optelling klopt voor elk dier, ook als een stukje negatief is. Maar we willen niet één dier, we willen alle negen tegelijk. En dan tellen we niet de afstanden op, maar hun kwadraten — anders heffen plussen en minnen elkaar op, zoals bij de residuen hierboven:
En tussen die drie zit een prachtige decompositie:
In woorden: de totale variatie in valt netjes uiteen in een deel dat het model verklaart () en een deel dat het niet verklaart (). Dat is DATA = FIT + RESIDU op variantie-niveau.
OpmerkingVraag 0.3.b — Pen-en-papier (de drie kwadratensommen uitrekenen)
Voor onze sjacherijns met :
a) Bereken . (Tip: wordt . Kwadrateer en tel op.)
b) Bereken met de residuen uit vraag 0.3.a: .
c) Bereken via de decompositie: .
d) Check ook direct met . (De fits zijn .) Klopt het?
OpgeletAntwoord 0.3.b — open na je eigen poging
a) .
b) .
c) .
d) . Kwadrateren en tellen: . ✓ Identiek.
Inzicht. De decompositie is een boekhoudkundige eigenschap van de kleinste-kwadraten-fit. Geen verlies, geen winst — alle variatie in verdeelt zich exact over wat het model verklaart en wat het overlaat. Klopt het bij jou niet? Dan zit er ergens een rekenfout in jouw blokje, niet in de theorie.
En zo zien die drie sommen eruit als oppervlakken:
Toon code (tekening van de drie vierkanten)
# De zijde van elk vierkant is de wortel uit zijn kwadratensom, dus het# oppervlak ís de kwadratensom.sT <-sqrt(SS_T); sM <-sqrt(SS_M); sE <-sqrt(SS_E)tussen <-9# ruimte voor "=" en "+"x_m <- sT +2* tussen # waar het groene vierkant begintx_e <- x_m + sM +2* tussen # waar het rode vierkant begintpar(mar =c(0, 0, 0, 0))plot(NA, xlim =c(0, x_e + sE +22), ylim =c(-2, sT +2),asp =1, axes =FALSE, xlab ="", ylab ="")# Alle drie de vierkanten op dezelfde middellijn als het "=" en het "+", zodat# het kleine rode vierkant leest als de derde term van de som.mid <- sT /2rect(0, mid - sT /2, sT, mid + sT /2, col = col_total, border =NA)text(sT /2, mid, bquote(italic(SS)[T] == .(SS_T)), col ="white", font =2)text(sT + tussen, mid, "=", cex =2.5)rect(x_m, mid - sM /2, x_m + sM, mid + sM /2, col = col_model, border =NA)text(x_m + sM /2, mid, bquote(italic(SS)[M] == .(SS_M)), col ="white", font =2)text(x_m + sM + tussen, mid, "+", cex =2.5)rect(x_e, mid - sE /2, x_e + sE, mid + sE /2, col = col_error, border =NA)# Het rode vierkant is te klein voor zijn eigen label: dat staat erboven.text(x_e + sE /2, mid + sE /2+6, bquote(italic(SS)[E] == .(SS_E)), col = col_error, font =2)
Figuur 3: De kwadratensommen als oppervlakken: de zijde van elk vierkant is de wortel uit zijn kwadratensom. Het blauwe vierkant () is precies even groot als het groene () en het rode () samen. Het rode vierkantje rechts, zeven keer zo klein van zijde als het blauwe, is de derde term: wat de lijn niet verklaart.
— proportie verklaarde variantie
Dan komt er bijna vanzelf. Het is de fractie van de totale variantie die het model verklaart:
Je ziet hem ook geschreven als : hetzelfde getal, want .
Er is nog een tweede weg naar hetzelfde getal: kwadrateer de correlatie tussen en . hieronder is de somrij van de kolom uit 0.2.a, en dat is hetzelfde getal als . (Ken je als covariantie gedeeld door de twee standaardafwijkingen, ? Dat is dezelfde breuk, alleen met de sommen zelf: de deling door zit boven én onder, en valt weg.)
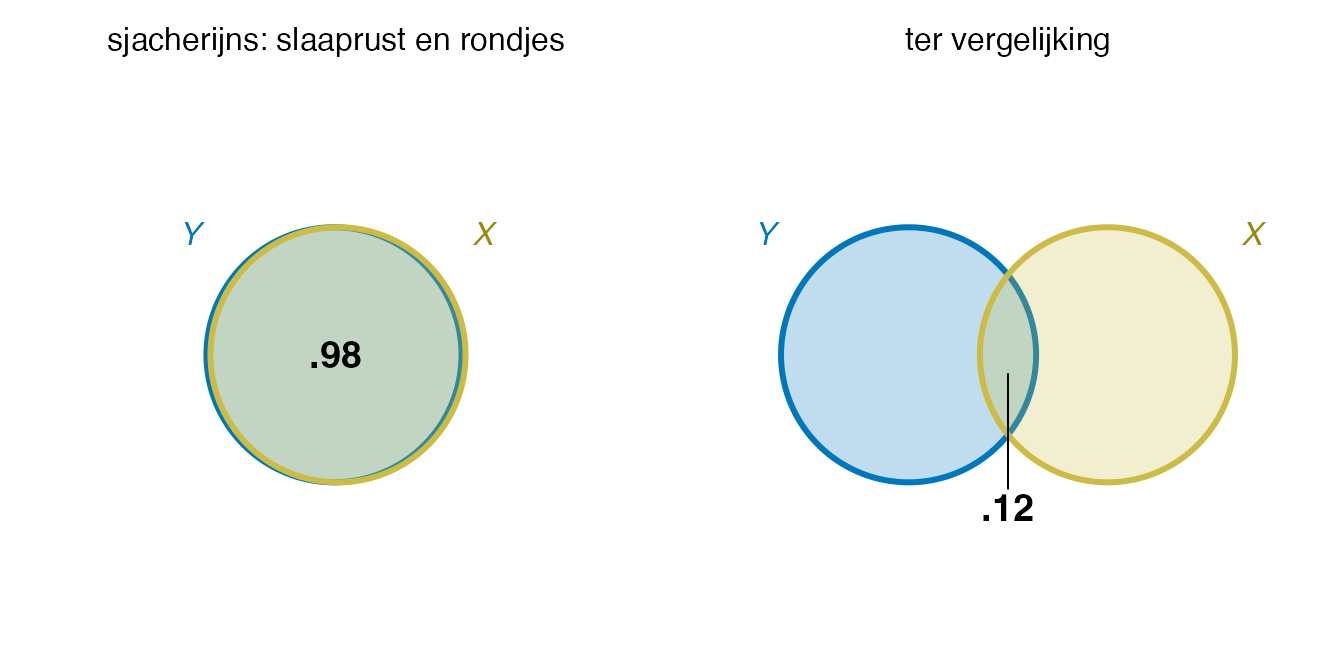
Twee wegen, één getal. Bij één voorspeller zijn “welk deel van de variantie verklaart de lijn” en “de correlatie in het kwadraat” hetzelfde. En als twee cirkels, één voor en één voor :
Toon code (tekening van de twee cirkels)
# Twee cirkels met straal 1 die elkaar overlappen voor een aandeel r2 van hun# oppervlak. De afstand d tussen de middelpunten volgt uit de oppervlakte van# de lens waarin ze overlappen.lens <-function(d) 2*acos(d /2) - (d /2) *sqrt(4- d^2)venn2 <-function(r2, titel) { d <-uniroot(function(d) lens(d) / pi - r2, c(0, 2))$root hoek <-seq(0, 2* pi, length.out =400)plot.new()plot.window(xlim =c(-2.3, 2.3), ylim =c(-1.35, 1.35), asp =1)polygon(-d /2+cos(hoek), sin(hoek), col =adjustcolor("#0077BB", 0.25),border ="#0077BB", lwd =3)polygon( d /2+cos(hoek), sin(hoek), col =adjustcolor("#CCBB44", 0.25),border ="#CCBB44", lwd =3)# Past het getal niet in de overlap, dan staat het eronder, met een streepje# naar de overlap toe.if (r2 > .5) {text(0, 0, zonder0(r2), font =2, cex =1.2) } else {segments(0, -0.15, 0, -1.05, lwd =1)text(0, -1.2, zonder0(r2), font =2, cex =1.2) }text(-d /2-1.05, 0.95, quote(italic(Y)), col ="#0077BB", font =2, adj =1)text( d /2+1.05, 0.95, quote(italic(X)), col ="#998811", font =2, adj =0)title(main = titel, font.main =1, cex.main =1)}par(mfrow =c(1, 2), mar =c(0.5, 0.5, 2, 0.5))venn2(r2_sj, "sjacherijns: slaaprust en rondjes")venn2(r2_ter, "ter vergelijking")
Figuur 4: als overlap van twee cirkels: links de sjacherijns, rechts ter vergelijking een model dat weinig verklaart. Elke cirkel is op 1 gezet, want het gaat hier om aandelen en niet om de kwadratensommen van de vierkanten. Rechts overlappen de cirkels voor .12 en ligt het meeste erbuiten. Links overlappen ze voor .98: ze vallen bijna samen, en buiten de overlap blijft alleen een smal randje van .02 over.
Oftewel: van de variantie in slaaprust valt samen met variantie in rondjes. De overige is wat het model overlaat — wat de bunzing rustiger maakt dan zijn fit voorspelt, wat de egel onrustiger maakt dan zijn fit voorspelt, enzovoort. Over oorzaak zegt het niets: alleen dat ze samen variëren.
Tip is de hoofdmaat, niet of
In de hoofdstukken hierna kom je nog veel toets-statistieken tegen (, , , ). Die zeggen iets over of het effect significant van nul afwijkt. Maar de vraag hoe goed werkt het model — dat is . Een model met verklaart bijna alles wat er valt te verklaren. Een model met verklaart een sliertje. En dat is een betekenisvol getal, ook zonder dat er een -waarde aan hangt.
In MRA krijgt een correctie voor het aantal voorspellers (adjusted ). In LRA (binair ) bestaat niet in deze vorm en gebruiken we een pseudo-. Maar het basisidee — welk deel van de variantie verklaart het model — komt terug in alle thema’s. DATA = FIT + RESIDU is de spil.
0.4 Toetsen — model als geheel én voorspeller apart
Tot nu toe weten we wat de lijn is ( en ), en hoe goed hij past ( via DATA = FIT + RESIDU). Wat we nog niet weten: of rondjes en slaaprust ook in de populatie samenhangen, en niet alleen bij deze negen. Daarvoor toetsen we.
Er zijn eigenlijk twee vragen die je kunt stellen — en het is goed om die uit elkaar te houden, want straks bij MVDA worden ze écht verschillend:
Vraag
Wat het meet
Toets
Hoe goed werkt de lijn?
fit-kwaliteit van het hele model
,
Wat doet de lijn?
effect-grootte per voorspeller
,
Bij enkelvoudige regressie zijn die twee vragen één en dezelfde — er ís maar één voorspeller, dus hoe goed werkt het model en wat doet deze voorspeller zijn letterlijk dezelfde vraag. Wiskundig: en . Bij MVDA (vanaf thema 1, met meerdere voorspellers tegelijk) lopen ze uit elkaar — het hele model kan iets verklaren terwijl een losse voorspeller niets doet, of omgekeerd.
Toets 1 — -toets op het model als geheel.“Doet het model iets, vergeleken met geen voorspellers?” Vergelijkt de variantie verklaard door het model met de niet-verklaarde variantie, elk gedeeld door zijn vrijheidsgraden:
Vrijheidsgraden — wie zit vast, wie is vrij?
OpmerkingVrijheidsgraden zonder formule
Stel: vier sjacherijns, en hun gemiddelde slaaprust is . Drie ken je al: , en . Hoe rustig sliep de vierde?
Geen ontsnappen aan — . Eén getal kan het zijn, en jij rekent het uit: . De vierde zit vast aan wat de eerste drie zijn, gegeven het gemiddelde. Drie zijn vrij; eentje moet de boel weer kloppend maken.
Dat is een vrijheidsgraad in zijn eenvoudigste vorm: hoeveel getallen nog vrij mogen variëren als je een paar dingen al hebt vastgelegd. Bij een gemiddelde van getallen ligt er één ding vast, dus zijn er vrij.
Bij een regressielijn liggen er twee dingen vast. Het eerste ken je uit vraag 0.3.a: de residuen tellen samen op tot nul. Het tweede: de residuen hangen niet samen met — anders kon de lijn nog een tikje kantelen en kwam hij dichter bij de punten. Twee voorwaarden, dus van de negen residuen volgen er twee uit de andere zeven. Voor de sjacherijns, met :
— zoveel residuen zijn vrij;
— het model heeft één helling, voor één voorspeller;
— net als bij het gemiddelde.
Check: , dus . ✓ — altijd. Met meer voorspellers liggen er meer dingen vast; hoe dat gaat, zie je in thema 1.
Deel je een kwadratensom door zijn vrijheidsgraden, dan krijg je een gemiddeld kwadraatmean square, : en . Die twee delingen stonden al in de formule voor hierboven.
De sudoku — een halve ANOVA-tabel aanvullen
Wie dit eens met de hand heeft gedaan, leest een ANOVA-tabel daarna als een sudoku: ontbreken er een paar getallen, dan reken je ze terug. Alles volgt uit twee optellingen (, ) en twee delingen (, ).
OpmerkingVraag 0.4.a — De sudoku
Vul de lege cellen in deze ANOVA-tabel met de hand. Je hoeft niets te schatten, alleen terug te rekenen.
Sudoku: de ANOVA-tabel van slaaprust op rondjes, met lege cellen
Bron
SS
df
MS
F
Model
2940
Error
7
8.57
—
Totaal
3000
8
—
—
Note. Negen sjacherijns. SS = kwadratensom, df = vrijheidsgraden, MS = gemiddeld kwadraat (SS/df). Een lege cel vul je zelf in; een — blijft leeg.
OpgeletAntwoord 0.4.a — open na je eigen poging
De ANOVA-tabel van slaaprust op rondjes, ingevuld
Bron
SS
df
MS
F
Model
2940
1
2940.00
343.00
Error
60
7
8.57
—
Totaal
3000
8
—
—
Note. Negen sjacherijns. SS = kwadratensom, df = vrijheidsgraden, MS = gemiddeld kwadraat (SS/df). Een — blijft in een ANOVA-tabel leeg.
. . . En dan .
Kwam je op en niet op ? Dan rekende je goed. De in de tabel is afgerond; met de onafgeronde komt er precies uit. Vier optellingen en delingen, meer niet.
Wat zegt die eigenlijk? — de bakker
Aan het einde van de straat zit een bakker. Al jaren. Je weet wat je krijgt: croissantjes, een bruin brood, een kruimelvlaai op zaterdag. Op een dag loop je naar binnen — en in het midden van de winkel staat een fiets. Een echte. Met bel. Niks geen brood, alleen een fiets.
Eerste gedachte: hij is geen bakker meer. Niet omdat een bakker geen fiets in zijn zaak mag hebben — dat mag van mij — maar omdat het zo schreeuwend onwaarschijnlijk is dat een bakker daar een fiets neerzet. Iets klopt niet. Iets is veránderd.
Dat is precies wat een toets is. Je hebt een nulhypothese : “er is niks aan de hand, de bakker is nog gewoon bakker.” Bij de sjacherijns is dat: in de populatie van sjacherijns hangt het aantal rondjes niet samen met de slaaprust, . Het sterretje betekent: in de populatie. Over valt niets te toetsen, dat lees je gewoon af; de toets gaat over alle sjacherijns die je níét hebt gezien.
Dan loop je de winkel binnen (= je trekt een steekproef), en je rekent uit hoe gek wat je ziet zou zijn als de bakker écht nog bakker was. Dat hoe-gek-getal heet de -waarde: de kans op iets dat minstens zo extreem is als wat jij vond, gegeven dat klopt. Die kans rekent R voor je uit; je ziet hem zo meteen in de uitvoer.
Voor de sjacherijns is , en de -waarde is kleiner dan . Een van is geen croissantje meer, dat is een fiets. Dus verwerpen we de nulhypothese dat het aantal rondjes in de populatie niet samenhangt met de slaaprust, en gaan we ervan uit dat het aantal rondjes in de populatie wél samenhangt met de slaaprust (). Bewezen is dat niet — een bakker kán een fiets neerzetten — maar het is te gek om de nulhypothese nog te geloven.
WaarschuwingWat de bakker je leert over
gaat altijd over de populatie, nooit over je steekproef. “De bakker is nog gewoon bakker” gaat over de winkel zelf, niet over dat ene bezoek waarbij jij die fiets zag. Bij de sjacherijns: over alle sjacherijns, niet over deze negen.
De toets gelooft eerst . Hij rekent uit: gegeven dat klopt, hoe verrassend is wat ik vond? Niet andersom: de -waarde is niet de kans dat waar is.
Een rijmpje voor onder de douche:“When is low, must go.” Lage ( is de gangbare grens): de nulhypothese wegtrappen. Hoge : je kunt de nulhypothese niet wegtrappen, en dan blijft de nulhypothese voorlopig staan — niet bewezen, alleen niet weerlegd.
Een toets kan zich op twee manieren vergissen. Je roept “geen bakker meer!” terwijl hij gewoon bakker is, en die fiets was toeval: vals alarm, een type-1-fout ( verworpen terwijl klopt). Of de bakker ís gestopt, maar jij liep binnen op de dag dat er toevallig nog croissantjes lagen: gemist alarm, een type-2-fout ( laten staan terwijl er wél iets veranderd is). Hoeveel valse alarmen je op den duur accepteert, kies je vooraf zelf: dat is , dezelfde als de grens hierboven. De kans dat je een echte verandering wél opmerkt, heet power; hoe vaker je binnenloopt, hoe groter die kans.
De -toets, en R rekent mee
Toets 2 — -toets op de voorspeller-coëfficiënt.“Wijkt van nul af?” Vergelijkt de coëfficiënt met zijn standaardfout:
R doet beide toetsen in één keer. summary() geeft de coëfficiënten met hun -toets en onderaan de -toets; anova() geeft de ANOVA-tabel van je sudoku.
Het is een flinke lap uitvoer. Zoek er deze vijf dingen in:
(Intercept) onder Estimate = , en rondjes = ;
Multiple R-squared = , je ;
F-statistic = op en vrijheidsgraden;
in anova(): Sum Sq bij rondjes en bij Residuals — dezelfde getallen als in je sudoku;
de -waarde van de bakker, twee keer: achter rondjes in de kolom Pr(>|t|), en onderaan achter p-value. Waarom dat hetzelfde getal is, vraagt 0.4.b.
summary(m_sj)
Call:
lm(formula = slaap_rust ~ rondjes, data = sjacherijns)

Residuals:
   Min     1Q Median     3Q    Max
    -4     -2      0      2      4

Coefficients:
            Estimate Std. Error t value    Pr(>|t|)
(Intercept)   32.000      1.800   17.78 0.000000439 ***
rondjes        7.000      0.378   18.52 0.000000332 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 2.928 on 7 degrees of freedom
Multiple R-squared:   0.98, Adjusted R-squared:  0.9771
F-statistic:   343 on 1 and 7 DF,  p-value: 0.0000003319
anova(m_sj)
Analysis of Variance Table

Response: slaap_rust
          Df Sum Sq Mean Sq F value       Pr(>F)
rondjes    1   2940 2940.00     343 0.0000003319 ***
Residuals  7     60    8.57
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
OpmerkingVraag 0.4.b — Pen-en-papier (en R)
a) Lees uit de R-output: wat is de -waarde van het model? En wat is de -waarde van rondjes?
b) Bereken . Klopt dat met ?
c) Wat zijn de -waardes van beide toetsen? Verschillen ze?
d) Verklaar in één zin waarom dit zo is bij enkelvoudige regressie.
OpgeletAntwoord 0.4.b — open na je eigen poging
a) op , . voor rondjes (dat is ).
b) Met de afgeronde : . Dat is op het afronden na; met de onafgeronde uit R komt er precies uit. ✓ Gelijk aan .
c) Beide . Identiek (de R-output geeft voor allebei hetzelfde getal).
d) Bij enkelvoudige regressie is de enige voorspeller in het model dezelfde coëfficiënt waar de -toets op slaat. “Doet het model iets?” en “Doet deze ene voorspeller iets?” zijn letterlijk dezelfde vraag, alleen anders geformuleerd. Wiskundig: wanneer . Het maakt geen ruk uit welke toets je rapporteert — kies wat past bij de uitleg.
TipOnthouden — bij één voorspeller zijn en broers
Toets
Wat hij toetst
Bij enkelvoudige regressie
model als geheel
van de helling
voorspeller-coëfficiënt
Pas in MVDA (vanaf thema 1) — als er meerdere voorspellers tegelijk in het model zitten — gaan deze twee niet meer dezelfde vraag stellen. Het model-als-geheel () kan significant zijn terwijl geen enkele losse voorspeller dat is, en omgekeerd kan een losse voorspeller significant zijn terwijl het model-als-geheel niets oplevert. Dat is de hele crux van multipele regressie.
0.5 , en — dezelfde verhouding in andere kleren
Drie getallen die allemaal iets zeggen over hoe rondjes en slaaprust samen bewegen: de helling , de correlatie , en het gestandaardiseerde gewicht . Het laatste rekent in standaardafwijkingen, en daarvoor eerst even dit.
OpmerkingEven terug: de z-score
Een z-score is het aantal standaardafwijkingen dat een ruwe waarde van het gemiddelde af ligt. Zie de standaardafwijking als een lineaaltje. Een IQ van , bij een gemiddelde van en een standaardafwijking van : tussen en past het lineaaltje van punten precies twee keer. Dus .
Een z-score is een telling — hoe vaak het lineaaltje past — en geen kans. Over de vorm van de verdeling zegt hij niets. Gestandaardiseerd betekent hieronder: en allebei gemeten in hun eigen lineaaltje.
Voor de sjacherijns hebben we:
(helling in ruwe eenheden: slaaprust per rondje)
(correlatie, zonder eenheid)
(gestandaardiseerde helling)
Eerst de twee lineaaltjes, de standaardafwijkingen van en van :
Tussen en zit de verhouding van die twee:
(Ken je als covariantie gedeeld door variantie, ? Dat is dezelfde breuk als : de boven en onder valt weg.)
En de gestandaardiseerde helling: zet om in lineaaltjes, met precies de omgekeerde verhouding:
Waarom dat precies is: vul voor de regel erboven in, . De twee verhoudingen vallen tegen elkaar weg, en blijft over.
Dus: in enkelvoudige regressie. Dezelfde grootheid — alleen herschaald naar standaardafwijkingen. Eén rondje meer is punten slaaprust meer; één lineaaltje rondjes meer is lineaaltje slaaprust meer.
OpmerkingSteekproef en populatie — twee gezichten van elk getal
Elk getal hierboven heeft een broer in de populatie. Wat je uit je steekproef uitrekent, krijgt meestal een Latijnse letter; wat je over de populatie wilt weten, meestal een Griekse. Het steekproefgetal is je schatting van het populatiegetal.
Wat het is
Steekproef
Populatie
Gemiddelde
Standaardafwijking
Pearson-correlatie
Verklaarde variantie
Regressiecoëfficiënt (ruw)
Regressiecoëfficiënt (gestandaardiseerd)
De twee onderste rijen breken de regel. De populatie krijgt daar geen Griekse letter maar een sterretje — dat van de bakker, . En is in dit oefenboek een steekproefgetal, zoals hierboven. Andere boeken gebruiken juist voor de populatie; kom je ergens anders tegen, kijk dan eerst welke van de twee dat boek bedoelt.
Bij meer dan één voorspeller houdt de gelijkheid op. Waarom, en waarom dat de reden is dat er meervoudige regressie bestaat, lees je aan het begin van thema 1.
0.6 Waarom MVDA straks anders wordt
Bij enkelvoudige regressie is er één en één . Eén vraag, eén lijn, één . Het maakt niet uit of je of rapporteert — ze zeggen hetzelfde.
Bij meervoudige regressie (MRA, thema 1) komen er meerdere -en bij. Het model wordt:
Nu kun je drie verschillende vragen stellen die niet meer dezelfde zijn:
Model als geheel — “Verklaart het geheel van voorspellers iets?” — overall -toets.
Voorspeller apart — “Wat doet deze ene voorspeller, gecontroleerd voor de andere?” — -toets per coëfficiënt.
Klopt het allemaal — “Houden de aannames stand?” — assumpties checken (lineariteit, gelijke spreiding, normaliteit, geen multicollineariteit, geen invloedrijke outliers).
Vanaf thema 1 doe je deze drie altijd in deze volgorde. Het 3-stappen-plan noemen we het: Model — Voorspellers — Assumpties. Dat is jouw werkstroom voor MRA, ANCOVA, MANOVA, RMA — overal waar meerdere voorspellers tegelijk in het spel zijn.
TipWaar gaat het bij MVDA over?
Bij enkelvoudig
Bij MVDA
Eén verklaart iets van
Meerdere -en delen samen iets te zeggen over
en zijn dezelfde toets
en -per-coëfficiënt zeggen verschillende dingen
en zeggen verschillende dingen
Geen partial-effecten
Wel partial-effecten (effect van op na controle voor )
Geen multicollineariteit
Wel: voorspellers kunnen op elkaar lijken
Eén lijn in twee dimensies
Een vlak (of een hyper-vlak) in meer dimensies
Vanaf thema 1 wordt elk van deze elementen één voor één behandeld. Hier in 0 alleen de pure-enkelvoudige-vorm als ankerpunt.
0.7 Wat hierna komt — kort overzicht van zeven thema’s
#
Techniek
Wanneer
Dier
1
MRA — multipele regressie
interval, meerdere -en (interval)
eekhoorn + mier
2
ANOVA — variantie-analyse
interval, -en nominaal (factoren)
mol
3
ANCOVA
interval, mengvorm nominaal + interval
bever
4
LRA — logistische regressie
binair (wel/niet)
pad
5
MANOVA — multivariate ANOVA
meerdere -en tegelijk, nominaal
leeuw
6
RMA — repeated measures
herhaald gemeten op zelfde individu
kameleon
7
Mediation — indirecte effecten
, pad via tussenliggende variabele
slak
Bij elk thema doorloop je dezelfde drie stappen: model — voorspellers — assumpties. Bij elk thema heb je een dier dat het verhaal draagt. En bij elk thema krijg je weinig theorie vooraf — eerst aan de slag, theorie wanneer het aankomt.
Sjonge sjonge. Daar gaan we dan. Veel succes.
OpmerkingWanneer terugkomen naar dit opfris-hoofdstuk