herkennen wanneer meervoudige regressie de juiste techniek is;
de -toets van het hele model en de -toets per voorspeller lezen en rapporteren, met de nulhypothese over de populatie (; de ster betekent: in de populatie);
uit een halve ANOVA-tabel de rest terugrekenen (, , , en ), en adjusted uitrekenen;
de regressievergelijking opschrijven, elke uitleggen voor dieren die op de andere voorspellers gelijk zijn, en met de hand een voorspelde uitrekenen;
de verklaarde variantie in verdelen in wat elke voorspeller uniek bijdraagt (de gekwadrateerde semipartiële correlatie) en wat de voorspellers delen, en dat tekenen in een Venn-diagram (bij twee voorspellers drie cirkels: , en ); en suppressie herkennen, waarbij dat gedeelde stuk zelfs negatief kan zijn (de uitleg staat onder Unieke VAF handmatig, bij Suppressie — waarom het gedeelde stuk negatief kan worden);
de aannames nagaan in de residuplot en de Q-Q-plot;
uitschieters opsporen met drie maten, elk met een grens:
gestandaardiseerd residu: groter dan of kleiner dan ;
leverage: boven , met het aantal voorspellers;
Cook’s distance: boven ;
multicollineariteit beoordelen met de VIF (grens ) of de tolerance (grens );
het model opnieuw schatten: zonder een invloedrijk geval, of nadat je niet-significante voorspellers één voor één hebt weggelaten;
in een hiërarchische regressie twee modellen vergelijken ( en de -toets op die toename);
een categorische voorspeller als dummy’s in het model zetten. In thema 2 kom je dat weer tegen; het staat hier al omdat het bij regressie hoort.
In R doe je dat met lm(), summary(), vif() (pakket car), rstandard(), hatvalues(), cooks.distance(), plot(model, which = 1) en plot(model, which = 2), ols_correlations() (pakket olsrr) en anova(m1, m2).
Thema 0 hoort erbij — enkelvoudige regressie met de hand: punt 2, 3 en 5 rusten erop.
Eén ding hoort er ook bij, al oefent dit hoofdstuk het niet: een kwadratische term () als stap in een hiërarchische regressie. Onder Wat blijft liggen, onderaan, staat kort wat het is.
Wat dichtgeklapt staat onder Voor wie verder wil, hoort niet bij dit lijstje.
Wat je uit thema 0 meeneemt
Dit thema bouwt op thema 0, de opfris van enkelvoudige regressie met de negen sjacherijns. Vijf dingen komen hier zonder nieuwe uitleg terug:
en , en DATA = FIT + RESIDU;
de drie kwadratensommen, , en ;
vrijheidsgraden, en een halve ANOVA-tabel aanvullen (thema 0, onder De sudoku);
de nulhypothese gaat over de populatie, , en de -waarde zegt hoe gek je uitkomst zou zijn als de nulhypothese klopt (thema 0, onder de bakker);
bij één voorspeller is , en is het gestandaardiseerde gewicht gelijk aan de correlatie .
Staat een van de vijf niet meer, lees dan eerst dat stuk van thema 0. Het laatste punt is waar dit thema begint.
BelangrijkWaarom dit thema bestaat — en waarom ruw ruk is
In thema 0 was het gestandaardiseerde gewicht gelijk aan de correlatie, : bij één voorspeller zijn ze hetzelfde getal. Zodra er een tweede voorspeller bij komt die met de eerste samenhangt, breekt die gelijkheid. Dan zegt nog steeds hoe sterk en samen variëren, maar zegt wat aan toevoegt als de andere voorspellers al meedoen. Bij de bosdieren van dit thema, die straks hun notenoogst voorspeld krijgen uit denkkunst, leeftijd en zelfgevoel, scheelt dat flink. Leeftijd hangt in zijn eentje nauwelijks samen met de notenoogst (), maar met denkkunst en zelfgevoel erbij is : groter, niet kleiner. Dat kan; waarom, lees je onder Suppressie — waarom het gedeelde stuk negatief kan worden. Dat verschil tussen en is waar dit thema over gaat.
De gewone helling rekent net zo goed met de andere voorspellers mee, maar telt in zijn eigen eenheid. En een ruw getal zegt niets zolang je zijn lineaaltje niet kent. Straks zie je een helling van noten per punt denkkunst en een van noten per levensjaar. Weegt leeftijd dan zwaarder? Weet je niet: punten en jaren zijn verschillende lineaaltjes. Wie wil vergelijken, standaardiseert eerst, en dan draait het om: voor denkkunst tegen voor leeftijd. Ruw is Ruk. (Hoe je van naar rekent, staat verderop onder Concept — versus ; de standaardafwijkingen die je daarvoor nodig hebt, staan bij T4.)
Het verhaal van dit thema
“Mier,” zei de eekhoorn, “kun je voorspellen hoeveel noten een dier oogst?”
De mier dacht na. “Op grond van wat?”
“Op grond van hoe slim hij denkt te zijn. En zijn leeftijd. En of hij van zichzelf vindt dat hij wel meetelt.”
De mier keek naar het lijstje. Vierenzeventig dieren, vierenzeventig regeltjes, en bij elk regeltje vier getallen. “Misschien,” zei de mier. “Maar dan moeten we gaan rekenen.”
Wat de mier berekent heet multiple regression analysisMRA, en je stelt elke keer dezelfde drie vragen aan je gegevens:
Voorspelt het samen überhaupt iets? — de -toets F-test op het hele model, met als hoeveel-zegt-het.
Wie van de voorspellers predictors draagt nog bij als de anderen al meedoen? — de -toetsen per coëfficiënt, met de semipartiële correlatie semipartial correlation als hoeveel-zegt-juist-deze.
Klopt het allemaal wel? — de aannames assumptions: onafhankelijkheid van observatiesindependence of observations (geen herhaalde metingen op hetzelfde dier in dit model, geen geclusterde data), lineariteit, gelijke spreiding homoscedasticity, normaal verdeelde foutjes normally distributed residuals, geen voorspellers die op elkaar lijken multicollinearity, geen raar dier dat het model in zijn eentje stuurt influential outlier.
OpmerkingHoe dit hoofdstuk leest
Bij elke serieuze stap zie je twee blokken naast elkaar: de algemene vorm (de abstracte statistiek-zin, met Y, X1, mijn_data) en daarna voor onze dieren (dezelfde zin, in onze concrete bos-wereld). Wie die twee blokken naast elkaar leert lezen, leert eigenlijk waar dit hele oefenboek om draait: hoe een statistisch idee zijn vorm krijgt in échte gegevens.
OpmerkingDrie symbolen voor regressiecoëfficiënten
In dit oefenboek zie je drie verwante symbolen:
— het werkelijke effect van op in de populatie. Onbekend; dit is wat we willen weten.
— de schatting van op basis van je steekproef. Wat summary(lm) je geeft in de kolom Estimate. Hangt af van de meeteenheden van en .
— de gestandaardiseerde versie van : hetzelfde effect, maar uitgedrukt in standaarddeviaties. Daardoor vergelijkbaar tussen voorspellers, ongeacht hun oorspronkelijke meeteenheden.
In hypothese-toetsen praten we altijd over de populatie — dus daar staat altijd : , “in de populatie heeft géén effect.”
Voor correlaties bestaat de compacte vorm ; wij schrijven de variabele-namen uit () zodat de notatie zichzelf uitlegt.
OpmerkingCode in dit hoofdstuk — wat moet je kunnen typen?
Code is standaard open als je hem zelf moet kunnen typen: lm(), summary(), vif(), plot(model, which = 1/2), rstandard(), hatvalues(), cooks.distance(), ols_correlations(), anova(m1, m2). Code die alleen ter illustratie dient — simulaties, Venn-tekeningen — staat ingeklapt met een knopje “Toon code”. Klap hem open als je nieuwsgierig bent.
Het R-spiekblad bij MRA onderaan dit hoofdstuk is gemaakt om te printen: daar staat alle code die je nodig hebt, op één blad. Reken er alleen niet op dat je alles kunt opzoeken; wat je vaak nodig hebt, moet je ook zonder blad kunnen typen.
TipVuistregels zijn afspraken, geen wetten
Met deze drempels rekent dit oefenboek: , Cook’s distance , leverage , , . Handboeken kiezen soms iets andere getallen ( voor leverage; in strengere kringen; voor Cook’s distance bij grotere ); dat is een keuze, geen natuurwet.
TipObject-altijd-erbij — verschil in wat? In mijn moeder?
Eén taalkundige reflex die je gaat redden, hier en in elk thema hierna. In stat-taal hebben werkwoorden als verschil, effect, samenhang, voorspellen, significant en verklaart een verplicht object: de afhankelijke variabele waar de uitspraak over gaat. In algemeen taalgebruik wordt dat object vaak weggelaten — “geen verschil tussen mannen en vrouwen”, “X heeft effect”, “is significant”. Geen probleem als je al weet waarover het gaat. Wel een probleem als je net begint, of bij ingewikkelde stof waar drie variabelen tegelijk in een zin staan.
Vuistregel:
❌ Onvolledig
✅ Volledig
effect van X
effect van X op Y
verschil tussen groepen
verschil in Y tussen groepen
samenhang met X
samenhang tussen X en Y
X voorspelt
X voorspelt Y
invloed van X
invloed van X op Y
is significant
significant effect op Y / significant verschil in Y
verklaart variantie
verklaart variantie in Y
Symptoom-test. Lees je ergens “vond geen verschil” — vraag dan: verschil in mijn moeder? Nee, in [iets]. Vul dat iets expliciet in. Doet de zin het zonder dat? Dan zit Y er impliciet in. Doet ie het niet? Dan hoort Y er expliciet in.
Spiegel-regel. Een effect van X op Y omgedraaid wordt: verschil in Y door verschillen in X. Niet “verschil door X” — dat zegt niets.
Klein principe, groot rendement. Hou de Y er altijd bij; je dankt jezelf later, vooral als de techniek complexer wordt en de zinnen langer.
Werkmaterialen — R-pakketten en functies
Het keukenkastje van de eekhoorn
Gereedschap
Waar het voor is
Pakket
lm()
Trekt een lijn door een wolk van getallen
base
summary()
Vertelt wat de lijn precies doet (, helling per voorspeller, en )
base
vif()
Vraagt of voorspellers stiekem hetzelfde zeggen
car
hatvalues()
Wijst aan welke dieren ver van het midden staan (leverage)
base
rstandard()
Standaardiseert de afwijkingen van het model
base
cooks.distance()
Vraagt aan elk dier: “als je weg was, hoeveel zou er dan veranderen?”
base
plot(model, which = 1)
Het plaatje van foutjes tegen voorspelde waarden
base
plot(model, which = 2)
De Q-Q-plot voor normaliteit
base
ols_correlations()
Splitst correlaties in zero-order, partial en part
olsrr
anova(m1, m2)
Vergelijkt twee modellen die in elkaar passen
base
OpmerkingVoor wie nieuw is met pakketten
Een pakket is een verzameling extra gereedschap dat niet automatisch in R zit. Je installeert het één keer met install.packages("naam"), en je laadt het elke sessie met library(naam). Daarna kun je de functies eruit gebruiken alsof ze altijd al van jou waren.
Volgorde-regel. Zet alle library()-aanroepen bovenaan je script — vóór elk gebruik van een functie uit dat pakket. Schuif je library(olsrr) per ongeluk onder een ols_correlations()-regel, dan klaagt R “could not find function”. Vervelend, en altijd dezelfde oplossing: pakket boven gebruik.
1.0 Project- en datavoorbereiding
Het werkkamertje staat al klaar
Download de bron van dit oefenboek (de zip op de voorpagina), pak hem uit en dubbelklik op mvda_werkboek.Rproj — één project voor alle thema’s. Open daarna 01_meervoudige_regressie/01_meervoudige_regressie.qmd en draai de code vanuit dat bestand: RStudio voert een chunk uit in de map van het hoofdstuk, dus de paden kloppen. De data van dit thema ligt in 01_meervoudige_regressie/data/, de helper-functies in common/R/. Niets te installeren als de drie pakketten (car, olsrr, tidyverse) op je computer staan; anders één keer install.packages(...).
Open de eerste dataset.
Algemene vorm. Een dataset laden uit een .RData-bestand en even snel inkijken doe je zo:
load("data/jouw_data.RData")str(jouw_data)
load() zet het object dat in het bestand bewaard is direct in je sessie — onder de naam waaronder het ooit is opgeslagen. Met str() zie je in één regel welke kolommen erin zitten, hun type, en de eerste paar waarden.
Voor onze dieren. Het bestand bevat een data frame met de naam bos_dieren.
# Laad het bestand. Het object 'bos_dieren' verschijnt vanzelf.load("data/notenoogst_in_het_bos.RData")# Bekijk structuur, kolommen, types en eerste waarden.str(bos_dieren)
'data.frame':   74 obs. of  4 variables:
 $ notenoogst: num  79.6 88.2 67.8 81.3 56.7 ...
 $ denkkunst : num  106 113 104 113 105 ...
 $ leeftijd  : num  12 12 11 12 11 ...
 $ zelfgevoel: num  37.2 67.8 34.8 59.6 65.6 ...
Per dier vier getallen: hoeveel noten hij dit jaar oogstte (notenoogst), hoe slim hij denkt (denkkunst), hoe oud hij is (leeftijd), en wat hij van zichzelf vindt (zelfgevoel).
Bekijk de class() van elke variabele.
# Eén kolom tegelijk:class(bos_dieren$notenoogst)
[1] "numeric"
# Alle kolommen in één keer: sapply() laat class() op elke kolom los.sapply(bos_dieren, class)
De ~ (tilde) lees je als “voorspeld door”. lm() schat de coëfficiënten, summary() print de uitkomst.
Voor onze dieren.
# Schat het regressiemodel: notenoogst voorspeld door drie eigenschappen.lm_bos <-lm(notenoogst ~ denkkunst + leeftijd + zelfgevoel,data = bos_dieren)# Print de uitkomst: coëfficiënten, t-toetsen, F-toets, R-squared.summary(lm_bos)
Call:
lm(formula = notenoogst ~ denkkunst + leeftijd + zelfgevoel,
    data = bos_dieren)

Residuals:
    Min      1Q  Median      3Q     Max
-35.291  -6.211   1.840   8.471  25.237

Coefficients:
            Estimate Std. Error t value    Pr(>|t|)
(Intercept) -78.1381    17.8838  -4.369 0.000042353 ***
denkkunst     0.7377     0.1346   5.480 0.000000631 ***
leeftijd      3.3578     0.7120   4.716 0.000011903 ***
zelfgevoel    0.4673     0.1405   3.325     0.00141 **
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 12.85 on 70 degrees of freedom
Multiple R-squared:  0.5311,    Adjusted R-squared:  0.5111
F-statistic: 26.43 on 3 and 70 DF,  p-value: 0.00000000001525
In de output zie je per voorspeller een geschatte helling (Estimate), zijn standaardfout standard error, een -toets, en een -waarde. Onderaan staan en de -toets voor het hele model.
1.1 Multipele regressie schatten en interpreteren
De vraag van de mier
In bos_dieren staan vierenzeventig dieren. Voor elk dier vier getallen. We willen weten of de drie voorspellers samen iets zinnigs zeggen over de notenoogst — en zo ja, welke voorspeller het meeste werk doet.
OpmerkingVoor je gaat rekenen — vier vragen aan jezelf
Een goede analyse begint niet bij lm(). Hij begint bij vier vragen die je elke keer opnieuw stelt — vóór je een toets pakt:
Wie of wat wordt er gemeten? (de onderzoeksobjecten) In ons geval: dieren in het bos.
Wat wordt er gemeten? (welke variabelen doen mee) Vier: notenoogst, denkkunst, leeftijd, zelfgevoel.
Onafhankelijk of afhankelijk? (uit de onderzoeksvraag, niet uit de data) Onderzoeksvraag: kunnen we notenoogst voorspellen uit de andere drie? Dan is notenoogst de afhankelijke variabele (), en denkkunst, leeftijd, zelfgevoel de onafhankelijke voorspellers ().
Wat is het meetniveau van elke variabele? (NOM / ORD / INT / BIN) Hier zijn ze alle vier interval. Geen factoren, geen binaire variabelen.
In dit eerste thema valt er nog niets te kiezen — bij vier interval-variabelen mét één afhankelijke en meerdere onafhankelijke is multipele regressie de techniek. Vanaf het volgende thema komt er een vijfde stap bij: welke techniek past bij dit design? Met een beslisboom als leesgids — vraag voor vraag, niet zoeken in een tabel.
T1 — Welke techniek past hier?
Drie nieuwe onderzoeksvragen — pen-en-papier
Voordat je verdergaat met de bos-data: oefen even het beslisritueel. Hieronder drie miniatuur-onderzoeken. Loop voor elk dezelfde vier vragen door (objecten, variabelen, afhankelijk/onafhankelijk, meetniveau) en concludeer dan: -toets, MRA, of ANOVA?
OpmerkingVraag T1 — Pen-en-papier
a)De bever vraagt zich af of bevers met grotere voortanden langere dammen bouwen. Hij meet bij bevers de tandbreedte (mm) en de damlengte (m). Welke techniek?
b)Een psycholoog meet bij cliënten de depressie-score (PHQ-, schaal –). Ze vermoedt dat slaapkwaliteit, sociaal-isolement-score en aantal weken in therapie samen de depressie-score voorspellen. Welke techniek?
c)Een onderwijskundige vergelijkt drie onderwijsvormen — frontaal, probleemgestuurd, blended — op het tentamen-cijfer (schaal –). Hij meet bij studenten. Welke techniek?
OpgeletAntwoord T1 — open na je eigen poging
a) Eén afhankelijke variabele (damlengte, INT) en één onafhankelijke voorspeller (tandbreedte, INT). Eén voorspeller en INT–INT enkelvoudige regressie, of equivalent: een -toets op . (Een Pearson-correlatie kan hier ook, maar die levert geen voorspellingsmodel.)
b) Eén afhankelijke variabele (depressie-score, INT) en drie onafhankelijke voorspellers (allemaal INT). MRA (multiple regression analysis).
c) Eén afhankelijke variabele (tentamen-cijfer, INT) en één onafhankelijke variabele met drie groepen (NOM). ANOVA.
De truc zit in stap 4: het meetniveau van de onafhankelijke variabele. INT-voorspellers regressie. NOM-voorspeller met meerdere groepen ANOVA.
1.1.a Verkenning van de data
Op verkenning
Voor je iets gaat uitrekenen, moet je weten wat je in handen hebt. Hoe groot is de groep, en hoe verhouden de variabelen zich tot elkaar?
Algemene vorm. Steekproefgrootte sample size en correlatiematrix correlation matrix:
NROW(mijn_data)mijn_data |>cor() |>round(3)
NROW() telt de rijen (= cases). cor() op een data frame met alleen numerieke kolommen levert een symmetrische matrix met alle Pearson-correlaties; round() houdt ’m leesbaar.
OpmerkingDe pipe |> is gewoon “en dan”
Hardop te lezen als één gedachtelijn van links naar rechts: neemmijn_data, bereken dan de correlatie-matrix, rond af op 3 decimalen. Elke |> is “en dan.” Eerst dit, dán dat, dán dat. We gebruiken die leesvolgorde door dit hoofdstuk heen waar dat helpt.
Voor onze dieren.
# Hoeveel dieren staan er in het lijstje?NROW(bos_dieren)
[1] 74
# Pearson-correlaties tussen alle paren variabelen, drie decimalen.# Lees: neem bos_dieren, bereken dan cor(), rond dan af op 3 decimalen.bos_dieren |>cor() |>round(3)
In de matrix staat op de diagonaal steeds (een variabele correleert perfect met zichzelf). De interessante getallen staan eronder of erboven — die zijn elkaars spiegelbeeld.
OpmerkingDezelfde regel zonder pipe
Je komt deze regel ook vaak genest tegen, zonder pipe:
round(cor(bos_dieren), 3)
Dat doet hetzelfde, maar je leest het van binnen naar buiten. Beide zijn even goed.
OpmerkingHoe je correlaties leest in een matrix
We schrijven de zero-order correlatie als — dat is de gewone Pearson-samenhang tussen en , zonder rekening te houden met andere voorspellers. Straks komen er twee zwaardere broertjes: de partialpartial correlation (, “ná aftrek aan beide kanten”) en de semipartial (, “ná aftrek alleen aan de X-kant”). De haakjes onderscheiden de semipartial van de partial.
OpmerkingVragen 1.1
a) Hoe groot is de groep dieren ()?
b) Is het — gegeven deze correlaties — zinvol om notenoogst te regresseren op denkkunst, leeftijd en/of zelfgevoel?
c) Welke variabele lijkt de sterkste voorspeller? Rapporteer de correlatie.
OpgeletAntwoord 1.1 — open na je eigen poging
a) dieren.
b) Ja, het is zinvol — denkkunst () en zelfgevoel () hangen flink samen met notenoogst, en die wil je in je model hebben. Leeftijd is met vrijwel nul (vuistregel: = “ongeveer geen samenhang”), dus op grond van alleen de zero-order correlatie zou je leeftijd kunnen laten vallen. Maar — in een meervoudige regressie kan een voorspeller die op zich weinig met correleert tóch een eigen unieke bijdrage leveren als hij iets vangt dat de andere voorspellers niet zien (dat heet suppressie; in de opgave Unieke VAF handmatig zie je wat het met de verklaarde variantie doet). Veilige keuze: leeftijd voorlopig meenemen en straks via de semipartial controleren of het iets oplevert.
c) Denkkunst, met . Maar — let op: voor het stukje verklaarde variantie moet je ’m nog kwadrateren. , dus denkkunst verklaart in zijn eentje ruwweg een derde van de variantie in notenoogst, niet meer dan de helft. Correlatie is een zijde, is een oppervlakte — eerst kwadrateren, dán interpreteren.
T2 — Hypothetisch bij onafhankelijke voorspellers
Stop — eerst pen-en-papier
Hieronder ga je het echte uit summary(lm_bos) afzetten tegen een hypothetische versie. Reken eerst.
OpmerkingVraag T2 — Pen-en-papier
Stel dat de drie voorspellers (denkkunst, leeftijd, zelfgevoel) onafhankelijk waren — onderling niets met elkaar te maken. Dan zou je van het volledige model gewoon kunnen schatten als de som van de gekwadrateerde zero-order correlaties:
Gegeven (uit de correlatiematrix hierboven):
Hoe sterk elke voorspeller op zichzelf samenhangt met de notenoogst
Voorspeller
r met notenoogst
denkkunst
.583
leeftijd
.099
zelfgevoel
.496
Note.r = zero-order correlatie, N = 74 dieren.
a) Bereken .
b) Voer pas daarna de chunk hieronder uit en lees af. Is die hoger of lager dan jouw hypothetische schatting? Waarom?
# Het werkelijke R^2 van het volledige modelsummary(lm_bos)$r.squared
[1] 0.5311492
OpgeletAntwoord T2 — open na je eigen poging
a) .
b) Het werkelijke — lager dan de hypothetische . Het verschil () is de overlap: denkkunst en zelfgevoel meten gedeeltelijk hetzelfde (hun onderlinge ), dus telt een deel van wat zij elk verklaren dubbel als je naïef optelt. In een echt model wordt die overlap maar één keer geteld. Voorspellers die onderling correleren maken het model dus minder dan de som der delen.
VAF in beeld — twee cirkels
Het Venn-diagram als eerlijke landkaart
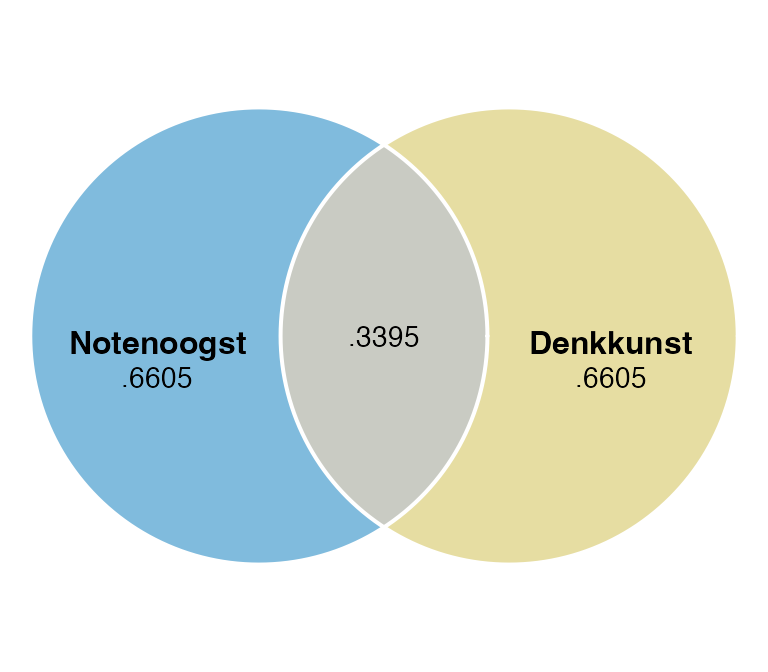
Het idee “verklaarde variantie” zit in twee cirkels die elkaar deels overlappen: de -cirkel (alle variantie in notenoogst) en de -cirkel (alle variantie in denkkunst). De overlap is precies — het stukje notenoogst dat denkkunst weet te verklaren.
Toon code (tekening van de twee cirkels)
# Eenmalig: install.packages("eulerr")library(eulerr)# Pearson-correlatie en haar kwadraat — zo zie je dat het niet-gedeelde stuk# geen toeval is maar gewoon 1 - r^2, symmetrisch voor allebei de cirkels.r_yd <-cor(bos_dieren$notenoogst, bos_dieren$denkkunst) |>round(4) # rr2_yd <- (r_yd^2) |>round(4) # gedeelde variantie (= r^2_{Y, X_1})fit2 <-euler(c("Notenoogst"=1- r2_yd, # variantie van notenoogst buiten de overlap"Denkkunst"=1- r2_yd, # variantie van denkkunst buiten de overlap"Notenoogst&Denkkunst"= r2_yd # gedeelde variantie = r^2_{Y, X_1}))# Getallen in de vlakken zonder voorloopnul, zoals in de tekst (een proportie# kan niet boven 1).lab2 <-sub("^0", "", sprintf("%.4f", fit2$original.values))plot(fit2,fills =list(fill =c("#0077BB", "#CCBB44"), alpha =0.5),labels =list(col ="black", font =2),quantities =list(labels = lab2, cex =0.9),edges =list(col ="white", lwd =2))
Figuur 1: VAF tussen notenoogst en denkkunst — overlap =
Wat je ziet: de twee cirkels zijn even groot (beide hebben totale variantie ), en de overlap is . Elke cirkel valt zo uiteen in een niet-gedeeld stuk () en het gedeelde stuk () — samen precies . Met verklaart denkkunst dus ongeveer een derde van de variantie in notenoogst — niet de helft, ook al klinkt als “meer dan half”.
TipCorrelatie is een zijde, is een oppervlakte
Wat we in een Venn tekenen als “grootte van de overlap” is oppervlakte, niet straal. En oppervlakte is proportioneel aan — niet aan zelf. Een correlatie van klinkt als “half”, maar verklaart slechts — een kwart van de variantie. Het Venn-diagram laat dat eerlijk zien zolang we de oppervlaktes op schalen. Het pakket eulerr doet dat automatisch: je geeft de gewenste oppervlaktes, en het plot ze area-proportional.
Rode draad door dit thema. Correlatie = zijde. Verklaarde variantie = oppervlakte. Eerst kwadrateren, dan optellen. Nooit andersom. Dezelfde regel keert straks terug bij T6/T7 (semipartial² als unieke VAF) en in de discussie of een tabel met zero-order- en semipartial-correlaties bij elkaar mag worden opgeteld (het mag niet — eerst kwadrateren).
WaarschuwingTentamenval — uit een tabel met correlaties
Stel: je krijgt op het tentamen een tabelletje met een zero-order correlatie en een semipartial . Vraag: bereken van het volledige tweepredictoren-model.
Niet: . Dat is zijde + zijde — onzin (en niet eens dimensionaal te plaatsen). Wel: . Eerst kwadrateren, dán optellen. Past binnen en is wat daadwerkelijk is.
Vuistregel: een correlatie is een zijde, verklaarde variantie is oppervlakte. Optellen mag pas op oppervlakte-niveau — dus pas ná het kwadrateren.
Drie stiekeme controles. Voordat je het model serieus mag nemen, controleer je drie dingen: multicollineariteit (), uitschieters en invloed (), en residual plots (). Eén aanname zit vóór die drie — die check je niet in de data, maar in je studie-opzet.
OpmerkingOnafhankelijkheid van observaties — een ontwerpvraag, geen toets
Lineariteit, homoscedasticiteit en normaliteit kun je in plots checken. Onafhankelijkheid is anders: die zit niet in je data maar in je studieopzet. Het komt neer op één vraag:
“Geeft elke rij in mijn dataset informatie die niet al ergens anders in de tabel zit?”
Schendingen zien er zo uit:
Herhaalde metingen op dezelfde unit (dezelfde eekhoorn op meerdere dagen, in één regressiemodel zonder unit-aanduiding).
Clustering: dieren binnen hetzelfde nest, leerlingen binnen dezelfde klas, patiënten binnen dezelfde therapeut.
Tijdsafhankelijkheid: opeenvolgende observaties die op elkaar lijken (residuen drift, autocorrelatie).
Spillover: het gedrag van het ene dier beïnvloedt het volgende (dieren die elkaar kunnen zien, samenwerken, beconcurreren).
Heb je herhaalde metingen op dezelfde unit? Dan hoort het thuis in een repeated-measures-analyse (thema 6), niet in een gewone MRA.
In dit hoofdstuk werken we met cross-sectionele dier-data waarin elk dier één rij is en dieren onafhankelijk zijn — dan is de aanname plausibel zonder verdere check. Voor je eigen onderzoek: denk vooraf na over je design, niet achteraf over een toets.
TipVuistregel — onafhankelijkheid is een design-keuze, niet een data-check
De hoofdvraag los je op bij het ontwerp van je studie: één rij per onafhankelijke unit, geen verborgen geneste structuur. Als je die discipline mist bij het verzamelen, kan geen toets dat achteraf goed maken.
OpmerkingVoor wie verder wil — als de observaties tóch samenhangen
Er bestaan formele toetsen op afhankelijkheid: Durbin-Watson voor metingen die in de tijd op elkaar volgen, de intraclass-correlatie voor clusters. Ze vertellen je achteraf óf er samenhang is; repareren doen ze niets.
Zit er clustering in je data (dieren binnen nesten, leerlingen binnen klassen, patiënten binnen therapeuten), dan is een multilevel-model (ook: mixed-effects- of random-effects-model) de gebruikelijke route. Dat model weet welke rijen bij elkaar horen. Een lichtere uitweg zijn robuuste standaardfouten: die corrigeren de standaardfouten voor de samenhang, zonder het model zelf te veranderen.
1.1.b Multicollineariteit (VIF)
Of de voorspellers elkaar niet voor de voeten lopen
Soms lijken twee voorspellers zo op elkaar dat ze alleen samen nog iets zeggen, maar geen van beide nog op zichzelf. De VIFvariance inflation factor vraagt aan elke voorspeller: “kun jij voorspeld worden door de anderen?” Hoe hoger het antwoord, hoe minder uniek je bent. We schrijven — een waarde per voorspeller. Tolerancetolerance is zijn spiegel: .
Algemene vorm.
# vif() uit het pakket 'car' geeft per voorspeller een getal.vif(mijn_model)
Voor onze dieren.
# VIF per voorspeller. Vuistregel: VIF >= 10 is een probleem.vif(lm_bos)
d) Is er sprake van multicollineariteit? Rapporteer de VIF-waarden.
OpgeletAntwoord 1.1 — open na je eigen poging
In gewone woorden. Multicollineariteit is hier geen probleem. Alle VIF-waarden zitten ruim onder de drempel van : denkkunst is van de drie het minst uniek (), maar zelfs dat is licht.
APA-stijl.
Multicollineariteit vormde geen probleem; alle variance inflation factors lagen ruim onder de gebruikelijke drempel van (denkkunst: ; leeftijd: ; zelfgevoel: ).
TipVuistregel
: niets aan de hand. : een voorspeller die door de anderen bijna perfect te voorspellen is — terug naar de tekentafel. In tolerance staat dezelfde grens andersom: is een probleem, want .
T3 — Multicollineariteit zonder R
OpmerkingVraag T3 — Pen-en-papier
Twee voorspellers en correleren onderling sterk: . Beide hangen evenredig samen met de uitkomst: .
a) Wat verwacht je dat er gebeurt met de -toetsen op en in een model dat beide voorspellers tegelijk meeneemt?
b) Wat zou er gebeuren als je in plaats daarvan twee aparte enkelvoudige regressies deed (alleen op , en alleen op )?
OpgeletAntwoord T3 — open na je eigen poging
a) Beide -toetsen worden waarschijnlijk niet-significant, ondanks dat elke voorspeller op zichzelf heeft. Want: de -toets op in een gezamenlijk model toetst de unieke bijdrage. en zeggen bijna hetzelfde (); de unieke toevoeging van elk is daardoor klein, en de standaardfouten worden opgeblazen ( rond , nog onder de drempel van , maar duidelijk geïnflateerd).
b) In de twee aparte enkelvoudige regressies is elk verband helder zichtbaar: en vertalen netjes uit hun zero-order en zijn beide significant.
Nuance. Multicollineariteit verandert de schatting van niet — die is nog steeds onbevooroordeeld. Wat verandert is de standaardfout: die wordt groter, dus toets-conclusies kunnen omslaan. Een veel gehoorde nuance is dat multicollineariteit in sociale wetenschappen meestal geen praktisch probleem oplevert — alleen bij echt extreme correlaties tussen voorspellers loopt het uit de hand.
1.1.c Uitschieters en invloed
Of er een bedrieger in het lijstje staat
Soms zit er één dier tussen dat het hele model in zijn eentje stuurt. Drie maten samen vertellen je of zo’n dier er is.
Gestandaardiseerd residustandardized residual vraagt: “hoe ver zit dit dier ervanaf, in standaardafwijkingen?” Boven wordt het verdacht.
Cook’s distance vraagt iets diepers: “als ik dit dier weghaal, hoeveel verandert dan het hele model?” Boven is een rode vlag.
Leverageleverage / hefboomwaarde vraagt: “staat dit dier ongewoon ver van de groep, op de voorspellers?” Boven is het ongewoon.
Algemene vorm. Voeg de drie diagnostiek-statistieken als kolommen toe aan je data:
# Voeg per dier drie diagnostiek-getallen toe.bos_dieren$stdres <-rstandard(lm_bos) # gestandaardiseerd residubos_dieren$leverage <-hatvalues(lm_bos) # leverage (afstand tot voorspeller-zwaartepunt)bos_dieren$cd <-cooks.distance(lm_bos) # Cook's distance (totale invloed op het model)# Drempel voor leverage in dit model: 3 * (k+1) / N met k = 3 voorspellers.k <-3N <-nrow(bos_dieren)3* (k +1) / N
[1] 0.1621622
# Min/max van de drie statistieken — eerste blik op extremen.summary(bos_dieren[, c("stdres", "leverage", "cd")])
     stdres            leverage             cd
 Min.   :-2.82186   Min.   :0.01417   Min.   :0.0000011
 1st Qu.:-0.49079   1st Qu.:0.02416   1st Qu.:0.0011038
 Median : 0.14446   Median :0.03227   Median :0.0037505
 Mean   : 0.01562   Mean   :0.05405   Mean   :0.1285865
 3rd Qu.: 0.75320   3rd Qu.:0.04782   3rd Qu.:0.0136008
 Max.   : 2.13470   Max.   :0.94358   Max.   :8.2069366
# mutate() zet de drie kolommen er in één keer bij. De functies zijn dezelfde# als bij base R; alleen het dollarteken valt weg.bos_dieren <- bos_dieren |>mutate(stdres =rstandard(lm_bos), # gestandaardiseerd residuleverage =hatvalues(lm_bos), # leveragecd =cooks.distance(lm_bos)) # Cook's distance# De drempel is gewoon een som; daar komt geen dplyr aan te pas.k <-3N <-nrow(bos_dieren)3* (k +1) / N
[1] 0.1621622
# select() kiest de drie kolommen bij hun kale naam, summary() vat ze samen.bos_dieren |>select(stdres, leverage, cd) |>summary()
     stdres            leverage             cd
 Min.   :-2.82186   Min.   :0.01417   Min.   :0.0000011
 1st Qu.:-0.49079   1st Qu.:0.02416   1st Qu.:0.0011038
 Median : 0.14446   Median :0.03227   Median :0.0037505
 Mean   : 0.01562   Mean   :0.05405   Mean   :0.1285865
 3rd Qu.: 0.75320   3rd Qu.:0.04782   3rd Qu.:0.0136008
 Max.   : 2.13470   Max.   :0.94358   Max.   :8.2069366
OpmerkingVraag 1.1
e) Wat zeggen de gestandaardiseerde residuen, Cook’s distances en leverage-waarden over uitschieters? Wijzen de drie maten dezelfde kant op?
OpgeletAntwoord 1.1 — open na je eigen poging
In gewone woorden. Eén dier valt buitengewoon ver uit de toon. De Cook’s distance haalt — ver boven de drempel van — en zijn leverage is , terwijl de drempel hier is. Tegelijk blijft het gestandaardiseerde residu tussen en (max , onder drempel ). De drie maten wijzen dus niet allemaal dezelfde kant op: Cook’s distance en leverage flaggen dit dier, het gestandaardiseerde residu mist hem. Precies waarom je deze drie naast elkaar moet bekijken — een hoge leverage trekt de regressielijn naar de case toe en maakt zijn eigen residu onschuldig.
APA-stijl.
Eén case toonde extreme invloed (Cook’s distance ) en zeer hoge leverage (, ten opzichte van een drempelwaarde van ). Het gestandaardiseerde residu van deze case lag binnen aanvaardbare grenzen (), wat illustreert dat residueel onderzoek alleen onvoldoende is om invloedrijke cases op te sporen wanneer de leverage hoog is.
TipWat de mier opmerkte
“Eén dier kan onschuldig lijken op één maat en gevaarlijk op een andere. Daarom kijken we altijd naar alle drie.”
1.1.d Residual plots
Of de plaatjes vriendelijk zijn
Twee tekeningen zeggen je in één oogopslag of het model klopt: residuen residuals tegen voorspelde waarden fitted values, en de Q-Q-plot.
T9 — Residual-plots herkennen
OpmerkingVraag T9 — Pen-en-papier
Hieronder zie je zes geschetste residual-plots (residu op de y-as, voorspelde waarde op de x-as). Alle zes hebben dezelfde y-as. Welke patronen herken je?
Voor elk paneel: kies één label.
lineair / homoscedastisch (model klopt)
non-lineair (kromme structuur — model mist iets)
heteroscedastisch (waaiert uit — standaardfouten kloppen niet)
non-lineair én heteroscedastisch (allebei mis)
één invloedrijke outlier (rest is in orde)
OpgeletAntwoord T9 — open na je eigen poging
A — lineair, homoscedastisch. Rustige horizontale wolk rond de nullijn.
B — non-lineair. Duidelijke omgekeerde-U; het model mist een kromme term.
C — heteroscedastisch. Trechtervorm: de spreiding groeit met fitted.
D — lineair, homoscedastisch. Wel meer ruis dan A: op dezelfde y-as liggen de punten van D verder van de nullijn. De standaarddeviatie van de residuen is 1.39 tegen 0.97 bij A, 1.43 keer zo groot. Meer ruis is geen schending: zolang de spreiding van links naar rechts gelijk blijft, klopt het model. Het voorspelt alleen minder precies.
E — non-lineair, en wel een S-vormig residu: verkeerd model. Het echte verband loopt op-en-af in een sigmoid; MRA fit er een rechte lijn doorheen, en wat overblijft zijn residuen die zelf de S-vorm hebben gekopieerd. Dit zie je bij binaire of bij niet-lineaire dosis-respons. In thema 4 (logistische regressie) zien we hoe je dit wél goed modelleert.
F — lineair, met één extreme outlier rechtsboven.
De diagnostiek bestaat uit twéé gelaagde vragen: patroon (kromming = non-lineariteit) én spreiding (waaiert uit = heteroscedasticiteit). Een plot kan op één of beide vlakken misgaan, of allebei goed zijn. Paneel E is een speciaal geval — niet zomaar een kromming maar precies een sigmoid-overblijfsel; het signaal dat je in plaats van MRA een logistisch model moet gebruiken.
Algemene vorm.plot() op een lm-object kent zes diagnostische tekeningen. Wij gebruiken nummer 1 (lineariteit + homoscedasticiteit) en 2 (normaliteit residuen):
plot(mijn_model, which =1) # Residuals vs Fittedplot(mijn_model, which =2) # Q-Q plot
Voor onze dieren.
# Plaatje 1: foutjes tegen voorspelde waarden.# `sub.caption = ""` haalt de auto-ondertitel met de modelformule weg.plot(lm_bos, which =1, sub.caption ="",caption ="Residuen tegen voorspelde waarden")
# Plaatje 2: theoretische normaalkwantielen tegen empirische residuen.plot(lm_bos, which =2, sub.caption ="",caption ="Q-Q-plot van residuen")
OpmerkingVraag 1.1
f) Zie je tekenen van non-lineariteit, heteroscedasticiteit of niet-normale residuen?
OpgeletAntwoord 1.1 — open na je eigen poging
In gewone woorden. De Residuals-vs-Fitted-plot toont een redelijk rustige horizontale wolk; geen duidelijke kromming en geen sterke trechtervorm. De Q-Q-plot ligt voor het overgrote deel netjes op de diagonaal, met een zichtbare uitschieter rechts in de staart — dat is dezelfde case die in 1.1.c naar voren kwam. Bij deze steekproefgrootte () is de regressie robuust tegen kleine afwijkingen van normaliteit.
APA-stijl.
Visuele inspectie van de Residuals-vs-Fitted-plot wees niet op systematische non-lineariteit of heteroscedasticiteit. De Q-Q-plot van de residuen volgde de theoretische verdeling op één invloedrijke uitschieter na. Gezien de robuustheid van de - en -toetsen tegen lichte afwijkingen van normaliteit bij , werd geen aanvullende correctie toegepast.
TipWat je idealiter ziet
Plaatje 1: een puntenwolk in een rustige horizontale band, met de rode lijn ongeveer plat. Plaatje 2: punten netjes op de schuine lijn.
WaarschuwingAlarm: wanneer wordt een geschonden aanname een echt probleem?
Niet elke afwijking is een ramp. De - en -toetsen zijn redelijk robuust tegen kleine schendingen, vooral bij grotere steekproeven. Bij voldoende is robuust tegen schendingen van normaliteit (centrale limietstelling). Specifieke vuistregels per groep zijn er niet voor MRA — die zijn voor ANOVA-context (zie thema 2). Maar:
Duidelijke kromming in de Residuals-vs-Fitted-plot het lineaire model klopt niet. Overweeg transformatie (log, kwadraat) of een niet-lineaire term.
Sterk uitwaaierende trechtervorm heteroscedasticiteit. Standaardfouten kloppen niet meer; coëfficiënten zijn onbetrouwbaar getoetst.
Q-Q-plot met grote afwijkingen in de staarten bij kleine steekproef () normaliteit telt nu echt mee.
voor één of meer voorspellers multicollineariteit. Coëfficiënten worden onstabiel.
Cook’s distance voor één of meer cases invloedrijke punt(en) sturen het model.
1.1.e Interpretatie van het model
Wat zegt het model nu eigenlijk?
Aannames gecheckt, dan mag het model spreken. Eerst over zichzelf — wat verklaart het samen? — en daarna per voorspeller.
Algemene vorm.
summary(mijn_model) # F-toets, R^2, coëfficiënten, t-toetsenols_correlations(mijn_model) # zero-order, partial, part per voorspeller
In de summary() staan twee dingen door elkaar: het modelniveau (onderaan: , , , ) en het voorspellerniveau (de coëfficiënten-tabel). De ols_correlations() uit olsrr splitst per voorspeller drie soorten correlatie uit:
zero-order — kale Pearson, geen correctie.
partial — gecorrigeerd voor de andere voorspellers, aan beide kanten.
part / semipartial — gecorrigeerd alleen aan de X-kant. Het kwadraat ervan is precies de unieke proportie variantie.
En zonder kwadraat? Die heet de multipele correlatiemultiple correlation: de gewone correlatie tussen wat de dieren écht oogstten () en wat het model voor ze voorspelt (). Hoe dichter de voorspellingen bij de echte notenoogst liggen, hoe hoger . Kwadrateer hem en je hebt terug. Voor het bos-model: , en het kwadraat daarvan is .
WaarschuwingVerwarrend! Wat heet wat in de ols_correlations()-tabel?
De kolomnamen in R en de namen waar wij in MVDA over praten lopen niet netjes parallel. Eén keer goed kijken en het is duidelijk — pas op, want je vergeet het anders weer:
Kolom in R (olsrr)
Naam in MVDA / NL
Symbool
Waarvoor gebruik je ’m?
Zero-order
gewone correlatie
losse samenhang ↔︎
Partial
partiële correlatie
residuen van en na uitfilteren van de rest — aan beide kanten gecorrigeerd
Part
semipartiële correlatie
unieke bijdrage van — alleen aan -kant gecorrigeerd. Dit is de kolom die je in MVDA gebruikt. Kwadrateer hem en je hebt de unieke proportie variantie.
Onthou: Part = semipartial = onze werkpaard-kolom. Partial lijkt erop te trekken maar is iets anders — een mooie val om op het tentamen in te trappen.
TipHoe lees je een coëfficiënt ?
Drie dingen tegelijk uit één coëfficiënt:
Teken — positief of negatief? Een positieve betekent: hoger op deze voorspeller hangt samen met hoger op .
Grootte — hoeveel verandert gemiddeld per één eenheid extra op de voorspeller? Vertaal het naar de inhoud.
Onder constante andere voorspellers — de stille clausule die altijd geldt in een meervoudige regressie. Wat je vertelt, geldt voor dieren die op de andere voorspellers vergelijkbaar zijn.
Taligheid — let op causale werkwoorden. Twee formuleringen zijn veilig:
“Een dier dat één punt hoger scoort op denkkunst, oogst gemiddeld noten meer” — vergelijking tussen dieren, cross-sectioneel.
“Een toename van één punt op denkkunst gaat samen met een toename van in notenoogst” — samenhang, geen oorzaak.
Wat je niet mag zeggen zonder longitudinale of experimentele data: “als denkkunst stijgt, dan stijgt notenoogst”, “meer denkkunst zorgt voor meer notenoogst”, “door denkkunst verhoogt de oogst”. Dat zijn causale werkwoorden — die mag je pas gebruiken als je studie-opzet ze rechtvaardigt (manipulatie, voor-en-na-meting, randomisatie). De bos-data is een momentopname; één meting per dier. Zonder tijd-as is er geen verandering om over te praten.
OpmerkingConcept — versus
De ruwe regressiecoëfficiënt leest in de eenheden van en : “per één eenheid extra denkkunst, noten meer”. Handig inhoudelijk, maar je kunt en niet zomaar in grootte met elkaar vergelijken — als in punten loopt en in jaren, wat groter is hangt af van toevallige meeteenheden.
De gestandaardiseerde coëfficiënt lost dat op: hij staat in eenheden van standaardafwijking, en is daarmee onderling vergelijkbaar. De vertaling is mooi simpel:
(In een enkelvoudige regressie geldt zelfs .) Wij gebruiken vooral om voorspellers in belangrijkheid te ordenen.
T4 — Bereken uit en SD’s
OpmerkingVraag T4 — Pen-en-papier
Voor de bos-data zijn de standaardafwijkingen:
De spreiding van de vier bos-variabelen
Variabele
s
notenoogst ()
18.37
denkkunst ()
13.83
leeftijd ()
2.31
zelfgevoel ()
13.10
Note.s = standaardafwijking, in de eenheid van de variabele zelf.
De gestandaardiseerde coëfficiënt voor denkkunst is .
a) Bereken uit en de SD’s. (Hint: keer de formule om — .)
b) Voer pas daarna de chunk hieronder uit en vergelijk met de Estimate van denkkunst in summary(lm_bos).
# Modelniveau: F-toets en R-squared. Voorspellerniveau: coëfficiënten + t-toetsen.summary(lm_bos)
Call:
lm(formula = notenoogst ~ denkkunst + leeftijd + zelfgevoel,
    data = bos_dieren)

Residuals:
    Min      1Q  Median      3Q     Max
-35.291  -6.211   1.840   8.471  25.237

Coefficients:
            Estimate Std. Error t value    Pr(>|t|)
(Intercept) -78.1381    17.8838  -4.369 0.000042353 ***
denkkunst     0.7377     0.1346   5.480 0.000000631 ***
leeftijd      3.3578     0.7120   4.716 0.000011903 ***
zelfgevoel    0.4673     0.1405   3.325     0.00141 **
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 12.85 on 70 degrees of freedom
Multiple R-squared:  0.5311,    Adjusted R-squared:  0.5111
F-statistic: 26.43 on 3 and 70 DF,  p-value: 0.00000000001525
OpgeletAntwoord T4 — open na je eigen poging
a) .
b) In summary(lm_bos) staat . Komt overeen (afrondverschillen in de derde decimaal). Het laat zien dat en gewoon andere uitdrukkingen van hetzelfde verband zijn — geen aparte schatting, alleen een herschaling.
TipSudoku met je regressietabel — SS, MS, F en RSE uit summary() halen
summary(lm_bos) print , de -toets, en de coëfficiënten — maar de kwadratensommen (, , ) staan er niet expliciet in. Geen ramp: een paar identiteiten en je rekent de hele tabel zelf uit. Dit is de sudoku van de regressietabel — drie cellen weg, vier optellingen en delingen, alles erin.
De keten (df = vrijheidsgraden):
Cel
Formule
Voor het bos-model
(aantal voorspellers)
✓
✓
In R kun je ze ook direct trekken — geen kunststuk, maar wel handig om te zien:
SS_T <-var(bos_dieren$notenoogst) * (NROW(bos_dieren) -1)SS_M <-summary(lm_bos)$r.squared * SS_TSS_E <- SS_T - SS_Mdf_E <-df.residual(lm_bos)MS_E <- SS_E / df_Esqrt(MS_E) # zelfde getal als "Residual standard error" in summary()
Ook anova(lm_bos) laat ze zien: de Sum Sq van de drie voorspellers tellen samen op tot , en de rij Residuals is .
Waarom doet het ertoe? Je tentamen krijgt vaak een halve tabel, of een tekst met “de F-toets was 26.43 op (3, 70) — bereken ”. Wie de identiteiten kent, vult de sudoku-cellen in en hoeft niets uit het hoofd te leren.
Die laatste gaat zo. Begin bij de definitie van :
Vermenigvuldig beide kanten met ; dan vallen de ’s rechts weg:
Dus en staan in dezelfde verhouding als en , en mogen hun plek innemen in :
Voor het bos-model: — hetzelfde als in summary(lm_bos).
# Drie soorten correlatie per voorspeller.ols_correlations(lm_bos)
                Correlations
--------------------------------------------
Variable      Zero Order    Partial    Part
--------------------------------------------
denkkunst          0.583      0.548    0.448
leeftijd           0.099      0.491    0.386
zelfgevoel         0.496      0.369    0.272
--------------------------------------------
Semipartial in beeld — drie cirkels
Wat is “uniek” en wat is “gedeeld”?
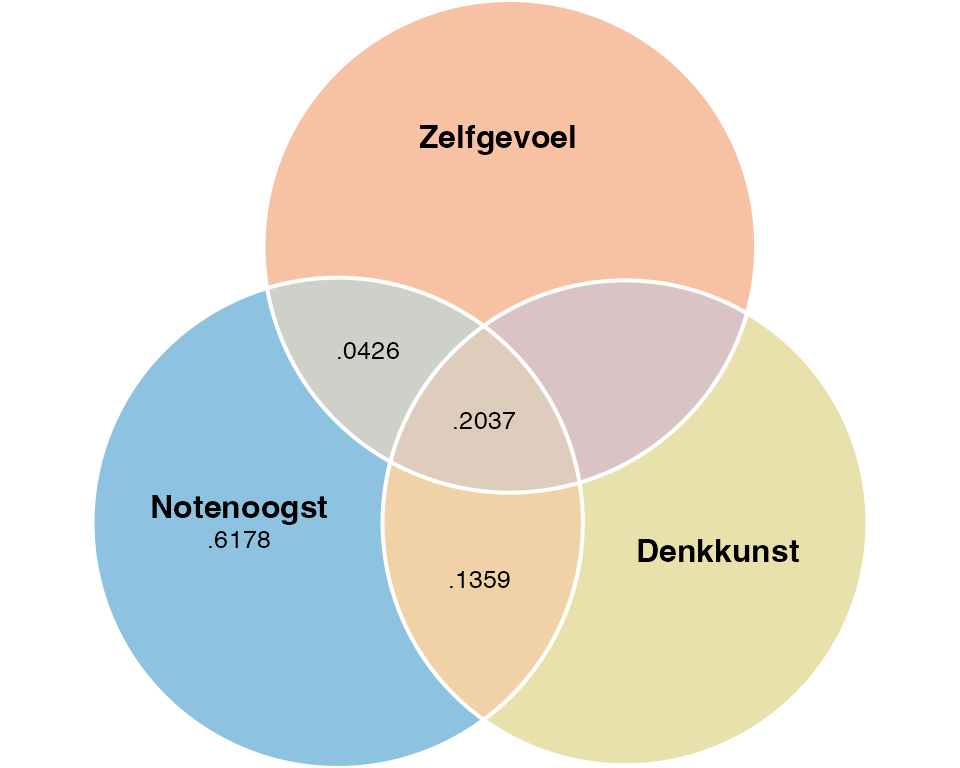
Met twee voorspellers tegelijk wordt het Venn pas echt nuttig. Hieronder een voorbeeld met denkkunst en zelfgevoel als voorspellers van notenoogst (leeftijd even buiten beeld voor leesbaarheid). Het tweepredictoren-model verklaart .
Toon code (tekening van de drie cirkels)
# De bouwstenen zijn hierboven al uitgerekend, in een verborgen stukje code:# lm_2pred <- lm(notenoogst ~ denkkunst + zelfgevoel, data = bos_dieren)# R2_total <- summary(lm_2pred)$r.squared # R^2 van het model# sr2_d <- ols_correlations(lm_2pred)$Part[1]^2 # uniek door denkkunst# sr2_z <- ols_correlations(lm_2pred)$Part[2]^2 # uniek door zelfgevoel# shared <- R2_total - sr2_d - sr2_z # gedeeld in Y# X-X-overlap buiten Y: r(denkkunst, zelfgevoel)^2 minus de gedeelde variantie in Y.r_dz <-cor(bos_dieren$denkkunst, bos_dieren$zelfgevoel)xx_buiten <-round(r_dz^2- shared, 4)fit3 <-euler(c("Notenoogst"=1- R2_total, # Y zonder X-overlap"Denkkunst"=0.55, # denkkunst zonder Y, zonder zelfgevoel"Zelfgevoel"=0.65, # zelfgevoel zonder Y, zonder denkkunst"Notenoogst&Denkkunst"= sr2_d, # uniek door denkkunst (in Y)"Notenoogst&Zelfgevoel"= sr2_z, # uniek door zelfgevoel (in Y)"Denkkunst&Zelfgevoel"= xx_buiten, # X-X overlap buiten Y"Notenoogst&Denkkunst&Zelfgevoel"= shared # gedeeld door beide (in Y) = R2 - sr2_d - sr2_z))# Alleen de vier stukken binnen notenoogst zijn getallen uit de data; de rest# (0.55, 0.65 en de X-X-overlap) is tekenmaat en krijgt geen getal in de figuur.lab3 <-setNames(rep("", length(fit3$original.values)), names(fit3$original.values))echt3 <-c("Notenoogst", "Notenoogst&Denkkunst", "Notenoogst&Zelfgevoel","Notenoogst&Denkkunst&Zelfgevoel")lab3[echt3] <-vier(fit3$original.values[echt3])plot(fit3,fills =list(fill =c("#0077BB", "#CCBB44", "#EE7733"), alpha =0.45),labels =list(col ="black", font =2),quantities =list(labels =unname(lab3), cex =0.8),edges =list(col ="white", lwd =2))
Figuur 2: Drie cirkels — uniek door denkkunst (), uniek door zelfgevoel (), gedeeld (). Samen .
Wat je ziet binnen de notenoogst-cirkel: drie verschillende stukken. Het kleine maantje aan de denkkunst-kant () is de gekwadrateerde semipartial — wat denkkunst uniek toevoegt boven zelfgevoel. Hetzelfde aan de zelfgevoel-kant (). Het grote middelste segment () is de gedeelde verklaring: notenoogst-variantie die beide voorspellers tegelijk verklaren. Zonder gedeelde variantie zouden de twee unieke stukken gewoon optellen tot ; mét gedeelde variantie is groter dan de som van de unieke stukken alleen.
OpmerkingVragen 1.1
g) Kan de nul “geen samenhang tussen notenoogst en de drie voorspellers samen” verworpen worden? Rapporteer , en . Schrijf voluit op in een hele zin — en geef expliciet aan of die uitspraak over je dieren in de steekproef gaat of over de hele dierenpopulatie waaruit ze komen.
h) Wat is de geschatte regressievergelijking? Vertel in woorden wat elke coëfficiënt betekent. Is de intercept () inhoudelijk zinvol, of beschrijft hij een onmogelijk dier?
T5 — Voorspelling met de hand
OpmerkingVraag T5 — Pen-en-papier
Stel je een dier voor met de volgende waarden:
denkkunst
leeftijd
zelfgevoel
a) Schrijf de regressievergelijking op (hint: kijk naar de Estimate-kolom in summary(lm_bos)):
b) Bereken voor dit dier.
c) Lijkt dat een aannemelijk getal vergeleken met de verdeling van notenoogst (range ongeveer –, gemiddelde rond )?
OpgeletAntwoord T5 — open na je eigen poging
a) Uit summary(lm_bos): , , , .
b)
c) Ja: noten ligt boven het gemiddelde maar binnen het bereik. Plausibel voor een dier met bovengemiddelde denkkunst, gemiddelde leeftijd en bovengemiddeld zelfgevoel.
OpmerkingVragen 1.1 — vervolg
i) Welke voorspellers zijn significant, welke niet? Rapporteer test-statistic, en per voorspeller.
j) Hoeveel variantie van notenoogst verklaart het hele model?
k) Hoeveel variantie verklaart elke voorspeller uniek? (tip: kwadrateer de Part-correlatie uit ols_correlations()).
l) Welke voorspeller verklaart de meeste unieke variantie?
OpgeletAntwoord 1.1 — open na je eigen poging
In gewone woorden. Het hele model voorspelt notenoogst zeer significant (, ).
De voluit (g).In de populatie dieren waaruit deze 74 dieren een steekproef zijn, hangen denkkunst, leeftijd en zelfgevoel niet samen met notenoogst: . De ster () maakt zichtbaar dat het over de populatie-coëfficiënten gaat, niet over de geschatte coëfficiënten van deze 74 dieren. Een nulhypothese gáát over de populatie — anders zou je ’m met je eigen steekproef gewoon kunnen aflezen, en is er niets te toetsen. Met , verwerpen we : de drie voorspellers verklaren samen significant variantie in notenoogst in de populatie.
De geschatte vergelijking is
De intercept () is de voorspelde notenoogst als alle voorspellers nul zouden zijn — een dier met denkkunst , leeftijd jaar (pasgeboren) en zelfgevoel . Geen enkel dier in de bos-data zit ook maar in de buurt. Extrapolatie buiten je data-bereik, inhoudelijk niet zinvol — maar mathematisch nodig om de regressielijn op de juiste hoogte te krijgen. Alle drie de coëfficiënten zijn positief, en moeten elk gelezen worden bij dieren die op de andere twee voorspellers vergelijkbaar zijn:
Een dier dat één punt slimmer denkt, oogst gemiddeld noten meer.
Een dier dat één jaar ouder is, oogst noten meer.
Een dier met één punt meer zelfgevoel, oogst noten meer (g, h).
Alle drie de voorspellers zijn afzonderlijk significant: denkkunst , ; leeftijd , ; zelfgevoel , (i).
Het model verklaart — drieënvijftig procent van de variantie (j). De unieke proporties (kwadraat van de Part-correlaties): denkkunst (), leeftijd (), zelfgevoel () (k). Denkkunst verklaart de meeste unieke variantie (l).
APA-stijl.
Een meervoudige regressieanalyse met denkkunst, leeftijd en zelfgevoel als voorspellers van notenoogst was statistisch significant, , , (VAF ). Alle drie de voorspellers droegen uniek en positief bij. Bij dieren die op de andere twee voorspellers vergelijkbaar waren, hing een hogere denkkunst samen met een grotere notenoogst, , , , . Hetzelfde positieve patroon gold voor leeftijd, , , , , en voor zelfgevoel, , , , . Denkkunst leverde de sterkste unieke bijdrage.
T6 — Unieke VAF handmatig
OpmerkingVraag T6 — Pen-en-papier
Uit ols_correlations(lm_bos) lees je de Part-correlaties (semipartials) af:
Wat elke voorspeller uniek bijdraagt aan de voorspelling van de notenoogst
Voorspeller
Part
denkkunst
.448
leeftijd
.386
zelfgevoel
.272
Note. Part = semipartiële correlatie: de samenhang tussen notenoogst en het deel van dat de andere twee voorspellers niet al dragen. Uit ols_correlations(lm_bos), N = 74 dieren.
a) Kwadrateer elke Part-correlatie en sommeer ze: dat is de totale unieke verklaarde variantie.
b) Vergelijk met . Hoe ziet het verschil () eruit, en wat is dat?
OpgeletAntwoord T6 — open na je eigen poging
a) .
b) . Dat verschil is gedeelde variantie: variantie in notenoogst die meerdere voorspellers tegelijk verklaren, en die daardoor in geen enkele Part-correlatie zit. Dat het hier positief uitvalt, is de gewone gang van zaken; wanneer het negatief kan worden, lees je hieronder bij Suppressie — waarom het gedeelde stuk negatief kan worden.
Suppressie — waarom het gedeelde stuk negatief kan worden
Jouw verschil bij (b) was positief: lag boven de som van de unieke stukken, en wat overbleef heette gedeeld. Zo gaat het meestal. Altijd is het niet: het gedeelde stuk kan ook negatief uitvallen. De unieke stukken tellen dan samen op tot méér dan . Tekenen kun je dat niet — een vlak met een negatieve oppervlakte bestaat niet — en daar houdt het Venn-diagram op.
Wat er dan aan de hand is, heet suppressiesuppression, letterlijk: onderdrukking. Op grond van de zero-order correlaties — de losse samenhang van elke voorspeller met — heb je een naïef idee: een voorspeller die op zichzelf met samenhangt, zal in het model ook wel wat doen, en een die dat niet doet, zal wel niks doen. Meestal klopt dat. Maar een meervoudige regressie kan rare dingen opleveren. Soms krijgt een voorspeller met een zero-order correlatie van bijna nul in het model tóch een stevig gewicht. Zo’n voorspeller heet een suppressor: hij onderdrukt in een andere voorspeller het stuk dat met niets te maken heeft, de ruis, en daardoor krijgt die andere voorspeller opeens méér voorspelkracht. Het gewicht en het unieke stuk van die andere voorspeller worden gróter zodra de suppressor meedoet.
De definitie: er is suppressie als een voorspeller ná correctie voor de andere voorspellers méér van verklaart dan ervóór — zijn is groter dan zijn eigen met . Bij twee voorspellers is dat precies hetzelfde als een negatief gedeeld stuk. Op een tentamen herken je het dus aan een voorspeller met een zero-order correlatie van bijna nul die in het model tóch een duidelijk gewicht krijgt, aan een voorspeller die er bij het toevoegen van een andere juist stérker van wordt in plaats van zwakker, of aan unieke stukken die samen boven uitkomen.
Het bos heeft er een: leeftijd. Op zichzelf hangt leeftijd nauwelijks samen met de notenoogst (, dus ) — naïef gedacht: dat zal wel niks doen. Zet leeftijd nu eens alleen naast denkkunst, lm(notenoogst ~ denkkunst + leeftijd, data = bos_dieren), en kwadrateer de Part-correlaties uit ols_correlations(), zoals je bij T6 deed. Leeftijd verklaart dan uniek , ruim tien keer zijn eigen . En denkkunst — dat is het gekke — verklaart mét leeftijd ernaast uniek , méér dan zijn eigen zonder leeftijd. Allebei verklaren ze ná correctie méér dan ervoor. Tel op: , terwijl het model samen maar verklaart. Het gedeelde stuk is . Negatief. Dit Venn-diagram bestaat niet.
Hoe kan een voorspeller die zelf bijna niets met noten heeft, denkkunst sterker maken? Leeftijd hangt negatief samen met denkkunst (): dieren die ouder zijn, scoren gemiddeld wat lager op denkkunst. Maar met noten heeft leeftijd bijna niets. Wat er in denkkunst met leeftijd meeloopt, heeft met noten dus óók bijna niets te maken — dat is de ruis. Zit leeftijd in het model, dan wordt dat stuk uit denkkunst gefilterd, en wat overblijft voorspelt de notenoogst zuiverder.
Met alle drie de voorspellers in het model (T6) zie je er aan het totaal niets van: het gedeelde stuk is daar , keurig positief. Toch is leeftijd ook daar een suppressor — uniek tegen een eigen van — en de andere twee worden er sterker van: het unieke stuk van denkkunst groeit van (zonder leeftijd, de drie cirkels hierboven, daar op vier decimalen) naar , dat van zelfgevoel van naar . Het gedeelde stuk betaalt daarvoor: zonder leeftijd was het , met leeftijd , en wat eraf ging is wat de andere twee erbij kregen — reken maar na; door het afronden kan het een duizendste schelen. Dát doet een suppressor: hij haalt variantie uit het gedeelde deel en geeft die terug aan de voorspellers apart. Bij drie of meer voorspellers is “gedeeld” een optelsom, en daarin kan een negatief stuk schuilgaan achter een groot positief stuk; hier delen denkkunst en zelfgevoel samen zoveel dat de som boven nul blijft.
Eén ding nog: dit alles geldt voor deze dieren. Een suppressie-effect kan aan een handvol dieren hangen. Of leeftijd ook zonder het dier dat er niet in hoort nog een suppressor is, zie je bij Modelaanpassing na verwijdering van een invloedspunt.
T7 — Venn-diagram met vier cirkels
OpmerkingVraag T7 — Pen-en-papier
Teken een Venn-diagram met vier cirkels: de notenoogst-cirkel () en drie voorspeller-cirkels ( = denkkunst, = leeftijd, = zelfgevoel).
Markeer in jouw tekening:
a) De totale verklaarde variantie van notenoogst — dat is alle overlap met samen.
b) Het unieke deel van elke voorspeller — overlap met die geen enkele andere voorspeller deelt.
c) De gedeelde delen — overlap met waar twee of drie voorspellers in zitten.
Gebruik de getallen uit T6 (, , uniek; gedeeld; totaal ) om de cirkels in verhouding te tekenen.
OpgeletAntwoord T7 — open na je eigen poging
Een correct Venn-diagram heeft drie X-cirkels die elkaar deels overlappen, en een Y-cirkel die met elk van hen overlapt. Wat in jouw tekening klopt:
Totaal — al het Y-gebied dat in enige X-cirkel zit.
Uniek per voorspeller — Y-gebied dat alleen in die ene X zit, niet in de andere: denkkunst , leeftijd , zelfgevoel . Samen .
Gedeeld — Y-gebied in twee of drie X’en tegelijk: .
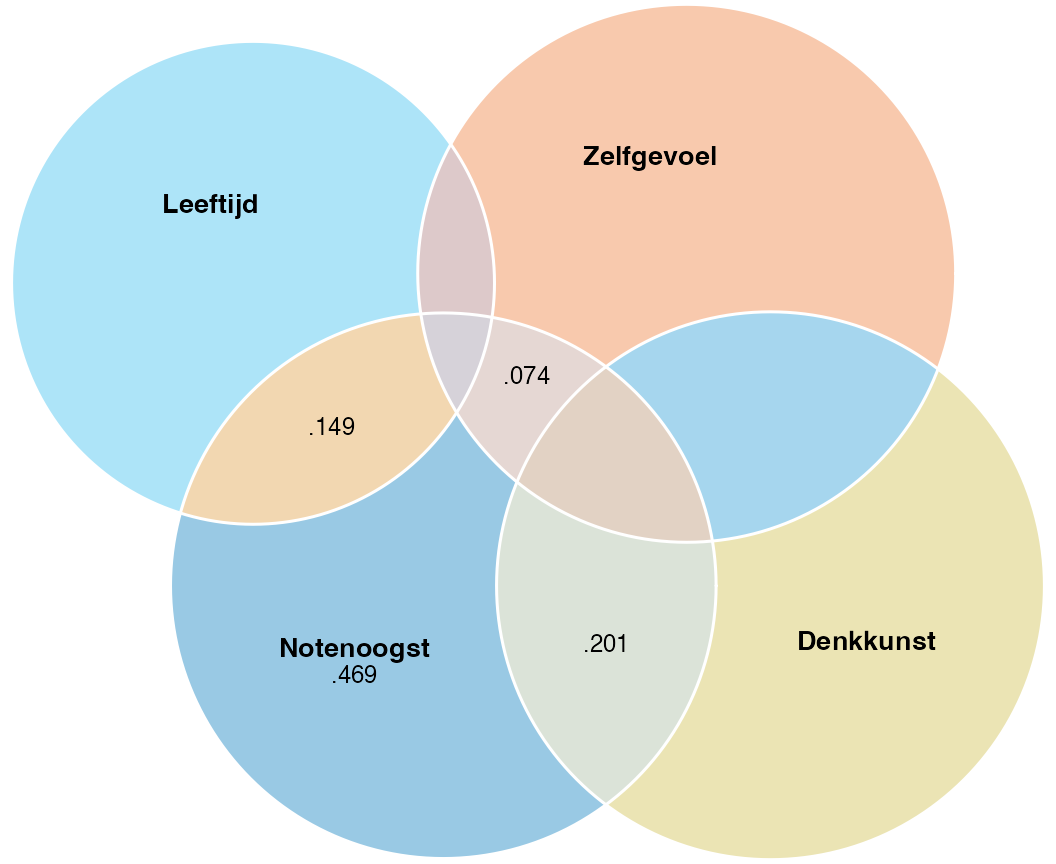
Een referentie-tekening (vier cirkels: notenoogst drie voorspellers) — eulerr plaatst zelf ellipsen waar cirkels niet meer alle relaties kunnen weergeven:
Toon code (tekening van de vier cirkels)
library(eulerr)# Bouwstenen uit T6: kwadraat van de Part-correlaties = unieke VAF per voorspeller.R2_total <-round(summary(lm_bos)$r.squared, 4) # R^2 van het hele modelsr2_d <-round(ols_correlations(lm_bos)$Part[1]^2, 4) # denkkunst, unieksr2_l <-round(ols_correlations(lm_bos)$Part[2]^2, 4) # leeftijd, unieksr2_z <-round(ols_correlations(lm_bos)$Part[3]^2, 4) # zelfgevoel, uniekshared <-round(R2_total - sr2_d - sr2_l - sr2_z, 4) # totaal gedeeld in Yfit4 <-euler(c("Notenoogst"=1- R2_total, # Y_only = 1 - R^2"Denkkunst"=0.5000,"Leeftijd"=0.5500,"Zelfgevoel"=0.5500,"Notenoogst&Denkkunst"= sr2_d, # uniek door denkkunst"Notenoogst&Leeftijd"= sr2_l, # uniek door leeftijd"Notenoogst&Zelfgevoel"= sr2_z, # uniek door zelfgevoel"Denkkunst&Leeftijd"=0.0500,"Denkkunst&Zelfgevoel"=0.2000, # X-X overlap (sterkste: r=.56)"Leeftijd&Zelfgevoel"=0.0500,# De vier gedeelde stukken (twee- en drievoudig in Y) tellen samen op tot `shared`.# We verdelen ze hier indicatief — eulerr zoekt zelf het beste compromis."Notenoogst&Denkkunst&Leeftijd"=0.0200,"Notenoogst&Denkkunst&Zelfgevoel"=0.0700, # grootste gedeelde stuk in Y"Notenoogst&Leeftijd&Zelfgevoel"=0.0100,"Notenoogst&Denkkunst&Leeftijd&Zelfgevoel"= shared -0.0200-0.0700-0.0100))# Alleen notenoogst-zonder-voorspellers en de drie unieke stukken zijn getallen# uit de data; de X-vlakken en de verdeling van het gedeelde stuk zijn tekenmaat# en krijgen geen getal. Drie decimalen, zoals T6 en het bijschrift.lab4 <-setNames(rep("", length(fit4$original.values)), names(fit4$original.values))echt4 <-c("Notenoogst", "Notenoogst&Denkkunst", "Notenoogst&Leeftijd","Notenoogst&Zelfgevoel")lab4[echt4] <-drie(fit4$original.values[echt4])plot(fit4,fills =list(fill =c("#0077BB", "#CCBB44", "#33BBEE", "#EE7733"), alpha =0.40),labels =list(col ="black", font =2, cex =0.85),quantities =list(labels =unname(lab4), cex =0.75),edges =list(col ="white", lwd =1.5))
Figuur 3: Vier sets — totaal ; uniek denkkunst , leeftijd , zelfgevoel ; gedeeld .
De getekende oppervlaktes wijken licht af van de exacte gewenste waarden — eulerr zoekt het beste compromis als niet alle relaties tegelijk in een platte tekening passen. Inhoudelijk klopt de boodschap: drie unieke maantjes binnen van afnemende grootte (), en daartussen een gedeeld middelpunt waar verklaringen elkaar overlappen.
Nuance. Aannames-schendingen veranderen de schatting van (en dus de oppervlakten in jouw Venn) niet — die blijft onbevooroordeeld. Wat schendingen wél veranderen zijn de standaardfouten rondom die schattingen. Conclusies over significantie kunnen dus fout uitvallen, terwijl de getekende Venn op zich klopt.
T8 — Decompositie via twee paden
OpmerkingVraag T8 — Pen-en-papier (vervlochten)
Een ander pad om op te bouwen is sequentieel: eerst de zero-order verklaring van één voorspeller, daarna de unieke toevoeging van de volgende.
Voor twee voorspellers (denkkunst en leeftijd, met zelfgevoel even buiten beschouwing) zou er moeten gelden:
waarbij het tweede stuk de gekwadrateerde semipartial is — wat uniek toevoegt na .
a) Spiegel ook geldt: Beide kanten moeten hetzelfde opleveren. Toets dit met de chunk hieronder.
b) Voer de chunk uit: hij schat het tweepredictoren-model en print de twee paden.
Toon code (de twee paden)
m12 <-lm(notenoogst ~ denkkunst + leeftijd, data = bos_dieren)# Totaal R^2 van het tweepredictoren-modelr2_totaal <-summary(m12)$r.squared# Pad 1: zero-order denkkunst + semipartial leeftijd | denkkunstsp_lt <-ols_correlations(m12)$Part[2]pad_1 <-cor(bos_dieren$notenoogst, bos_dieren$denkkunst)^2+ sp_lt^2# Pad 2: zero-order leeftijd + semipartial denkkunst | leeftijdsp_dk <-ols_correlations(m12)$Part[1]pad_2 <-cor(bos_dieren$notenoogst, bos_dieren$leeftijd)^2+ sp_dk^2c(R2_totaal = r2_totaal, pad_1 = pad_1, pad_2 = pad_2)
Beide paden landen op hetzelfde (op afrondverschillen na). Dat is geen toeval: de decompositie van verklaarde variantie kan langs verschillende routes, maar de eindbestemming ligt vast.
Inhoudelijk: zero-order omvat alles wat verklaart inclusief eventuele overlap met . De semipartial vult dan precies aan met wat uniek toevoegt — geen dubbeltelling. Hetzelfde langs de andere route. De totale taart is even groot; je kunt hem alleen anders snijden.
TipWat de eekhoorn over de Part-kolom zei
“De Part-correlatie is de eerlijkste maat van wie wat doet. Hij vraagt: hoeveel van de notenoogst verklaart juist déze voorspeller, ná aftrek van wat de anderen al deden? Het kwadraat ervan is precies de unieke proportie variantie.”
1.2 Modelaanpassing na verwijdering van een invloedspunt
De vergeten case
Een paar dagen later kwam de mier weer langs. “Eekhoorn, ik denk dat er een dier in onze gegevens staat dat er eigenlijk niet hoort. De onderzoeker zelf had ooit de vragenlijst ingevuld om hem uit te proberen, en vergat zijn eigen score eruit te halen.”
In onderzoek mag je niet zomaar uitschieters weghalen — maar als de reden buiten je hypothese ligt, mag het soms.
BelangrijkDon’t: uitschieters weghalen omdat ze niet bevallen
Een uitschieter weghalen is een morele beslissing, niet alleen een statistische.
Niet doen: een case verwijderen omdat hij je hypothese tegenwerkt, of omdat je -waarde net niet onder uitkomt. Dat is p-hacking.
Niet doen: alle cases met blind verwijderen.
Mag wel: een case verwijderen om een reden die buiten je hypothese ligt — meetfout, dataregistratiefout, of (zoals hier) een proefonderwerp dat niet in de populatie thuishoort.
Verplicht erbij: in je verslag expliciet melden welke case je hebt verwijderd, waarom, en wat het effect was. Niet stilletjes.
OpmerkingWaarom Cook’s distance, niet alleen stdres
De vergeten case heeft een gestandaardiseerd residu dat onschuldig lijkt. Hoe kan dat? Omdat hij zoveel leverage heeft dat de regressielijn naar hém toe getrokken is. Pas Cook’s distance — die residu en leverage combineert — onthult zijn invloed.
Algemene vorm.
# Welke cases hebben extreme invloed?boosdoener_idx <-which(mijn_data$cd >1)# Wat staat er in die regeltjes?mijn_data[boosdoener_idx, ]# Schat het model opnieuw, zonder de uitschieter(s)mijn_data_schoon <- mijn_data[-boosdoener_idx, ]mijn_model_schoon <-lm(Y ~ X1 + X2 + X3, data = mijn_data_schoon)summary(mijn_model_schoon)ols_correlations(mijn_model_schoon)
mijn_data[i, ] betekent: pak rij i, alle kolommen. Met [-boosdoener_idx, ] doe je het omgekeerde — alle rijen behálve die. De komma is essentieel.
# Het lijstje zonder de vergeten case.bos_dieren_schoon <- bos_dieren[-boosdoener_idx, ]
# filter() houdt alleen de rijen waarvoor de voorwaarde klopt. Het rijnummer# zet je er zelf bij met row_number(): dplyr bewaart geen rijnamen, en zonder# die kolom zie je niet welk dier het is.bos_dieren |>mutate(rij =row_number()) |>filter(cd >1)
Call:
lm(formula = notenoogst ~ denkkunst + leeftijd + zelfgevoel,
    data = bos_dieren_schoon)

Residuals:
    Min      1Q  Median      3Q     Max
-35.003  -6.321   1.351   9.371  24.232

Coefficients:
            Estimate Std. Error t value   Pr(>|t|)
(Intercept) -28.3021    39.5355  -0.716     0.4765
denkkunst     0.6831     0.1392   4.909 0.00000589 ***
leeftijd     -0.4317     2.7774  -0.155     0.8769
zelfgevoel    0.4757     0.1397   3.406     0.0011 **
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 12.76 on 69 degrees of freedom
Multiple R-squared:  0.5307,    Adjusted R-squared:  0.5103
F-statistic: 26.01 on 3 and 69 DF,  p-value: 0.00000000002287
ols_correlations(lm_bos_schoon)
                Correlations
---------------------------------------------
Variable      Zero Order    Partial     Part
---------------------------------------------
denkkunst          0.672      0.509     0.405
leeftijd          -0.265     -0.019    -0.013
zelfgevoel         0.586      0.379     0.281
---------------------------------------------
Vergelijk de output met die van lm_bos. Wat verandert? ? De individuele coëfficiënten? De significantie?
OpmerkingVragen 1.2
a) Welk dier is verwijderd? Wat zie je aan zijn scores dat hem afwijkend maakt?
b) Wat verandert er aan en de individuele coëfficiënten zonder hem?
c) Welke conclusie zou je rapporteren — mét of zonder hem? En waarom?
OpgeletAntwoord 1.2 — open na je eigen poging
In gewone woorden.
Eén case (rij 18) is verwijderd. Zijn scores: notenoogst , denkkunst , leeftijd , zelfgevoel . Leeftijd ligt ver boven het bereik van de andere dieren (–), en de combinatie van een hoge notenoogst met lage denkkunst en zeer laag zelfgevoel past bij geen van de andere patronen.
De verklaarde variantie verandert nauwelijks ( blijft ), maar in de afzonderlijke coëfficiënten gebeurt iets opvallends: leeftijd valt weg als significante voorspeller (, ), en het teken van flipt zelfs van positief () naar nipt negatief (). Denkkunst en zelfgevoel blijven overeind, beide nog steeds met een positief verband.
De juiste conclusie is die zonder de boosdoener: leeftijd voorspelt notenoogst niet, alleen denkkunst en zelfgevoel doen dat. Verwijderen mag hier omdat de reden buiten de hypothese ligt: de vergeten testscore van de onderzoeker zelf, geen echt dier.
Daarmee is ook de suppressor van Suppressie — waarom het gedeelde stuk negatief kan worden weg. Zonder dit dier verklaart leeftijd uniek vrijwel niets meer (, tegen een eigen van ), en zijn zero-order correlatie met de notenoogst is zelfs negatief geworden (). Het hele suppressie-effect rustte op één dier.
APA-stijl.
Eén invloedrijke case werd op grond van Cook’s distance, , en bekende meetfout uit de analyse verwijderd. Het gecorrigeerde model bleef statistisch significant, , , . Bij dieren die op de andere voorspellers vergelijkbaar waren, hingen een hogere denkkunst, , , , , en een hoger zelfgevoel, , , , , beide positief samen met een hogere notenoogst. Het oorspronkelijke positieve effect van leeftijd was niet langer aanwezig, , , , en kon volledig worden toegeschreven aan de invloed van de verwijderde case.
1.3 Hiërarchische regressie-analyse
Het zelfvertrouwen van de schildpad
De schildpad zat aan de rand van de vijver en dacht na. Hij dacht na over de vraag of hij wel echt geloofde dat hij iets kon. Lag het aan zijn leeftijd? Aan hoe hij over zichzelf dacht? Of misschien aan hoe vaak hij zich zorgen maakte? Of aan hoe vrolijk hij was?
In een groter onderzoek vroegen onderzoekers aan honderdzevenentachtig dieren hoeveel zelfvertrouwen ze hadden, hoe oud ze waren, of ze het gevoel hadden zelf aan het roer te staan (stuurgevoel), hoe vaak ze tobberden (tobberigheid), en hoe uitbundig ze in het bos rondliepen (uitbundigheid).
Algemene vorm. Hiërarchische regressie hierarchical regression betekent: je bouwt het model laag voor laag op, op grond van wat de theorie zegt. Per laag gebruik je anova(model_klein, model_groter) om te toetsen of de extra voorspellers iets toevoegen — een modelvergelijking model comparison.
m1 <-lm(Y ~ X1, data = mijn_data)m2 <-lm(Y ~ X1 + X2, data = mijn_data)m3 <-lm(Y ~ X1 + X2 + X3 + X4, data = mijn_data)anova(m1, m2) # voegt X2 iets toe?anova(m2, m3) # voegen X3 en X4 samen iets toe?
Voor onze dieren.
# Tweede dataset: ~187 dieren bij de vijver, vijf variabelen per dier.load("data/zelfvertrouwen_van_de_schildpad.RData")# Wat zit erin?str(vijver_dieren)
'data.frame':   187 obs. of  5 variables:
 $ zelfvertrouwen: num  8.97 6.02 4.39 8.4 6.44 ...
 $ leeftijd      : num  51 60 53 56 49 46 58 45 52 53 ...
 $ stuurgevoel   : num  8.49 6 4.98 6.59 7.38 ...
 $ tobberigheid  : num  9.51 5.46 6.62 8.8 7.46 ...
 $ uitbundigheid : num  3.81 5.1 3.97 5.81 5.94 ...
Stap 1 Enkelvoudig regressiemodel
Alleen stuurgevoel
m1 <-lm(zelfvertrouwen ~ stuurgevoel, data = vijver_dieren)summary(m1)
Call:
lm(formula = zelfvertrouwen ~ stuurgevoel, data = vijver_dieren)

Residuals:
   Min     1Q Median     3Q    Max
-4.914 -1.079  0.213  1.175  3.555

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept)  2.48954    0.53621   4.643 6.50e-06 ***
stuurgevoel  0.77044    0.08856   8.700 1.79e-15 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 1.579 on 185 degrees of freedom
Multiple R-squared:  0.2903,    Adjusted R-squared:  0.2865
F-statistic: 75.69 on 1 and 185 DF,  p-value: 1.788e-15
OpmerkingVragen 1.3 — stap 1
a) Kan de nul “geen samenhang tussen zelfvertrouwen en stuurgevoel” verworpen worden? Rapporteer , en .
b) Wat is de regressievergelijking?
c) Hoeveel variantie van zelfvertrouwen verklaart stuurgevoel?
De vergelijking is . Per punt stuurgevoel ongeveer punt zelfvertrouwen erbij.
Het verklaart .
APA-stijl.
Stuurgevoel hing positief samen met zelfvertrouwen: dieren met een hoger stuurgevoel rapporteerden gemiddeld meer zelfvertrouwen, , , . De geschatte regressievergelijking was , , , , .
Stap 2 Twee voorspellers
Voeg tobberigheid toe
m2 <-lm(zelfvertrouwen ~ stuurgevoel + tobberigheid, data = vijver_dieren)# Voegt tobberigheid significant variantie toe ten opzichte van m1?anova(m1, m2)
Analysis of Variance Table

Model 1: zelfvertrouwen ~ stuurgevoel
Model 2: zelfvertrouwen ~ stuurgevoel + tobberigheid
  Res.Df    RSS Df Sum of Sq      F    Pr(>F)
1    185 461.38
2    184 261.57  1    199.81 140.56 < 2.2e-16 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
summary(m2)
Call:
lm(formula = zelfvertrouwen ~ stuurgevoel + tobberigheid, data = vijver_dieren)

Residuals:
    Min      1Q  Median      3Q     Max
-3.1723 -0.8187  0.1624  0.8071  2.5799

Coefficients:
             Estimate Std. Error t value  Pr(>|t|)
(Intercept)   1.75535    0.40954   4.286 0.0000293 ***
stuurgevoel   0.20143    0.08230   2.447    0.0153 *
tobberigheid  0.61011    0.05146  11.856   < 2e-16 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 1.192 on 184 degrees of freedom
Multiple R-squared:  0.5977,    Adjusted R-squared:  0.5933
F-statistic: 136.7 on 2 and 184 DF,  p-value: < 2.2e-16
OpmerkingVragen 1.3 — stap 2
d) Verbetert het toevoegen van tobberigheid het model significant? Rapporteer , en .
e) Interpreteer de regressiecoëfficiënten van .
f) Hoeveel variantie verklaren stuurgevoel en tobberigheid samen? En hoeveel verklaart tobberigheid alleen?
OpgeletAntwoord 1.3 — open na je eigen poging
In gewone woorden.
Tobberigheid voegt veel toe: , .
In blijft stuurgevoel significant maar zwakker dan eerder (, , , positief). Tobberigheid is sterk en óók positief: per punt tobberigheid stijgt zelfvertrouwen met punt — bij dieren met een vergelijkbaar stuurgevoel (, ). Vreemd genoeg gaat zelfvertrouwen omhoog met tobberigheid in deze (gefingeerde) gegevens — een patroon dat in de echte literatuur vaak andersom ligt; let bij interpretatie altijd op richting.
Samen verklaren ze . Stuurgevoel alleen verklaarde , dus tobberigheid voegt uniek toe.
APA-stijl.
Het toevoegen van tobberigheid aan het model verbeterde de fit significant, , , . In het volledige tweepredictoren-model voorspelden beide voorspellers zelfvertrouwen positief, telkens bij dieren die op de andere voorspeller vergelijkbaar waren. Een hoger stuurgevoel hing samen met meer zelfvertrouwen, , , . Hetzelfde gold voor tobberigheid, , , . Samen verklaarden zij van de variantie, .
Stap 3 Volledig model
Voeg leeftijd en uitbundigheid toe
m3 <-lm(zelfvertrouwen ~ stuurgevoel + tobberigheid + leeftijd + uitbundigheid,data = vijver_dieren)# Voegen leeftijd + uitbundigheid samen iets toe ten opzichte van m2?anova(m2, m3)
Analysis of Variance Table

Model 1: zelfvertrouwen ~ stuurgevoel + tobberigheid
Model 2: zelfvertrouwen ~ stuurgevoel + tobberigheid + leeftijd + uitbundigheid
  Res.Df    RSS Df Sum of Sq      F Pr(>F)
1    184 261.57
2    182 257.92  2    3.6511 1.2882 0.2783
summary(m3)
Call:
lm(formula = zelfvertrouwen ~ stuurgevoel + tobberigheid + leeftijd +
    uitbundigheid, data = vijver_dieren)

Residuals:
    Min      1Q  Median      3Q     Max
-3.1311 -0.7566  0.1303  0.7622  2.4150

Coefficients:
              Estimate Std. Error t value Pr(>|t|)
(Intercept)    2.03474    0.72352   2.812  0.00546 **
stuurgevoel    0.20166    0.08438   2.390  0.01787 *
tobberigheid   0.58553    0.05483  10.678  < 2e-16 ***
leeftijd      -0.01134    0.01501  -0.755  0.45115
uitbundigheid  0.09717    0.06298   1.543  0.12458
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 1.19 on 182 degrees of freedom
Multiple R-squared:  0.6033,    Adjusted R-squared:  0.5946
F-statistic: 69.19 on 4 and 182 DF,  p-value: < 2.2e-16
OpmerkingVraag 1.3 — stap 3
g) Verbeteren leeftijd en uitbundigheid samen het model significant? Rapporteer , en .
OpgeletAntwoord 1.3 — open na je eigen poging
In gewone woorden. Nee. De anova(m2, m3) geeft , . Leeftijd en uitbundigheid voegen samen niets significants toe ná stuurgevoel en tobberigheid. De zuinige conclusie: het model met alleen stuurgevoel en tobberigheid is voldoende.
APA-stijl.
Het toevoegen van leeftijd en uitbundigheid verbeterde de fit niet significant, , , . Op basis van het hiërarchische beslismoment werd (stuurgevoel + tobberigheid) als finaal model gerapporteerd.
TipStepwise regressie — niet als routine
Hiërarchisch betekent dat jij op grond van de theorie bepaalt in welke volgorde de voorspellers binnenkomen. Stepwise betekent dat je dat aan het algoritme overlaat — en dat moet je meestal niet doen.
Toch is het goed om het één keer met de hand te doen, achterwaarts, zodat je ziet wat zo’n algoritme eigenlijk doet. Zoek in summary() de voorspeller met de grootste -waarde, haal hem uit de formule en schat het model opnieuw — bijvoorbeeld lm(Y ~ X1 + X3, data = mijn_data) als X2 de minst significante was. Herhaal dat tot alleen significante voorspellers over zijn. De nieuwe regressievergelijking schrijf je op uit dat nieuwe model — niet door een term uit de oude vergelijking te schrappen, want als één voorspeller verdwijnt, veranderen de ’s van de andere ook.
Twee kanttekeningen. Een niet-significante voorspeller is niet per se onbelangrijk: hij kan hetzelfde zeggen als een andere voorspeller in het model (zie Multicollineariteit zonder R). En stapsgewijs werken vraagt veel waarnemingen per voorspeller: , met het aantal voorspellers. Het bos haalt dat niet: dieren en voorspellers is ongeveer per voorspeller. In een opgave doe je wat de opgave vraagt; in je eigen onderzoek kies je liever hiërarchisch, op grond van de theorie.
TipEerst de , dan pas de ’s
Met voorspellers doe je losse -toetsen, en elke toets heeft zijn eigen kans op vals alarm. Daarom werkt de -toets van het hele model hier als poortwachter: pas als die significant is, kijk je naar de -toetsen per voorspeller. Is de -toets niet significant, dan stop je daar — dan voorspellen deze voorspellers samen niet beter dan het toeval.
OpmerkingVoor wie verder wil — corrigeren voor meerdere -toetsen
Bij per toets is de kans dat minstens één van onafhankelijke toetsen vals alarm geeft groter dan — bij vijf voorspellers .
Wat doen?
Bij theoriegestuurde MRA (vooraf gespecificeerde voorspellers): meestal geen correctie — je toetst gerichte hypotheses, niet exploratief.
Bij exploratieve MRA (data-gedreven voorspeller-keuze, stepwise, all-subsets): wél corrigeren. Bonferroni () is de eenvoudigste; Holm-Bonferroni is krachtiger. Allebei komen ze terug in thema 5, bij MANOVA.
Bij hiërarchische modelvergelijking: één -toets per stap, geen correctie nodig zolang de stappen vooraf zijn gespecificeerd.
Vuistregel: hoe meer “vissen” in de data, hoe strenger corrigeren. In R corrigeer je een rij -waarden met p.adjust():
# Trek de p-waarden van de voorspellers uit de summary-tabel. De [-1, ]# laat de rij van het intercept weg: dat is geen voorspeller, en anders# corrigeer je voor k + 1 toetsen in plaats van k.p_vector <-summary(lm_bos)$coefficients[-1, "Pr(>|t|)"]# Bonferroni: alpha / k, eenvoudigste correctie.p_bonf <-p.adjust(p_vector, method ="bonferroni")# Holm-Bonferroni: krachtiger dan Bonferroni, controleert FWER.p_holm <-p.adjust(p_vector, method ="holm")# Benjamini-Hochberg: controleert de False Discovery Rate (FDR).p_bh <-p.adjust(p_vector, method ="BH")
T10 — Wanneer is een model “useless”?
OpmerkingVraag T10 — Pen-en-papier
R rapporteert standaard zowel als adjusted (). De adjusted versie corrigeert voor het aantal voorspellers en de steekproefgrootte. Een veelgebruikte vorm is de Wherry-formule:
waarbij de steekproefgrootte is en het aantal voorspellers.
a) Bereken voor , , .
b) Wat valt je op? Hoe groot is het verschil tussen en ?
c) Tabachnick & Fidell (2007) en Stevens (2009) adviseren een verhouding : minimaal twintig observaties per voorspeller. Wanneer kun je een regressievergelijking “useless” noemen volgens dit advies?
OpgeletAntwoord T10 — open na je eigen poging
a)
b) Het verschil is klein (, ongeveer ). Bij — ruim boven de drempel van — corrigeert Wherry licht. Bij krappere (bv. , ) wordt de correctie veel forser en zakt aanzienlijk onder .
c) Een regressie wordt onbruikbaar als klein is: te weinig observaties per voorspeller om de coëfficiënten betrouwbaar te schatten. Wij hanteren (Tabachnick & Fidell, 2007; Stevens, 2009), en bij stepwise procedures de strengere (Cohen & Cohen, 1983). Een model met en () is zo’n geval: kan hoog zijn door overfitting, duikt diep, en in een nieuwe steekproef stort het in. Useless.
1.4 Dummy-codering — een categorische voorspeller in je regressie
De mier kijkt nog eens naar zijn lijstje. “Ik heb tot nu toe alleen getallen genomen. Maar wat als ik ook wilde weten of het soort dier uitmaakt — eekhoorn, mier, kraai?”
Tot nu toe waren al je voorspellers in bos_dierencontinue: denkkunst, leeftijd, zelfgevoel — getallen met afstand en richting. Maar wat als je ook wilt meenemen of een dier een eekhoorn, een mier of een kraai is? Dat is geen getal. Het is een nominale variabelenominal variable — een factor in R-taal, drie categorieën zonder volgorde.
Stel, je wilt een nominale voorspeller (factor) tóch in een regressie knallen — maar regressie wil eigenlijk continue voorspellers, jaja, daar heb je weer zo’n woord. Geef je het dan maar op? Nee dummy. Je gaat dummy-coderen.
Het idee: drie categorieën zet je om in dummy-variabelen. Voor elke dummy kies je één categorie — bijvoorbeeld mier — en je zet een bij elke rij waar die categorie waar is en een waar dat niet waar is. Eentje voor “alweer waar”, nulletje voor “niet”. Bij de volgende dummy hetzelfde voor een andere categorie. Twee dummies samen vertellen R precies bij welke groep een dier hoort — de derde groep heeft géén eigen kolom, want die kan R afleiden uit de andere twee. De derde groep heet daarmee impliciet de referentiegroepreference group, en dat tabelletje noemen ze dan een contrast-matrix, mijn god.
Stel we kiezen mier als en kraai als — dan wordt eekhoorn de referentiegroep ():
mier
1
0
kraai
0
1
eekhoorn
0
0
R noemt de twee kolommen soortmier en soortkraai. Eekhoorn krijgt geen eigen kolom — hij is de referentie tegen wie de andere twee gemeten worden.
De regressievergelijking voor de notenoogst wordt dan:
Snap je hem al?
Nog niet helemaal? Geen drama — kijken we even wat , en feitelijk zijn onder deze codering (de R-default heet contr.treatment — treatment = behandelings-codering, want één groep is de “controle” / referentie).
Wat de coefficienten betekenen:
(Intercept) () — de voorspelde notenoogst van een eekhoorn (de referentiegroep) als alle continue voorspellers op nul staan. Vaak fysiek niet zinvol (een dier met denkkunst bestaat niet); wiskundig wel: het anker waaraan de andere coefficienten gehangen worden.
soortmier () — het verschil in voorspelde notenoogst tussen mier en eekhoorn, bij gelijke denkkunst, leeftijd en zelfgevoel. Negatief getal: mieren oogsten minder dan eekhoorns na correctie voor de andere voorspellers. Positief: meer.
soortkraai () — idem: verschil tussen kraai en eekhoorn, bij gelijke andere voorspellers.
Het verschil tussen mier en kraai kun je zelf afleiden: (kraai minus mier — let op de richting).
Zie je de object-altijd-erbij-regel voorbijkomen? “Effect van soortmier” zonder “op notenoogst” zegt niets. “Verschil” zonder “in notenoogst” zegt niets. Bij elke dummy-coefficient blijft de Y er expliciet bij — anders verzwakt de hele uitleg.
TipCodeer lekker zelf — dan weet je ook wie je ref is
Hierboven kozen we eekhoorn als referentiegroep. Dat is niet wat R automatisch doet. Laat je R zijn gang gaan, dan ordent hij de factor-niveaus alfabetisch — eekhoorn / kraai / mier — en pakt de eerste in de lijst als referentie. Dat is in dit geval toevallig eekhoorn, maar in andere data kan het iets totaal anders zijn. Resultaat: je weet niet zeker welke groep welke kolom is, en welke groep de referentie wordt. Vervelend voor de interpretatie van soortX en soortY, en een prima recept voor hand-rekenfouten: wie de volgorde aan R overlaat en daarna zelf bepaalt welke coëfficiënt bij welke groep hoort, komt bij emmeans() (thema 3) uit op getallen die niet met elkaar te rijmen zijn.
Vuistregel: codeer lekker zelf. Eén regel R, vóór je het model fit:
# `bos_dieren` heeft geen kolom `soort`; dit is de vorm voor data die er wél een heeft.mijn_data$soort <-factor( mijn_data$soort,levels =c("eekhoorn", "mier", "kraai"))
# Hetzelfde binnen mutate(): de kolom soort wordt vervangen door zichzelf,# nu als factor met de volgorde die jij kiest.mijn_data <- mijn_data |>mutate(soort =factor(soort, levels =c("eekhoorn", "mier", "kraai")))
De eerste in de lijst wordt nu de referentie (eekhoorn), en de andere twee komen in summary() als soortmier en soortkraai — precies in die volgorde, niet alfabetisch. Geen verrassingen meer in summary(lm)-output. Bonus: bij de interpretatie weet jij ook welke groep je in je kop als anker hebt.
Zelfs als je R de boel laat ordenen valt het meestal mee — totdat het meeloopt. Dan ben je tijd kwijt aan iets dat in één regel R was op te lossen.
Hoeveel categorieën, hoeveel dummies? Vuistregel: . Twee soorten? Eén dummy. Drie soorten? Twee dummies (zoals hier). Tien soorten? Negen dummies, en je R-output wordt een ellende — bij veel categorieën overweeg je een ander modeltype (random effects, multilevel).
Wat hier nog níet behandeld is:
Hoe twee dummies samen werken in een interactie — komt in thema 2 (factorial ANOVA), waar je niet één maar twee factoren tegelijk hebt en hun interactie expliciet modelleert.
Andere coderings-keuzes dan de “één-referentie”-codering — komt in thema 2 (ANOVA), waar we contr.sum (sum-to-zero coding) tegenkomen, en daarna weer in thema 3 (ANCOVA). Daar wordt (Intercept) ineens géén referentie-mean meer maar een grand mean, en de derde groep krijgt in plaats van . Zelfde wiskunde, andere parametrisering — en een paar didactische voordelen bij Type-III ANOVA.
Voor nu: één-referentie-codering, R-default, eekhoorn als anker. Klein principe, groot rendement bij elke nieuwe analyse waar een factor mee mag doen.
R-spiekblad bij MRA
Alle commando’s op één plek
Alle R-commando’s die je voor MRA nodig hebt, op één plek — zodat je niet door het hele hoofdstuk hoeft te bladeren als je iets wilt opzoeken.
Pakketten en data laden
# Pakketten activeren — één keer per sessie.library(car) # voor vif()library(olsrr) # voor ols_correlations()library(tidyverse) # alleen nodig als je de dplyr-tabbladen volgt# Eerste dataset laden — object 'bos_dieren' verschijnt vanzelf.load("data/notenoogst_in_het_bos.RData")# Tweede dataset laden — object 'vijver_dieren' verschijnt vanzelf.load("data/zelfvertrouwen_van_de_schildpad.RData")# Snelle inkijk: structuur, kolommen, types, eerste waarden.str(bos_dieren)# Per kolom het type opvragen — moet 'numeric' zijn om mee te rekenen.sapply(bos_dieren, class)
Verkenning van de data
# Aantal cases (rijen) in de dataset.NROW(bos_dieren)# Pearson-correlatiematrix tussen alle variabelen, drie decimalen.# Lees: neem bos_dieren, bereken dan cor(), rond dan af op 3 decimalen.bos_dieren |>cor() |>round(3)
Model fitten en samenvatten
# Lineair model fitten — formule = uitkomst ~ voorspellers.lm_bos <-lm(notenoogst ~ denkkunst + leeftijd + zelfgevoel, data = bos_dieren)# Coëfficiënten, R-squared, F-toets, t-toetsen — alles in één.summary(lm_bos)
Multicollineariteit
# VIF per voorspeller — vuistregel: VIF >= 10 is een probleem.vif(lm_bos)
# Residuals vs Fitted: lineariteit en gelijke spreiding controleren.plot(lm_bos, which =1)# Q-Q-plot: normaal verdeelde residuen controleren.plot(lm_bos, which =2)
Outliers en invloed
# Drie diagnostiek-statistieken als kolommen toevoegen aan de data.bos_dieren$stdres <-rstandard(lm_bos) # gestandaardiseerd residubos_dieren$leverage <-hatvalues(lm_bos) # leverage (afstand tot voorspeller-zwaartepunt)bos_dieren$cd <-cooks.distance(lm_bos) # Cook's distance (totale invloed)# Drempelwaarde leverage: 3 * (k + 1) / N met k = aantal voorspellers.k <-3N <-nrow(bos_dieren)3* (k +1) / N# Min/max/quartielen van de drie statistieken — eerste blik op extremen.summary(bos_dieren[, c("stdres", "leverage", "cd")])# Vuistregels: |stdres| > 3, leverage > 3(k+1)/N, Cook's distance > 1.# Welke case(s) hebben Cook's distance boven 1?boosdoener_idx <-which(bos_dieren$cd >1)# Inspecteer die rij — welke scores maken hem afwijkend?bos_dieren[boosdoener_idx, ]# Schat het model opnieuw zonder de invloedrijke case(s).bos_dieren_schoon <- bos_dieren[-boosdoener_idx, ]lm_bos_schoon <-lm(notenoogst ~ denkkunst + leeftijd + zelfgevoel,data = bos_dieren_schoon)summary(lm_bos_schoon)
VAF en correlatie-decompositie
# Drie correlaties per voorspeller: zero-order, partial, part.# Kwadrateer de Part-kolom voor de unieke proportie variantie.ols_correlations(lm_bos)
Hiërarchische modelvergelijking (1.3)
# Bouw het model laag voor laag op — volgorde komt uit de theorie, niet uit een algoritme.m1 <-lm(zelfvertrouwen ~ stuurgevoel, data = vijver_dieren)m2 <-lm(zelfvertrouwen ~ stuurgevoel + tobberigheid, data = vijver_dieren)m3 <-lm(zelfvertrouwen ~ stuurgevoel + tobberigheid + leeftijd + uitbundigheid,data = vijver_dieren)# Voegt tobberigheid significant toe ten opzichte van m1?anova(m1, m2)# Voegen leeftijd + uitbundigheid samen iets toe ten opzichte van m2?anova(m2, m3)# Coëfficiënten van het gekozen finale model bekijken.summary(m2)
Voorbeeld-tentamenvragen
Even oefenen op tentamen-toon
Onderaan dit hoofdstuk staan vier korte theorievragen in tentamen-stijl en één mini R-opdracht. Geen verhaal-frame meer: hier oefen je zoals op het tentamen. Hou de vuistregels uit dit hoofdstuk paraat: , , leverage , Cook’s distance . Reken op drie decimalen.
Theorie en handreken
OpmerkingVraag E1 — Multicollineariteit
Een biologe wil weten waarom sommige beverdammen beter standhouden dan andere. Ze schat een meervoudige regressie met drie voorspellers en controleert op multicollineariteit. Dit levert de volgende VIF-waarden op.
R
        VIF
X1     1.42
X2    11.83
X3     9.97
Hoeveel van de drie voorspellers vormen volgens de gangbare drempel een probleem voor multicollineariteit?
Geen
Eén
Twee
Drie
OpgeletAntwoord E1 — open na je eigen poging
b) Eén. De gangbare drempel is . Alleen overschrijdt die drempel; ligt eronder, ook al is het er dichtbij.
OpmerkingVraag E2 — uit zero-orders
Een veldecoloog volgt vossen op de Veluwe en modelleert hun jachtsucces () met twee voorspellers en . Zij rapporteert de volgende correlatiematrix.
R
       Y      X1     X2
Y   1.000   0.500  0.400
X1            1.000  0.000
X2                   1.000
Wat is de totale proportie verklaarde variantie van ?
OpgeletAntwoord E2 — open na je eigen poging
c) . Bij onafhankelijke voorspellers () geldt .
OpmerkingVraag E3 — Voorspellers diagnosticeren
In een otter-monitoringsstudie ( dieren, voorspellers) controleert de onderzoeker de data op uitbijters op de residuen, invloedrijke punten en uitbijters op de predictoren. Voor drie verdachte otters zien de diagnostiek-waarden er zo uit (de drempel voor leverage in dit model is ).
R
       std.residuals  leverage  cook's distance
A             3.42       0.08             0.18
B             1.10       0.21             1.34
C             2.85       0.05             0.09
Welke case heeft volgens de gangbare vuistregels de meeste invloed op het model?
Case
Case
Case
Geen van drieën
OpgeletAntwoord E3 — open na je eigen poging
b) Case . Cook’s distance combineert residu en leverage en is dé maat voor totale invloed; is een rode vlag, en ligt daar fors boven. Daarnaast overschrijdt leverage van () de drempel . Case heeft een groot residu maar lage leverage en Cook’s , dus zijn invloed op het hele model is beperkt; blijft onder alle drempels.
OpmerkingVraag E4 — Coëfficiënt interpreteren
Op het kraai-observatorium wordt onderzocht of de oplettendheid van kraaien (schaal –) kan worden voorspeld door nestgrootte (cm), weersgehoor (schaal –) en paargedrag (schaal –). Dit levert de volgende uitvoer op.
Als nestgrootte met cm toeneemt, neemt met punten toe.
Als weersgehoor met punt toeneemt, neemt met punten af.
Als paargedrag met punten toeneemt, neemt met punten toe.
In de populatie hangt een hogere nestgrootte samen met een lagere oplettendheid.
OpgeletAntwoord E4 — open na je eigen poging
a) Als nestgrootte met cm toeneemt, neemt met punten toe. Het regressiegewicht is positief, dus per cm extra nestgrootte gaat met omhoog (bij gelijkblijvende waarden van weersgehoor en paargedrag). De andere opties verwarren teken (b en d: alle drie de ’s zijn hier positief) of vermenigvuldiging (c: bij punten paargedrag hoort , niet ).
R-practical opdrachtje
Het kraai-observatorium
OpmerkingVraag E5 — Mini-MRA bij de kraaien
Het kraai-observatorium meet hoe oplettend kraaien zijn, en wat dat verklaart. Bij een steekproef van kraaien zijn vier kenmerken vastgelegd: oplettendheid (schaal –), nestgrootte (cm), weersgehoor (schaal –) en paargedrag (schaal –). De dataset staat in data/kraai_observatorium.RData en bevat het object kraai_data. Sla je R-commando’s op in één scriptbestand: kraai.R. Gebruik .
a) Kan de van geen relatie tussen oplettendheid en de voorspellers nestgrootte, weersgehoor en/of paargedrag worden verworpen? Rapporteer de toetsstatistiek, de vrijheidsgraden en de p-waarde.
b) Welke voorspellers zijn afzonderlijk significant? Rapporteer per significante voorspeller , , en p-waarde.
c) Is multicollineariteit een probleem? Rapporteer de VIF-waarden en licht je antwoord toe.
d) Heeft één of meer kraaien een Cook’s distance ? Toon de gebruikte code en de hoogste waarde.
b) Alle drie de voorspellers dragen afzonderlijk significant bij: nestgrootte , , ; weersgehoor , , ; paargedrag , , .
c) Multicollineariteit is geen probleem: alle VIFs liggen onder , ruim onder de gangbare drempel van .
d) Maximale Cook’s distance is — geen enkele kraai zit boven de drempel . Geen invloedrijke uitschieters volgens deze maat.
Wat blijft liggen
In een uitgebreidere MRA-behandeling kom je deze onderwerpen tegen — niet uitgewerkt in dit thema. Voor verdere studie:
Interactie tussen continue voorspellers () — modelleert moderatie (“hangt het effect van af van het niveau van ?”). In factorial ANOVA (thema 2) zie je interactie wel, maar dan tussen categorische factoren; in ANCOVA (thema 3) komt factor × covariaat voorbij, maar alleen als parallellism-check (toetsen óf de helling per groep gelijk is), niet als didactische introductie van interactie. Continu × continu interactie blijft daarmee een witte plek in dit oefenboek.
Centreren — vóór analyse de gemiddelden van de voorspellers aftrekken. Maakt het intercept beter interpreteerbaar (gemiddelde bij gemiddelde ) en vermindert multicollineariteit bij interactie-termen of polynomen. Komt in dit oefenboek impliciet voor in de ANCOVA-formule (thema 3), waar covariaat-waarden gecentreerd worden om adjusted means te berekenen, maar wordt nergens als techniek-met-naam besproken. In moderne MRA-handboeken is centreren standaard onderdeel (Cohen, Cohen, West & Aiken, 2003).
Polynomiale termen (, ) — voor systematisch niet-lineaire verbanden tussen voorspeller en uitkomst. Centreren wordt dan extra belangrijk. Dit thema werkt ze niet uit. De gangbare route is een hiërarchische regressie: eerst het model met alleen , dan erbij, en kijken of die stap significant variantie toevoegt (). In thema 6 (RMA) zie je contr.poly als binnen-subject-contrast — dat is een ánder gebruik van het woord “polynomial” (orthogonale contrasten over een ordinale factor) en heeft niets te maken met - of -termen in een regressievergelijking.
Robuuste regressie — alternatief voor outlier-correctie zonder cases weg te gooien (M-estimators, weighted least squares). In dit thema kiezen we voor inspecteren-en-eventueel-verwijderen via Cook’s distance. Komt nergens anders in dit oefenboek aan bod.
Bootstrap-confidence intervals — alternatief voor de klassieke parametrische intervallen, robuust tegen schendingen van normaliteit van de residuen. In thema 7 (Mediation) zie je Sobel-, Aroian- en Goodman-toetsen voor het indirecte effect, maar geen bootstrap-aanpak (à la Hayes-PROCESS).
Multilevel- / mixed-effects modellen — als observaties geclusterd zijn (meerdere metingen per dier, dieren binnen nesten). In thema 6 (RMA) wordt RMA-ANOVA terloops aangewezen als “speciaal geval van een multilevel model met random intercept”, maar de bredere mixed-effects-aanpak (random slopes, geclusterde data buiten herhaalde metingen) komt in dit oefenboek niet aan bod. Bij geclusterde data (zie de aanname onafhankelijkheid van observaties) is een mixed-effects model de juiste route.
Bayesiaanse regressie — alternatief inferentie-frame waarbij coëfficiënten als verdelingen worden geschat in plaats van als puntschatting plus -waarde. Komt nergens in dit oefenboek voor — definitieve blinde vlek.
Voor verdieping: Cohen, Cohen, West & Aiken (2003) — uitgebreide klassieker over MRA, behandelt interactie en centreren expliciet; Field (2018, Discovering Statistics) — leesbaar overzicht; Gelman & Hill (2007) — voor multilevel-modellen.
Aan het eind van de dag
“Het kan,” zei de mier. “Niet alles wat we dachten klopte, maar het meeste wel. En een van de dieren bleek niet eens echt te zijn.”
“Dat verandert dingen.”
“Dat verandert altijd dingen.”
Verantwoording
Dit oefenboek is geschreven voor studenten die multipele regressieanalyse leren via R. De didactische lijnen volgen de gangbare opbouw van Nederlandse universitaire MVDA-cursussen; alle voorbeelden, datasets, vragen en formuleringen in dit hoofdstuk zijn origineel. De gebruikte drempels en formules zijn standaard statistische conventies; verwijzingen naar Tabachnick & Fidell (2007), Stevens (2009) en Cohen & Cohen (1983) volgen de gebruikelijke citaatpraktijk in dit veld.