De correlatie r en de scatterplot
Samenhang tussen twee variabelen · correlation & scatterplot
Vooraf, in één zin: r vat de samenhang tussen twee variabelen samen in één getal, maar alléén de rechtlijnige samenhang — twee totaal verschillende puntenwolken kunnen dezelfde r opleveren, dus lees r nooit zonder de scatterplot ernaast; waarom, staat onderaan bij Wat het niet zegt.
Wat je ziet
In het kort. Een getal tussen −1 en 1, vaak met een p en een interval erachter: r = −.44. Dit is de correlatiecoëfficiënt / correlation coefficient (voluit die van Pearson) — een antwoord op de vraag hangen deze twee dingen samen, en hoe sterk? Het teken zegt de richting (min = de een omhoog, de ander omlaag), de grootte zegt hoe strak de samenhang is.
Dat teken is geen opsmuk maar de halve bevinding: r = .44 en r = −.44 zijn even sterk en vertellen het tegenovergestelde verhaal. Een r die je zonder minteken overschrijft, heb je dus half opgeschreven.
Zo ziet hij eruit in het wild:
Voorbeeldfragment, geschreven in de stijl van een resultatensectie — het artikel bestaat niet.
In this cross-sectional sample of outpatients (N = 68), symptom severity was moderately and negatively associated with sleep quality: patients who slept worse reported more severe complaints, r = −.44, 95% CI [−.62, −.23], p < .001.
Wat er staat
In het kort. r = −.44 is een matige, negatieve samenhang: hoe beter iemand slaapt, hoe lichter de klachten, en omgekeerd. De schaal loopt van −1 (een perfecte dalende lijn) via 0 (geen rechtlijnig verband) naar +1 (een perfecte stijgende lijn). En bij dat getal hoort een plaatje — de scatterplot — want dat is wat r in één cijfer probeert samen te vatten.
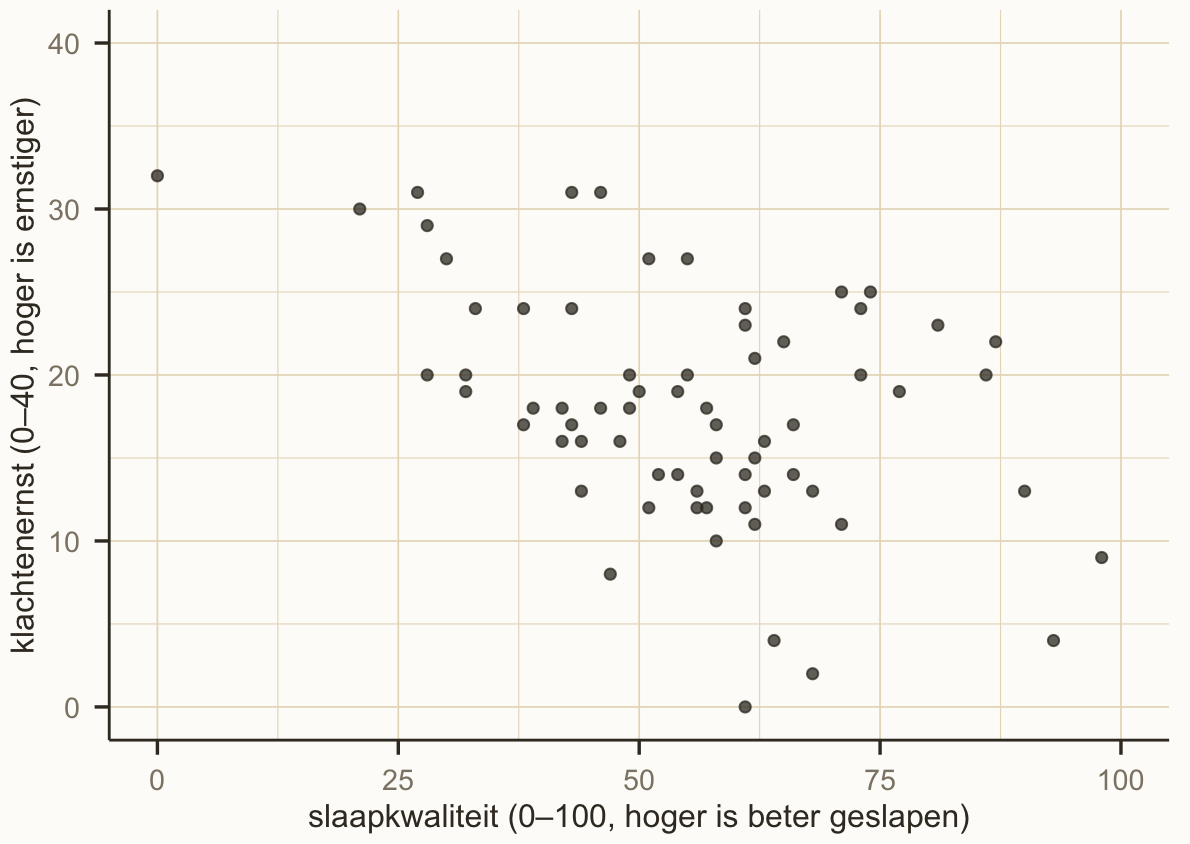
Hier is hij. Kijk er eerst even naar zonder aan het getal te denken.
Nu rustig van voren af aan. Van elke patiënt heb je twee metingen: klachtenernst en slaapkwaliteit. Zet elke patiënt als een stip in een grafiek — ernst op de ene as, slaapkwaliteit op de andere — en je krijgt een wolk van achtenzestig stippen. Loopt die wolk van linksboven naar rechtsonder, dan gaat meer ernst samen met minder goede slaap: een negatief verband. r is één getal voor hoe strák die stippen een rechte, dalende lijn volgen. −.44 is een duidelijke helling met nog flink wat rommel eromheen — geen sliert, geen willekeur, iets ertussenin.
Leg nu de lijn erover. Dezelfde wolk, dezelfde assen, één laag erbij:
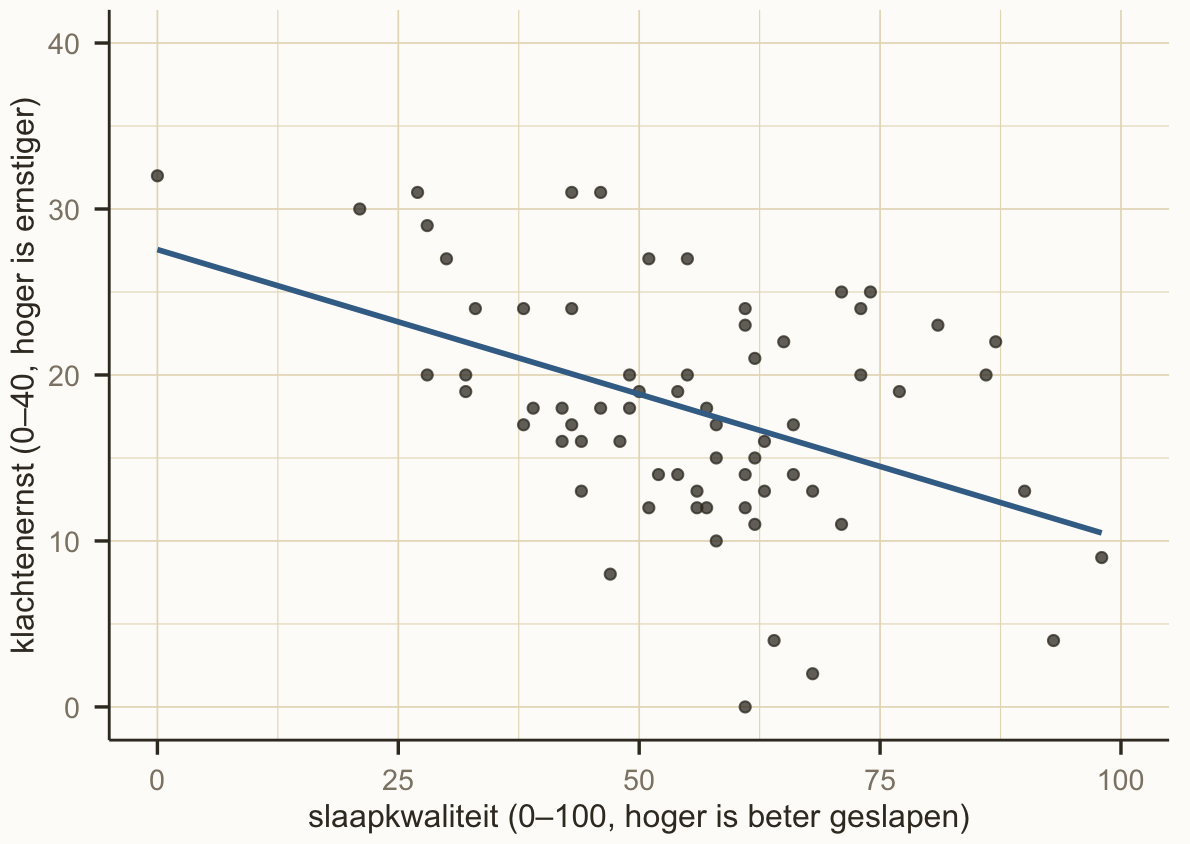
Je ziet ook vaak r² erbij, hier .20. Dat is het aandeel gedeelde variantie / shared variance: ongeveer een vijfde van de verschillen in slaapkwaliteit tussen patiënten gaat samen met verschillen in ernst (en andersom). De andere vier vijfde is van alles behalve deze twee samen. Onthoud die verhouding — een matige r laat het meeste nog onverklaard.
Waar het vandaan komt
Dit hoort bij de boek-eenheid Hangen ze samen? — waar de correlatie, de scatterplot en de enkelvoudige regressie voor het eerst langskomen. r is familie van de regressierechte: dezelfde onderliggende motor (de covariantie — bewegen twee variabelen samen?), maar dan gestandaardiseerd, zodat er een getal tussen −1 en 1 uitkomt dat je van het ene onderzoek naast dat van het andere kunt leggen, wat de meetlatten daar ook waren. In diezelfde geest is r het effectgrootte-familielid voor twee doorlopende variabelen: waar Cohens d een verschil tussen twee groepen op maat brengt, brengt r een samenhang op maat.
Eén ding uit het boek moet je hier paraat hebben: r meet uitsluitend de rechtlijnige samenhang. Alles wat krom is, ziet hij niet of half. Daarom loopt in die boek-eenheid de scatterplot altijd vóór het getal uit, en niet andersom.
Zelf doen in JASP
⬇ Download de data — slaap_ernst.csv
Bij dit blok hoort het databestand slaap_ernst.csv: 68 rijen (de patiënten), drie kolommen — id, ernst (klachtenernst, 0–40, hoger is ernstiger) en slaapkwaliteit (0–100, hoger is beter geslapen). De rijen zijn gegenereerd — er zit geen echte patiënt in — en ze reproduceren precies de getallen uit het fragment.
OpmerkingIn JASP · JASP 0.98.1
- Open het bestand in JASP (menu linksboven → Open).
- Klik in de balk bovenin op Regression en kies Correlation.
- Sleep
ernstenslaapkwaliteitnaar het vak Variables;idlaat je staan. - Laat Pearson’s r aangevinkt staan en vink erbij aan: Confidence intervals (laat 95 staan). Open dan het kopje Plots en vink Scatterplot aan.
In de tabel rechts staat nu r = −0.443, met daaronder p < .001 en het 95%-interval [−0.616, −0.229]. Reken r² zelf even na op een kladblaadje: −0.443 in het kwadraat is 0.196, dus die .20 klopt. En kijk dan vooral naar de scatterplot: een wolk die van linksboven naar rechtsonder zakt, met één rechte lijn er dwars doorheen — maar met stippen die er soms fors naast liggen. Díé spreiding rond de lijn is het verschil tussen de .20 die de twee delen en de 1.00 die er in totaal te verdelen valt. JASP tekent; jij leest.
En dan ziet je oog meteen nog iets: helemaal links ligt één patiënt op slaapkwaliteit 0, met een gat tot de eerstvolgende op 21. Zo iemand is precies het geval waar dit blok verderop voor waarschuwt — één punt aan de rand kan een getal optillen. Hier doet hij dat ook: laat je hem weg, dan zakt r van −.44 naar −.39. Onthoud hem; in het blok over enkelvoudige regressie reken je precies uit wat hij draagt.
Die afstandjes van stip tot lijn hebben trouwens een naam die je in je bijeenkomsten tegenkomt: residuen / residuals — gemeten min voorspeld, wat het model van díé ene patiënt niet raadde. Let op, want het woord doet dubbel dienst: in een kruistabel is een residu iets anders, namelijk geteld min verwacht in één hokje (zie De kruistabel en χ²). Zelfde woord, twee objecten. De regel is dezelfde als daar: kijk waar het residu van aftrekt.
En dezelfde leesgewoonte als altijd: kijk hóé de variabelen gecodeerd zijn. Hier is hoger op slaapkwaliteit beter slapen, dus de samenhang met ernst is negatief. Had de vragenlijst juist slaapproblemen geteld (hoger = slechter), dan had er +0.443 gestaan: exact dezelfde samenhang, ander teken. Het teken zit in de codering, niet in de wereld.
Zelf opschrijven
OpmerkingSchrijf het op — de correlatie r
Voor je eigen Nederlandstalige literatuurstudie:
In een dwarsdoorsnede (N = 68) hing klachtenernst matig negatief samen met slaapkwaliteit: patiënten die slechter sliepen, rapporteerden ernstiger klachten (r = −.44, 95%-betrouwbaarheidsinterval [−.62, −.23], p < .001).
Drie werkafspraken daarbij:
- Noem beide variabelen én de richting. “Een correlatie van −.44” zonder erbij te zeggen tussen wat en wat, en welke kant op, is geen bevinding maar een los getal. Een samenhang is altijd een samenhang tussen twee benoemde dingen.
- Neem r mét zijn interval over, zonder voorloopnul (net als p: −.44, niet −0.44), twee decimalen, met N of de vrijheidsgraden erbij. Het interval zegt hoe hard de −.44 meewiebelt bij deze steekproefomvang.
- Geen causale taal. Schrijf “hangt samen met” of “is geassocieerd met”, nooit “leidt tot”, “veroorzaakt” of “door” — lees eerst hieronder waarom een correlatie die woorden niet mag dragen. En kijk naar de scatterplot vóórdat je de r opschrijft.
Wat het niet zegt
De verleidelijkste redenering die je over dit fragment kunt opschrijven is: “r = −.44, p < .001 — slecht slapen maakt de klachten erger.” Eén korte zin, drie haarscheurtjes.
“maakt erger.” Een correlatie is geen causaliteit. r ziet dat twee dingen samen bewegen, maar niet wáárom. Het kan de andere kant op zijn (ernstiger klachten verstoren de slaap), het kan door een derde variabele komen die ze allebei aandrijft (een angststoornis, middelengebruik, een recente crisis — die maken zowel de slaap slechter als de klachten ernstiger), of het is een mengsel. r kan de richting van de pijl niet zien; in een dwarsdoorsnede, één momentopname, is er niet eens een tijdsvolgorde om op te leunen. Een samenhang tussen wat en wat kun je opschrijven; een oorzaak niet.
“−.44” als hét getal. r vat álleen de rechtlijnige samenhang samen, en daardoor kunnen twee totaal verschillende wolken exact dezelfde r geven: een nette schuine sliert, maar net zo goed een duidelijke kromme (waar r laag uitvalt terwijl er een prachtig verband is), of een verder richtingloze wolk met één extreme uitschieter die het getal in zijn eentje optilt of onderuit haalt. Zonder de scatterplot weet je niet wélke van die situaties je voor je hebt. Dát is de reden dat bij elke gerapporteerde r een plaatje hoort — en dat je, als een artikel er geen laat zien, één vraag overhoudt.
“r² = .20, dus 20% verklaard.” Als aandeel gedeelde variantie mag dat, maar “verklaard” is hier een rekenterm en geen inhoudelijke verklaring: er wordt niets uitgelegd, er wordt variantie gedeeld. En vergeet de andere 80% niet. Let ook op de breedte van de wolk: bekijk je alleen de zwaarste patiënten (een afgeknepen range op ernst), dan zakt r vanzelf, zonder dat de samenhang zelf ook maar iets verandert — een lage r in een smalle steekproef is geen bewijs dat er weinig aan de hand is. Grootte, vorm, richting én oorzaak zijn vier verschillende vragen, en r beantwoordt er hooguit één.
Oefening
OpmerkingOefening
Leesopgave. Hieronder een voorbeeldfragment (verzonnen). Vertel in gewone Nederlandse zinnen wat er gemeten is, en leg uit waarom de conclusie van de auteurs niet volgt uit dit getal. Noem minstens twee alternatieve verklaringen.
In a cross-sectional study, higher social media use was associated with more depressive symptoms (r = .35, p < .001). The authors concluded that reducing social media use would lower depressive symptoms.
Doe-opgave. Draai de correlatie van hierboven (slaap_ernst.csv) met de scatterplot erbij. Lees r, het interval en r² af, en beschrijf in één zin de wolk die je ziet. Maak dan het range-effect zelf zichtbaar: zet in JASP een filter op de rij-selectie zodat alleen patiënten met ernst ≥ 18 meedoen (ongeveer de bovenste helft), en draai de correlatie opnieuw. Twee vragen: gaat r omhoog of omlaag als je de range zo inknijpt — en betekent dat verschil dat de samenhang bij zware patiënten écht anders is, of dat je iets anders naar het getal hebt gedaan?
Drie wolken, drie getallen. Hierboven ging het over één samenhang. Nu twee andere, uit bestanden die elders in dit oefenboek ook langskomen:
⬇ wachttijd_intake.csv ⬇ nazorg_therapietrouw_terugval.csv
Maak in JASP van allebei een scatterplot — bij het eerste bestand de samenhang tussen leeftijd en wachttijd_dagen, bij het tweede die tussen therapietrouw en symptoomdaling. Kijk eerst naar de twee wolken en dek de tabel af. Schrijf van elke wolk op wat je ziet, in gewone zinnen, en gok welke van deze drie getallen erbij hoort: −.44, −.08, .78. Draai daarna pas de correlatie en kijk of je goed gokte.
Twee vragen erna:
- Bij
wachttijd_intakeligt het 95%-interval rond r anders dan je in dit blok tot nu toe zag. Zoek op waar dat interval loopt, en zeg wat dat betekent voor de zin “leeftijd hangt samen met wachttijd”. - In de wolk van
wachttijd_intakeliggen twee patiënten hoog boven de rest: zij wachtten een half jaar. Haal die twee eruit en draai r opnieuw. Vergelijk wat er gebeurt met wat er eerder in dit blok gebeurde toen je de patiënt op slaapkwaliteit 0 weghaalde. Waarom doet een uiterste punt de ene keer bijna niets en de andere keer wel iets?
OpgeletUitwerkingen — klik open
Uitwerking leesopgave
Er is in één moment gemeten hoeveel mensen sociale media gebruiken en hoeveel depressieve klachten ze hebben, en die twee hangen matig positief samen: r = .35 (zo’n .12 gedeelde variantie — de ruime meerderheid van de verschillen staat er los van). Maar de conclusie is causaal (“minder gebruiken zou de klachten verlagen”), en dat kan r niet dragen. De correlatie is symmetrisch en blind voor richting: net zo goed gaan mensen die zich somber voelen méér scrollen (terugtrekken, afleiding zoeken), of drijft een derde factor allebei op — eenzaamheid, slaapgebrek, ingrijpende levensgebeurtenissen. Bovendien is dit een dwarsdoorsnede: één momentopname, zonder tijdsvolgorde, dus zelfs “wat kwam eerst” is niet te zien. Om te mogen zeggen dat mínder gebruiken helpt, zou je moeten ingrijpen en vergelijken (een experiment), niet meten en correleren. In je literatuurstudie schrijf je dus dat de studie een matige samenhang vond, en dat de causale conclusie van de auteurs niet door het design gedekt wordt.
Uitwerking doe-opgave
Over de volle range is r = −.44 met interval [−.62, −.23] en r² = .20; de wolk zakt van linksboven naar rechtsonder met stevige spreiding rond de lijn — een duidelijke maar losse samenhang, met links één losse patiënt op slaapkwaliteit 0. Knijp je de range in tot ernst ≥ 18, dan zakt r naar ongeveer −.38, en de steekproef krimpt van 68 naar 36 patiënten. De samenhang bij zware patiënten is niet echt zwakker geworden — je hebt alleen de spreiding op ernst weggehaald (de standaarddeviatie valt van 7.0 terug naar 4.4), en met minder spreiding om mee te werken heeft r minder te pakken. Dit is range-restrictie / range restriction: een correlatie is altijd een correlatie ín een bepaalde steekproef, en hoe smaller je die maakt, hoe kleiner r wordt — ook als er onderliggend niets veranderd is. De les voor het lezen van artikelen: een lage r kan net zo goed over de steekproef gaan als over het verband.
Uitwerking drie wolken, drie getallen
De drie getallen horen zo: .78 bij nazorg_therapietrouw_terugval, −.44 bij slaap_ernst, en −.08 bij wachttijd_intake.
De wolk van nazorg_therapietrouw_terugval is de makkelijkste:
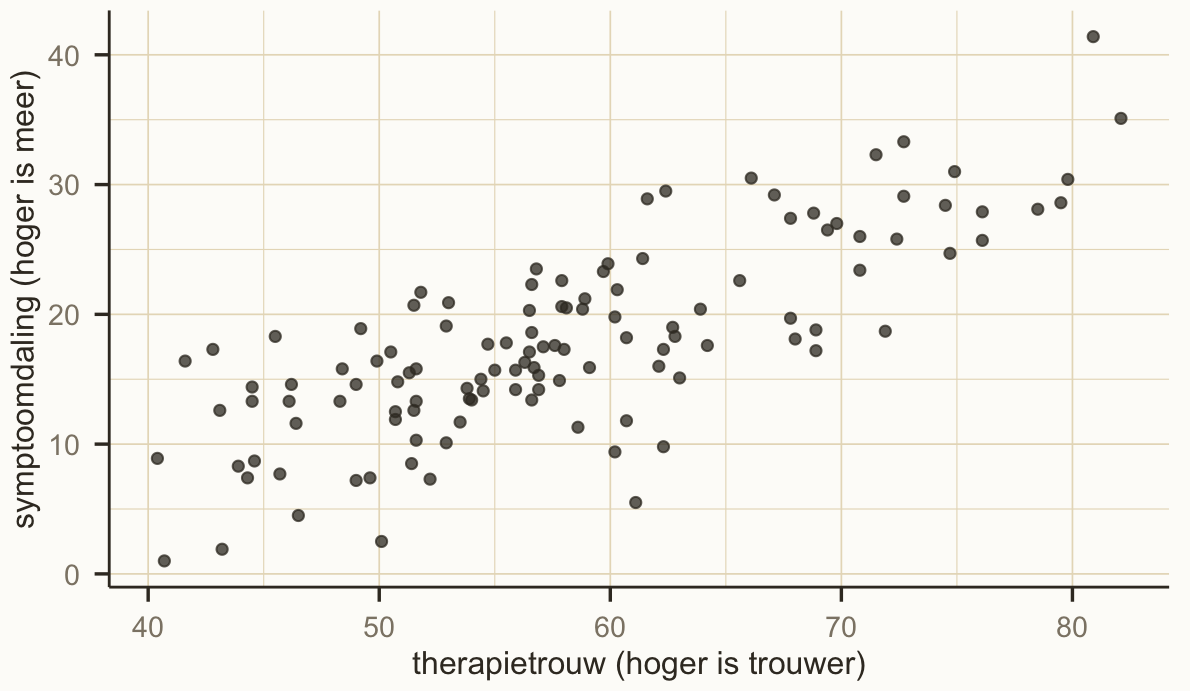
Een duidelijke strook van linksonder naar rechtsboven: patiënten die hun afspraken beter nakwamen, zagen hun klachten sterker dalen. Dat is r = .78, 95%-interval [.70, .84], bij N = 120 — strak en positief, en dus het spiegelbeeld van de −.44 uit dit blok: even duidelijk, andere kant op, en nog wat sterker.
En dan een addertje dat je alleen ziet als je de kolomnamen leest. Dit bestand heeft er vier: naast therapietrouw en symptoomdaling staat nazorg — wie wel en wie niet een intensief nazorgprogramma kreeg. Dat programma duwt allebei de andere kolommen omhoog: mensen erin kwamen hun afspraken beter na en zagen hun klachten sterker dalen. Precies de derde variabele waar dit blok verderop voor waarschuwt, en hier staat hij gewoon in het bestand. Je kunt hem zelf wegen: splits in JASP de correlatie per nazorg-groep, en de .78 valt uiteen in .57 bij gebruikelijke zorg en .77 bij het nazorgprogramma. Een deel van die mooie strook is dus niet het verband tussen die twee, maar het programma dat er onder beide ligt. Dít is hoe een derde variabele er in echte data uitziet — geen abstractie, een kolom.
De wolk van wachttijd_intake loopt geen kant op:
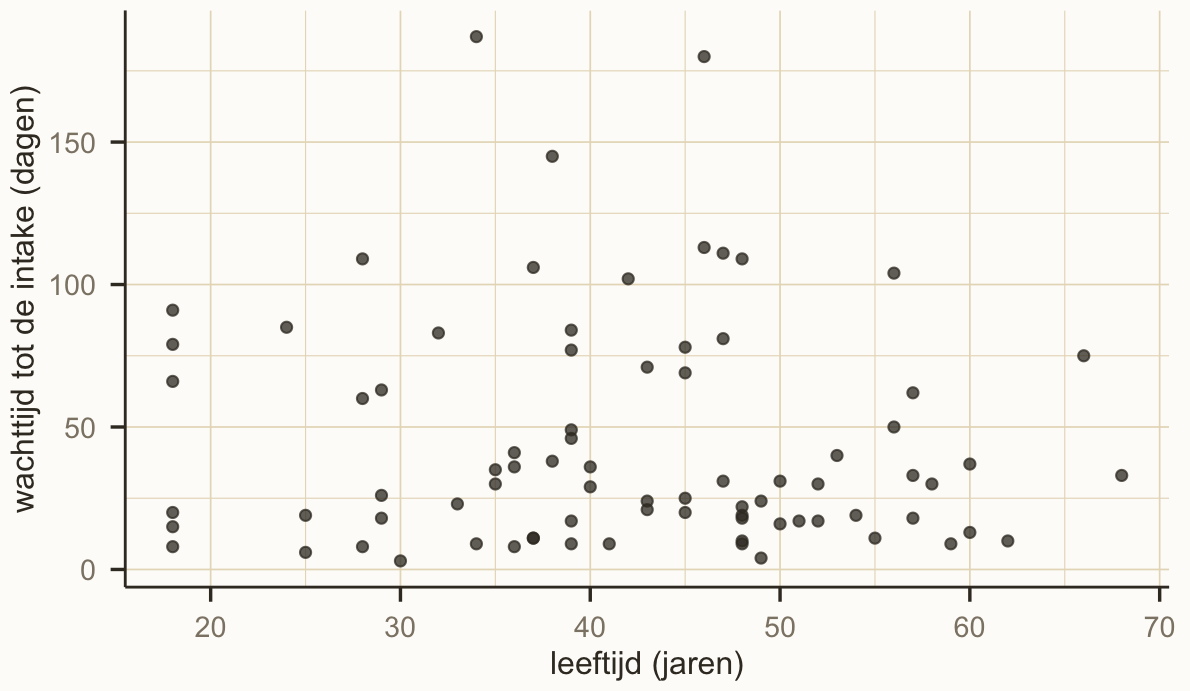
Er is geen hoek in te zien, en het getal zegt hetzelfde: r = −.08 bij N = 80. Dit is wat “geen rechtlijnig verband” er in het echt uitziet — geen bijzonder plaatje, gewoon een vlek. De twee punten bovenin springen wel in het oog, maar dat is iets anders dan richting.
Twee dingen die je oog er tóch in zal zien, en die er niet zijn. De langste wachttijden liggen allemaal bij de middelbare leeftijden, wat op een boog lijkt — maar daar zitten ook gewoon de meeste patiënten; leg je er een kromme door, dan wint die niets. En helemaal links staan zes stippen recht boven elkaar: dat zijn zes mensen van achttien, de jongste leeftijd in het bestand. Allebei vormen die je oog maakt van drukte, niet van samenhang. Dat is precies waarom “ik zie er wel iets in” nooit het antwoord is — je legt het getal ernaast.
(1) Het 95%-interval loopt hier van −.30 tot .14, en dat is het verschil met alles wat je hierboven zag: de nul ligt erin. Het interval laat een kleine negatieve samenhang toe, een kleine positieve, en niets — alle drie passen bij deze data. De zin “leeftijd hangt samen met wachttijd” kun je dus niet opschrijven; wat je wél mag opschrijven is dat je geen samenhang tussen leeftijd en wachttijd gevonden hebt, met het interval erbij zodat de lezer ziet hoe groot een gemist verband had kunnen zijn. Let op het verschil: geen samenhang gevonden is iets anders dan aangetoond dat er geen samenhang is.
(2) De twee losse punten zijn de wachttijden van 187 en 180 dagen. Haal je ze weg, en r blijft gewoon op −.08 staan. Pas op de vierde decimaal beweegt er iets: −.0832 wordt −.0835. Bij de patiënt op slaapkwaliteit 0 ging r wél merkbaar omlaag, van −.44 naar −.39.
Het verschil zit niet in hóé ver een punt weg ligt, maar in of hij de wolk oprekt in de richting die r meet. De patiënt op slaapkwaliteit 0 lag ver aan de linkerkant en verder niet bijzonder: zijn afstand tot de lijn is met 4.4 punt precies doorsnee voor deze wolk. Wat hij wél deed, is de wolk breder maken in precies de richting waarin het verband loopt, en daarmee droeg hij een stuk van het getal. De twee lange wachters liggen hoog boven een wolk die nergens heen loopt — er is geen richting om te versterken, dus er valt ook niets te dragen. “Er ligt een punt ver weg” is daarom geen reden om iets te verwijderen; het is een reden om te kijken wáár hij ligt ten opzichte van de rest.
◠ Zelfde vorm in het boek
Hier: één getal voor de rechtlijnige samenhang tussen twee gemeten dingen, altijd met het plaatje ernaast.
In het boek: W4 — Hangen ze samen?
Daar is het getal niet het begin maar de uitkomst: eerst de wolk zien, dan pas de lijn eronder samenvatten.