3. Validity en classificatie — sensitivity, specificity en hoe je verkeerd gaat
Het verhaal van dit thema
De vos kwam uit de hazelaars en zette zich naast de wezel. Hij rook iets, en hij wilde weten hoe goed hij dat rook.
“Ik heb een test,” zei de vos. “Een vragenlijst die zegt of een dier alarm-snel is of niet.”
“Werkt hij?” vroeg de wezel.
“Daar gaat dit thema over. Validiteit heet het. De vraag is niet of de score consistent is — dat hebben jullie thema 2 al uitgemest — maar of hij meet wat hij beweert te meten.”
“Hoe weet je dat?” vroeg de bunzing.
“Door hem te vergelijken met een andere maat van hetzelfde, met een andere maat van iets anders, en met een externe waarheid.” De vos rook nog eens. “En dan reken je een tabel met vier cellen die je sensitivity, specificity, PPV en NPV oplevert. Als je het goed doet.”
Tweehonderd bosdieren in dit thema. Een continue Bos-Alarm-Vragenlijst (BAV, -). Plus een ware diagnose (alarm-snel / alarm-traag) op basis van geobserveerd reactiegedrag, een convergente maat (alertheid-observatie), en een divergente maat (kalmte). Mini-dataset: 80 dassen op een voorspeller-uitkomst-koppel voor E5.
Drie hoofdvragen:
Hangt de score samen met wat hij zou moeten meten? — convergent vs divergent (construct-validiteit).
Voorspelt hij een externe uitkomst? — criterion-validiteit + classification table.
Wat doe je bij meetfout? — correctie voor attenuatie, en waarom dat een gevaarlijk speeltje is.
OpmerkingA. Wat is validity?
Validity = de mate waarin een test meet wat hij beweert te meten. Verschillende soorten:
Content-validiteitcontent validity — dekken de items het construct? Theoretisch oordeel, geen statistiek. Bv. een depressie-schaal moet niet alleen stemming bevragen maar ook slaap, eetlust, concentratie.
Construct-validiteitconstruct validity — gedraagt de score zich zoals het construct dat zou moeten? Twee subtypes:
Convergent: hoge correlatie met andere maten van hetzelfde construct.
Divergent / discriminant: lage of negatieve correlatie met maten van andere constructen.
Criterion-validiteitcriterion validity — voorspelt de score een externe uitkomst? Twee subtypes:
Reliability validity. Een onbetrouwbare schaal kan onmogelijk valide zijn (te veel ruis); een betrouwbare schaal hoeft nog niet valide te zijn (kan consistent het verkeerde meten — “perfect verkeerd”). Validiteit is altijd relatief aan een claim: deze test is valide voor het meten van X in populatie Y voor doel Z. Niet “valide” in absolute zin.
OpmerkingB. Classification table — vier cellen, vier verhoudingen die er echt toe doen
Bij criterion-validiteit met een binaire uitkomst gaat het om de classification table. De werkelijkheid staat in de rijen, wat de test zegt in de kolommen:
Voorspeld positief
Voorspeld negatief
Werkelijk positief ()
TP
FN
Werkelijk negatief ()
FP
TN
De letters lees je van achter naar voren. De tweede zegt wat de test zei (Positief of Negatief), de eerste of dat klopte (True of False). FN is dus: de test zei negatief, en dat was fout. Echt positief, en gemist. FP is vals alarm.
Vier ratio’s die er toe doen:
Sensitivity (TPR, true positive rate): — gegeven dat iemand positief is, hoe vaak vindt de test hem? Je blijft in de rij werkelijk positief.
Specificity (TNR): — gegeven dat iemand negatief is, hoe vaak laat de test hem terecht gaan? Je blijft in de rij werkelijk negatief.
PPV (positive predictive value): — gegeven dat de test positief is, hoe vaak klopt dat? Je blijft in de kolom voorspeld positief.
NPV (negative predictive value): — gegeven dat de test negatief is, hoe vaak klopt dat? Je blijft in de kolom voorspeld negatief.
Sensitivity en PPV hebben dezelfde teller: TP. Alleen de noemer verschilt — bij sensitivity de hele rij, bij PPV de hele kolom. Precies daar gaat het het vaakst mis.
Tip“Gegeven dat” maakt de zaal kleiner
Gegeven dat iemand echt positief is betekent: alleen de echt positieven blijven zitten, de rest van de zaal gaat naar huis. Wie er blijft zitten, daar deel je door.
Sensitivity en specificity: alleen wie echt positief is (of echt negatief) blijft zitten. In de tabel is dat één rij.
PPV en NPV: alleen wie een positieve (of negatieve) uitslag kreeg, blijft zitten. In de tabel is dat één kolom. Ze dragen de voorspelling in hun naam — predictive value — en daarom is hier de test het gegeven.
Kom je de tabel ergens andersom tegen, met de voorspelling in de rijen, dan kloppen rij en kolom niet meer, maar de zaal nog wel: sensitivity deelt door alle echt positieven, waar die ook staan. Zoek dus eerst waar de werkelijkheid staat. Dat gebeurt echt; sommige R-functies willen de tabel zo.
Plus een vijfde maat:
PAC (proportion accurate classifications, ofwel accuracy): — welk percentage classificaties klopte überhaupt? Eenvoudig, maar misleidend bij scheve klassen (zie Don’t-callout verderop).
OpmerkingC. Vos-frame — wat onderzoeken we?
De vos heeft een test (BAV) en wil weten:
Meet de BAV alertheid? (convergent: correleert hij met een tweede maat van alertheid?)
Discrimineert hij van kalmte? (divergent: correleert hij negatief, of bijna nul, met een kalmte-maat?)
Voorspelt hij wie er echt snel reageert? (criterion + classification table — sensitivity, specificity, PPV, NPV).
En wat doe je als je weet dat de BAV niet perfect betrouwbaar is — corrigeer je dan voor attenuatie? (3.A — en daar gaat de vos zich verbazen).
OpmerkingRefresh — wat je uit thema 1 en 2 hebt meegenomen
Thema 1: norm-scoren — z-, T-scores, percentielen. Plus Ruw is Ruk.
Thema 2: Cronbach’s als internal consistency. Plus een onbetrouwbare schaal kan onmogelijk valide zijn.
Validity bouwt voort op reliability. Stel je voor: een schaal met correleert met een externe uitkomst. Klinkt magertjes — maar de echte correlatie tussen de constructs zou hoger zijn als de schaal betrouwbaar was. Correctie voor attenuatie (3.A) brengt die rekensom in beeld. Maar pas op: correctie zonder context is een eufemisme voor wensdenken.
Werkmaterialen — R-pakketten en functies
De vos pakt zijn gereedschap
Gereedschap
Waar het voor is
Pakket
cor()
Pearson-correlaties (convergent / divergent)
base
table()
Classification table
base
prop.table()
Percentages uit tabel
base
cor.test()
Correlatie + -waarde + CI
base
glm(..., family = binomial)
Logistische regressie als criterion-validatie
base
psych::cor.smooth()
Smoothing van correlatie-matrices (zelden nodig hier)
psych
OpmerkingCode in dit hoofdstuk — wat moet je kunnen typen?
Code is standaard open als je hem zelf moet kunnen typen: cor(), cor.test(), table(), prop.table(), en de classificatie-formules met de hand. Code voor gt-tabellen of plot-decoratie staat ingeklapt. Staat een stap in twee tabbladen, dan typ je Base R; dplyr staat ernaast om te kijken, en overslaan mag.
Notatie — symbolen voor validity
OpmerkingSleutelsymbolen
— geschatte (sample) correlatie tussen en .
— reliability (Cronbach’s of equivalent) van .
— reliability van .
— voor attenuatie gecorrigeerde correlatie (zie 3.A).
TP, FP, FN, TN — true/false positive/negative.
PAC = proportion accurate classifications = .
Sensitiviteit, specificiteit, PPV, NPV — zie kader B.
Base rate — proportie positieven in de populatie. PPV en NPV hangen ervan af, sensitivity en specificity niet.
TipVuistregels zijn afspraken, geen wetten
Convergent: tussen maten van hetzelfde construct is een gangbare ondergrens. is sterk.
Divergent: tussen maten van verschillende constructen. Hoger duidt op constructverschillen die niet duidelijk zijn.
Sensitivity / specificity bij screening: liever sensitivity hoog (); false negatives missen is duurder dan false positives.
Sensitivity / specificity bij definitieve diagnose: liever specificity hoog (); false positives kosten meer dan false negatives.
PPV en NPV: hangen sterk af van base rate. Bij zeldzame ziekte kan PPV laag zijn () zelfs bij goede sensitivity en specificity.
Verschillende vakgroepen en handboeken hanteren iets andere drempels; werk je met ander materiaal, kijk dan welke afspraak dat volgt.
Per dier: een dier_id, diersoort, leeftijd, een continue alarm_score (BAV, -), twee andere continue maten (alertheid_obs en kalmte_obs) voor convergente en divergente validatie, plus de ware binaire ware_alarm (snel/traag) als criterion.
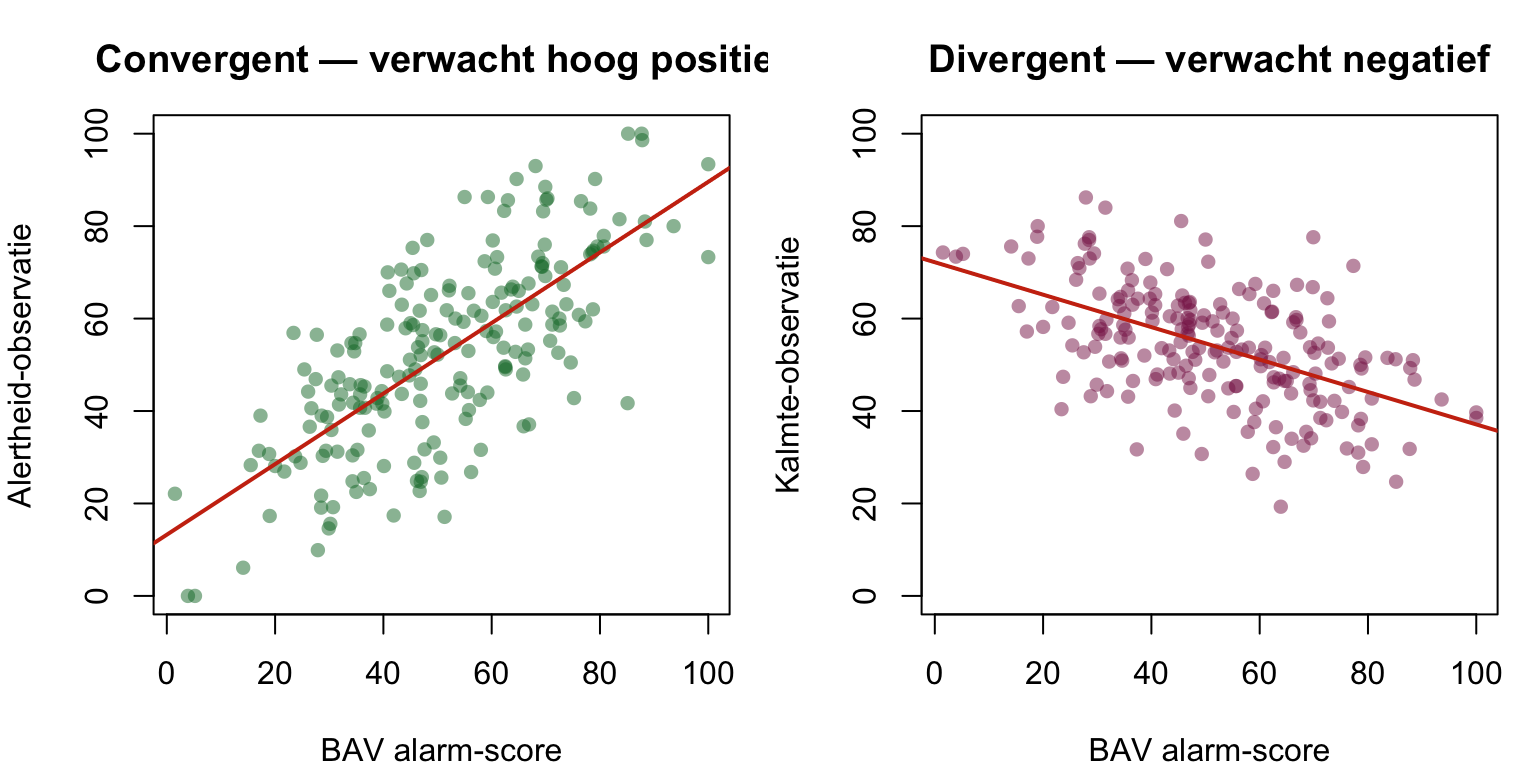
3.1 Construct-validiteit — convergent en divergent
Hangt de test samen met wat hij zou moeten meten?
“Convergent moet hoog,” zei de vos. “Divergent moet laag, of negatief. Anders zegt de test niets over alertheid maar gewoon over iets wat met alles samenhangt.”
OpmerkingVoor je gaat rekenen — vijf vragen aan jezelf
Wie of wat wordt er gemeten?De vos heeft 200 bosdieren genoteerd op vier maten.
Wat wordt er gemeten?Drie continue scores plus één binaire diagnose.
Onafhankelijk of afhankelijk?Voor construct-validatie geen voorspelmodel — we kijken naar correlatiepatronen. Voor criterion (3.2): wel een voorspelmodel.
Welke techniek? Construct-validiteit: correlaties (convergent vs divergent). Criterion-validiteit: classification + sensitivity/specificity, eventueel logistische regressie: een regressie die een ja/nee-uitkomst voorspelt. Die hoort bij multivariate data-analyse, en is een onderwerp op zich.
T1 — Welke validity-soort?
OpmerkingVraag T1 — Pen-en-papier
Voor elk vignet: kies tussen content-validiteit, convergent-validiteit, divergent-validiteit, concurrent criterion-validiteit, predictive criterion-validiteit.
a)Een onderzoeker test of haar nieuwe burn-out-schaal sterker correleert met een gevestigde burn-out-meting (UBOS) dan met een depressie-meting.
b)Een commissie expert-psychologen evalueert of een autisme-vragenlijst alle relevante symptoom-domeinen dekt.
c)Een psychiater toetst of haar nieuwe ADHD-schaal vandaag samenhangt met een diagnose die op dezelfde dag is gesteld.
d)Een opleidingspsycholoog meet bij studenten in jaar 1 een werkethiek-vragenlijst, en kijkt of die scores hun afstudeer-cijfer 4 jaar later voorspellen.
e)Een psycholoog kijkt of een sociale-angst-schaal niet samenhangt met een tabel-tennis-vaardigheids-test (zou dat ook niet moeten).
OpgeletAntwoord — open na je eigen poging
a) Convergent + divergent. Convergent: BAS-burnout met UBOS-burnout (hoge correlatie verwacht). Divergent: BAS-burnout met depressie (lagere correlatie verwacht omdat het andere construct is).
b) Content-validiteit. Theoretisch oordeel of de items het construct dekken. Geen statistiek — wel expert-review en theoretisch kader.
c) Concurrent criterion-validiteit. Schaal en criterium gelijktijdig gemeten, vraag: voorspelt de schaal de criterium-uitkomst?
d) Predictive criterion-validiteit. Schaal eerst, criterium later in de tijd. Voorspelt de schaal de toekomstige uitkomst?
e) Divergent-validiteit. Een sociale-angst-schaal zou niet moeten samenhangen met tafeltennis-vaardigheid; correlatie nul-of-laag bevestigt divergent.
Vuistregel.Hetzelfde construct, andere maat = convergent. Ander construct = divergent. Externe binaire uitkomst = criterion (concurrent of predictive afhankelijk van timing). Theoretisch oordeel = content.
3.1.a Verkenning — correlatiematrix
Ook in dit thema staan een paar stappen in twee schrijfwijzen naast elkaar, in tabbladen. Net als in thema 1 en 2: base R staat vooraan en is het enige dat je zelf moet kunnen typen; dplyr staat ernaast om te kijken, en overslaan mag. Ze geven dezelfde getallen.
library(dplyr)# select() kiest kolommen bij hun kale naam: geen aanhalingstekens, geen c().# Binnen dplyr kan dat; in base R blijven ze nodig.# Wat eruit komt, gaat via het pijpje meteen cor() in.cor_validity <- bos_alarm_test |>select(alarm_score, alertheid_obs, kalmte_obs) |>cor()round(cor_validity, 3)
d) Een correlatie van tussen alarm en kalmte zou suggereren dat de BAV niet echt het tegenovergestelde van kalmte meet — misschien meet hij iets anders dan alertheid (algemene fysieke activatie? motor-reactie?). De divergent-validity zou dan zwak zijn — de constructen zijn niet duidelijk uitgesplitst.
APA-stijl.
Construct-validity van de Bos-Alarm-Vragenlijst (BAV) werd onderzocht via correlaties met twee andere maten (). De convergente correlatie met een onafhankelijke alertheid-observatie was sterk, , . De divergente correlatie met een kalmte-maat was duidelijk negatief, , . Dit patroon ondersteunt de claim dat de BAV alertheid meet en niet alleen een algemene-activatie-construct.
T2 — Convergent én divergent — wanneer mag je tevreden zijn?
OpmerkingVraag T2 — Pen-en-papier
Een onderzoeker rapporteert voor een nieuwe stress-schaal:
(met een gevestigde stress-meting)
(met een depressie-meting)
a) Hoe interpreteer je dit patroon?
b) Welke twee verklaringen zijn mogelijk?
c) Wat zou je willen zien om beter overtuigd te raken?
d) Stel het patroon was: , . Wat is dan de conclusie?
OpgeletAntwoord — open na je eigen poging
a) Het convergent-getal is hoog, maar het divergent-getal is bijna even hoog. Onvoldoende discriminatie tussen stress en depressie — de schaal meet iets dat met beide samenhangt.
b) (1) De constructen zijn echt verwant — stress en depressie correleren in de natuur (vaak ). De schaal volgt die natuur. (2) De schaal is niet specifiek — hij meet algemene-distress-zonder-onderscheid. Welke van beide klopt: lastig zonder verdere data.
c)Multitrait-multimethod-matrix (Campbell & Fiske, 1959): meerdere constructen meten met meerdere methoden, en kijken of de constructen sterker samenhangen binnen dan tussen methoden. Plus: factor-analyse om dimensionaliteit expliciet te toetsen (komt in thema 5).
d) Wel-divergent. is acceptabel, is laag genoeg om te zeggen: schaal meet stress, niet algemeen-distress.
Inzicht.Convergent hoog op zichzelf is niet genoeg — moet altijd vergeleken met divergent. Het verschil tussen beide is de eigenlijke discriminatie-claim.
“Nu de echte test,” zei de vos. “Niet correlatie met een andere lijst — een echte classificatie. Dier reageert echt snel of niet. Vraag: voorspelt mijn vragenlijst dat?”
Positief betekent hier: alarm-snel. De test moet de snelle dieren vinden, dus snel staat in de tabel waar in kader B positief staat.
# Cutoff op alarm_score (mediaan, kan ook ergens anders).cutoff <-median(bos_alarm_test$alarm_score)cat("Cutoff (median):", round(cutoff, 2), "\n")
Cutoff (median): 50.25
bos_alarm_test$voorspeld <-factor(ifelse(bos_alarm_test$alarm_score >= cutoff, "snel", "traag"),levels =c("snel", "traag"))# Positief eerst, ook bij de werkelijkheid -- dan ziet de tabel eruit als kader B.bos_alarm_test$werkelijk <-factor(bos_alarm_test$ware_alarm,levels =c("snel", "traag"))# Classification table. Wat je eerst noemt, komt in de rijen: dus werkelijk# eerst, voorspeld daarna. Draai je ze om, dan draait de tabel mee.ct <-table(Werkelijk = bos_alarm_test$werkelijk,Voorspeld = bos_alarm_test$voorspeld)ct
         Voorspeld
Werkelijk snel traag
    snel    68    18
    traag   32    82
# De grens is één getal; daar komt geen dplyr aan te pas.cutoff <-median(bos_alarm_test$alarm_score)cat("Cutoff (median):", round(cutoff, 2), "\n")
Cutoff (median): 50.25
# mutate() zet de twee kolommen erbij, en if_else() doet wat ifelse() bij# base R doet.bos_alarm_test <- bos_alarm_test |>mutate(voorspeld =factor(if_else(alarm_score >= cutoff, "snel", "traag"),levels =c("snel", "traag")),werkelijk =factor(ware_alarm, levels =c("snel", "traag")) )# ct wordt een gewone table(), net als bij base R: hieronder pakt de code er# losse cellen uit met ct["snel", "snel"].## select() kiest de twee kolommen, werkelijk eerst, en noemt ze meteen# Werkelijk en Voorspeld.ct <- bos_alarm_test |>select(Werkelijk = werkelijk, Voorspeld = voorspeld) |>table()ct
         Voorspeld
Werkelijk snel traag
    snel    68    18
    traag   32    82
R zet de twee namen op een eigen plek: Werkelijk links, boven de rijnamen, en Voorspeld erboven, boven de kolomnamen. De regel Werkelijk snel traag betekent dus niet dat Werkelijk naar rechts loopt; snel en traag zijn daar de kolommen van Voorspeld.
c) Wat is PAC en wat is het verschil met sensitivity?
d) De cutoff staat nu op de mediaan. Wat verandert er als je hem verhoogt naar het 75ste percentiel?
OpgeletAntwoord — open na je eigen poging
a) Sensitivity — gegeven dat een dier echt snel-reagerend is, vindt de test dat in van de gevallen. Specificity — gegeven dat een dier echt traag-reagerend is, klassificeert de test dat correct in van de gevallen.
b) PPV — gegeven dat de test “snel” zegt, klopt dat in van de gevallen. Zelfde teller als de sensitivity, andere noemer: de kolom in plaats van de rij. NPV — gegeven dat de test “traag” zegt, klopt dat in .
c) PAC — overall classificatie-accuraatheid. Verschil met sensitivity: PAC kijkt naar alle correcte classificaties (TP + TN) gedeeld door totaal. Sensitivity kijkt alleen naar de rij van de echt positieven. Bij scheve klassen (bv. negatief) kan PAC misleidend zijn — altijd “negatief” zeggen geeft PAC, maar sensitivity .
d) Cutoff verhogen → minder dieren als “snel” geklassificeerd → specificity stijgt (minder false positives), sensitivity daalt (meer echte snel-reagerenden missen). PPV stijgt waarschijnlijk (de dieren die je wel als snel classificeert zijn extremer); NPV daalt iets. PAC kan beide kanten op afhankelijk van base rate.
APA-stijl.
Met een cutoff op de mediaan () classificeerde de Bos-Alarm-Vragenlijst 200 dieren in snel-reagerend () versus traag-reagerend (). Vergelijking met de geobserveerde ware-alarm-status leverde sensitivity , specificity , PPV , NPV en PAC . De BAV vertoont matige criterion-validity bij deze cutoff; verschuiving naar een strenger criterium zou specificity verbeteren ten koste van sensitivity.
T3 — Sensitivity vs Specificity — vier scenario’s
OpmerkingVraag T3 — Pen-en-papier
Voor elk scenario: welke ratio is belangrijker?
a)Een psychiater screent kinderen op autisme-symptomen. Doel: niemand mag worden gemist; vervolgconsult is laagdrempelig.
b)Een psychiater stelt een definitieve PTSS-diagnose. Gevolgen: medicatie, etiket, verzekerings-impact.
c)Een psycholoog meet bij cliënten een burn-out-risico-score, en gebruikt die als triage voor wachtlijst-prioriteit.
d)Een onderzoeker selecteert “extreem hoog scorers” voor een interventie-studie ( per groep).
OpgeletAntwoord — open na je eigen poging
a) Sensitivity belangrijker. Missen is de fout — false negatives blijven onbehandeld. Iets meer false positives (vervolgconsult niet nodig) is laagdrempelig.
b) Specificity belangrijker. Onterechte diagnose is duur (medicatie, etiket, verzekerings-impact). Liever wat sensitivity opofferen.
c) Beide ongeveer even belangrijk; balans of -score relevant. Bij triage kun je niet iedereen op de wachtlijst zetten (capaciteit) maar ook niemand met echt risico missen.
d) Specificity belangrijker. Doel: alleen echte extremen in de groep. False positives verwateren de “extreme” studiegroep.
Vuistregel.Missen erger dan vals alarm = sensitivity. Vals alarm erger dan missen = specificity. Vrijwel alle real-world toepassingen vereisen een keuze; geen formule lost het op.
T4 — PPV en NPV — base rate effect
OpmerkingVraag T4 — Pen-en-papier
Een test heeft sensitivity en specificity .
a) Bij een base rate van (helft positief): wat is PPV?
b) Bij een base rate van (zeldzame ziekte, op ): wat is PPV?
c) Wat zegt dit verschil?
d) Sensitivity en specificity hangen niet af van base rate — waarom PPV en NPV wel?
OpgeletAntwoord — open na je eigen poging
Bayes-formule: .
a) . Negen op tien positieve uitslagen kloppen.
b) . Slechts van positieve uitslagen klopt — false positives.
c) Bij lage base rate is PPV laag, ook al is de test op zich goed (sens en spec hoog). De meerderheid van positieve uitslagen is false positive omdat er gewoon meer negatieven zijn die kunnen misclassificeren.
d) Sensitivity en specificity zijn conditional op de ware status: gegeven dat iemand positief is / gegeven dat iemand negatief is. Die kansen zijn eigenschappen van de test, niet van de populatie. PPV en NPV zijn conditional op de testuitslag: gegeven dat de test positief is / gegeven dat de test negatief is. Die kansen hangen af van hoeveel positieven er überhaupt in de populatie zijn.
Inzicht.“Goed-werkende test” (sensitivity en specificity hoog) is geen garantie voor “betrouwbare diagnose” (hoog PPV) als de ziekte zeldzaam is. Vandaar de waarschuwing tegen massaal screenen op zeldzame aandoeningen.
T5 — Cutoff verschuiven en de ROC-curve
OpmerkingVraag T5 — Pen-en-papier
Een test heeft een continue score. Door de cutoff te verschuiven verandert het sensitivity/specificity-paar.
a) Als je de cutoff verlaagt (meer dieren positief gelabeld): wat gebeurt met sensitivity? Specificity?
b) En als je hem verhoogt?
c) Wat is een ROC-curve?
d) Wat is AUC (area under the ROC curve)? Welk getal zou je willen?
OpgeletAntwoord — open na je eigen poging
a) Cutoff lager → meer “positieven” geklassificeerd → sensitivity stijgt (meer echte positieven gevangen), specificity daalt (meer false positives).
b) Cutoff hoger → omgekeerd. Sensitivity daalt, specificity stijgt.
c)ROC-curve (Receiver Operating Characteristic): plot van sensitivity (Y-as) tegen specificity (X-as) bij elke mogelijke cutoff. Toont de trade-off visueel: hoe hoger de curve naar de linkerbovenhoek, hoe beter de test.
d)AUC = oppervlakte onder de ROC-curve. AUC = perfecte test. AUC = puur toevallig (de ROC-curve loopt over de diagonaal). Vuistregels: AUC = goed; - = acceptabel; = matig.
Inzicht. Een ROC-curve laat zien dat sensitivity en specificity samenhangen — geen vrije parameters. AUC is een cutoff-vrije maat: hij vat de hele ROC-curve samen. Vandaar de populariteit in machine learning en diagnostische test-validatie.
3.A Correctie voor attenuatie — handle with care
De vos roept iets, en het klinkt als wensdenken
“En als ik weet dat mijn schaal niet perfect betrouwbaar is?” vroeg de bunzing.
“Dan is je geobserveerde correlatie kleiner dan de werkelijke,” zei de vos. “Meetfout dempt elke samenhang.”
“Kan je dat corrigeren?”
“Technisch wel. Maar daar wil ik even over snauwen.”
Wat is correctie voor attenuatie?
Wanneer je een correlatie meet tussen en , en beide bevatten meetfout, dan onderschat je de “ware” correlatie tussen de onderliggende constructen. De geobserveerde correlatie is gedempt (afgenomen, attenuated) door meetfout. De Spearman-correctie:
Met en de reliability van en (Cronbach’s als proxy).
Voorbeeld: , , .
Geobserveerd ; gecorrigeerd . Aha! Sterker.
WaarschuwingPas op — de correctie is een schatting onder zware aannames
Correctie voor attenuatie veronderstelt:
Klassieke testtheorie geldt — meetfout is random, ongecorreleerd met ware score.
Reliability-schatting is precies — bij veronderstelt de formule dat de ware reliability exact is. Als in werkelijkheid is, krijg je een fout antwoord.
Lineaire samenhang — geen niet-lineaire effecten, geen interactie.
Bij lage reliability () wordt de correctie-factor explosief instabiel. Een kleine fout in leidt tot een grote fout in . Plus: gecorrigeerde correlaties kunnen uitkomen — wiskundig onmogelijk, maar in praktijk niet ongebruikelijk bij kleine steekproeven met lage reliability.
BelangrijkDon’t: correctie voor attenuatie als algemene “boost” voor je correlaties
Hier wordt het tijd om recht uit te snauwen.
Correctie voor attenuatie is een rekentruc die zegt: “Stel je voor dat onze metingen perfect betrouwbaar waren — dan zou onze correlatie hoger zijn.” Dat klinkt als een uitspraak over de werkelijkheid. Het is geen uitspraak over de werkelijkheid. Het is een conditional gedachte-experiment: als de wereld anders was, dan…. De wereld is zoals hij is — de correlatie in jouw studie is wat je gemeten hebt.
In echte artikelen staat dan zoiets:
“De gecorrigeerde correlatie tussen werkstress en burn-out was , wat duidt op een sterke onderliggende samenhang.”
Vraag aan jezelf: wat hadden ze écht gemeten? . Met , . Reken het uit: . Klopt op de cijfers. Maar dat écht-gemeten getal — — verdwijnt in de gecorrigeerde versie, en niemand vermeldt dat de reliability van zowel werkstress- als burn-out-meting twijfelachtig was. Wat lezers zien: “sterke onderliggende samenhang.” Wat de studie eigenlijk toont: “matige samenhang die we hebben opgepoetst door te delen door wortel-onbetrouwbaarheid.”
Dit is niet hetzelfde als wetenschappelijk frauduleus zijn — de correctie is wiskundig legitiem. Het is wel dichterbij: kennis-presentatie waarbij de zwakheid van de meting wordt verstopt onder een formule die “corrigeert”.
Wie een gecorrigeerde correlatie rapporteert moet altijd:
De rauwe erbij melden (“rauw” en “gecorrigeerd” naast elkaar).
De gebruikte reliabilities en expliciet noemen.
De standaardfout of CI rond de gecorrigeerde schatting rapporteren — die is bij lage reliability enorm.
Een interpretatie geven van de gecorrigeerde correlatie als theoretische schatting, niet als de echte studie-uitkomst.
Wie dat niet doet, en met “” zwaait alsof het een echte uitkomst is, doet aan statistisch theater. Leg zo iemand een kopie van Cronbach (1951) op het bureau, opengeslagen op pagina , en vraag of daar staat dat correctie voor attenuatie de echte correlatie oplevert.
komt uit de data — 200 dieren, de BAV tegen de alertheid-observatie. De twee reliabilities eronder niet: en zijn hypothetische waarden. Deze dataset heeft geen losse items, en zonder items valt er geen Cronbach’s te berekenen.
Dat maakt het voorbeeld niet minder bruikbaar — het laat zien wát de correctie doet — maar het gecorrigeerde getal dat er zo meteen uit komt is dus een rekensom op een aanname, niet een uitkomst van deze studie. Dat is precies het onderscheid waar de rest van deze sectie over gaat.
OpmerkingVraag 3.A
a) Wat is in dit voorbeeld? Wat is ?
b) Bereken als en (lage reliability).
c) Wat is je conclusie over wat je in een paper rapporteert?
d) Schrijf één APA-zin die eerlijk rapporteert, met rauw + gecorrigeerd + reliabilities erbij.
OpgeletAntwoord — open na je eigen poging
a) , . Een aanzienlijke “boost”, gerekend met de twee hypothetische reliabilities uit het codeblok hierboven. Een lezer die alleen ziet, denkt: “vrijwel perfect samenhangend”. De rauwe data zegt: “sterk samenhangend, maar niet vrijwel perfect.”
b) . Wiskundig onmogelijk — een correlatie kan niet groter dan zijn. Bij lage reliability krachtigere overshoot. Dit is precies waarom de Don’t-callout boos doet.
c)Altijd rauw én gecorrigeerd rapporteren, met reliability-bronnen erbij. Een gecorrigeerde correlatie zonder context is misleidend.
d) Voorbeeldzin:
De geobserveerde correlatie tussen BAV en alertheid-observatie was , (). Onder correctie voor attenuatie ( voor BAV en voor alertheid-observatie, beide Cronbach’s α) bedraagt de gecorrigeerde correlatie . We rapporteren de gecorrigeerde schatting als hypothetische bovengrens van de werkelijke construct-correlatie; de geobserveerde blijft het betrouwbare studie-resultaat.
Inzicht. Het VPRO-principe: een eerlijke rapportage laat de truc zien, niet alleen het resultaat. Wie alleen het gecorrigeerde getal rapporteert verbergt de bron.
Optie b: sensitivity is , niet . Die krijg je als je in de kolom voorspeld positief blijft in plaats van in de rij werkelijk positief: , en dat is de PPV. Optie c zet de getallen van optie a onder de verkeerde naam. De echte PPV is en de echte NPV , niet en . Optie d: PAC — niet onbruikbaar, gewoon niet uitstekend.
Dezelfde tabel andersom. Zo kun je hem ook tegenkomen, met de voorspelling in de rijen:
Werkelijk positief
Werkelijk negatief
Voorspeld positief
Voorspeld negatief
De en de zijn van plaats gewisseld, de som niet. Sensitivity deelt nog steeds door alle echt positieven, en die staan nu in de eerste kolom: .
OpmerkingVraag E2 — Convergent vs divergent
Een nieuwe sociale-fobie-vragenlijst (SFV) wordt getest op construct-validiteit:
(SFV, andere SF-vragenlijst)
(SFV, depressie-meting)
(SFV, IQ-test)
Welke conclusie?
Sterk convergent en duidelijk divergent (alleen IQ).
Onvoldoende discriminatie van depressie.
Test heeft alleen content-validiteit.
Meting is statistisch ongeldig.
OpgeletAntwoord — open na je eigen poging
b) Convergent is sterk. Divergent met depressie is te hoog — sociale fobie en depressie verschillen, maar als je nieuwe meting bijna even hoog correleert met depressie als met andere sociale-fobie-meting, kun je de constructen niet onderscheiden. Wel duidelijke discriminatie van IQ.
Optie a: is geen “duidelijke discriminatie”. Optie c: er is wel construct-data, niet alleen content. Optie d: “statistisch ongeldig” is geen betekenisvol predikaat — wel: convergent OK, divergent zwak voor de specifieke vergelijking met depressie.
OpmerkingVraag E3 — Sensitivity, specificity en cutoff-verschuiving
Een test op een continue score heeft bij cutoff : sensitivity , specificity . Bij cutoff : sensitivity , specificity .
Welke cutoff is geschikt voor screening op zeldzame aandoeningen waar missen kostbaar is?
Cutoff (hoge sensitivity).
Cutoff (hoge specificity).
Cutoff doet er niet toe.
Beide gelijkwaardig — kies op basis van PAC.
OpgeletAntwoord — open na je eigen poging
a) Bij screening op zeldzame aandoening: missen () kostbaar — false negatives zijn de gevreesde fout. Hogere sensitivity vereist; cutoff ( sensitivity) is geschikt. Lagere specificity () accepteer je: false positives gaan door naar definitief onderzoek, daar wordt het verder uitgezocht.
OpmerkingVraag E4 — Correctie voor attenuatie
Een onderzoeker rapporteert:
“De gecorrigeerde correlatie tussen werkstress en burn-out was .”
Reliabilities: (werkstress) , (burn-out) .
a) Bereken de rauwe correlatie die hieraan voorafging.
b) Wat is je oordeel over deze rapportage?
c) Welke twee elementen ontbreken in de zin?
OpgeletAntwoord — open na je eigen poging
a) . Een matige correlatie. De -presentatie maakt er een vrijwel perfecte samenhang van.
b) Misleidend. Een rauwe correlatie van is een ander verhaal dan een gecorrigeerde van . Zonder beide getallen + reliabilities erbij krijgt de lezer een vertekend beeld.
c) Ontbreken: (1) de rauwe , (2) de reliability-bronnen (-waarden) gebruikt voor correctie. Plus eventueel: , -waarde, betrouwbaarheids-interval rond .
R-practical opdrachtje
De das en de voorspelling
OpmerkingVraag E5 — Mini-classificatie bij de das
Een ecoloog meet bij 80 dassen een continue voorspelscore en een binaire uitkomst (ja/nee). De dataset staat in data/das_voorspelling.RData met das_id, voorspelscore, en uitkomst (factor: nee/ja).
a) Bereken de mediaan van voorspelscore als cutoff. Maak de classification table.
b) Bereken sensitivity, specificity, PPV, NPV en PAC.
c) Verschuif de cutoff naar het 75ste percentiel. Wat verandert er?
# (a) Cutoff op mediaan, classification table. Ja is positief -- ja is wat de# test moet vinden -- dus ja eerst, ook al staat in het bestand nee eerst.cutoff_med <-median(das_voorspelling$voorspelscore)das_voorspelling$voorspeld_med <-factor(ifelse(das_voorspelling$voorspelscore >= cutoff_med, "ja", "nee"),levels =c("ja", "nee"))das_voorspelling$werkelijk <-factor(das_voorspelling$uitkomst,levels =c("ja", "nee"))ct_med <-table(Werkelijk = das_voorspelling$werkelijk,Voorspeld = das_voorspelling$voorspeld_med)ct_med
         Voorspeld
Werkelijk ja nee
      ja  29   9
      nee 11  31
# (a) Cutoff op mediaan, classification table. Zelfde route als bij 3.2, ja eerst.cutoff_med <-median(das_voorspelling$voorspelscore)das_voorspelling <- das_voorspelling |>mutate(voorspeld_med =factor(if_else(voorspelscore >= cutoff_med, "ja", "nee"),levels =c("ja", "nee")),werkelijk =factor(uitkomst, levels =c("ja", "nee")) )ct_med <- das_voorspelling |>select(Werkelijk = werkelijk, Voorspeld = voorspeld_med) |>table()ct_med
         Voorspeld
Werkelijk ja nee
      ja  29   9
      nee 11  31
# (b) Zelfde route als bij 3.2.# ct_med[werkelijk, voorspeld] -- eerst de rij, dan de kolom.TP <- ct_med["ja", "ja"] # echt ja, test zegt jaFN <- ct_med["ja", "nee"] # echt ja, test zegt nee: gemistFP <- ct_med["nee", "ja"] # echt nee, test zegt ja: vals alarmTN <- ct_med["nee", "nee"] # echt nee, test zegt neesens <- TP / (TP + FN)spec <- TN / (TN + FP)PPV <- TP / (TP + FP)NPV <- TN / (TN + FN)PAC <- (TP + TN) /sum(ct_med)round(c(Sensitivity = sens, Specificity = spec,PPV = PPV, NPV = NPV, PAC = PAC), 3)
a) Cutoff op mediaan (); de classification table verdeelt de dassen over keer voorspeld ja en keer voorspeld nee.
b) Sens, spec, PPV, NPV, PAC liggen tussen en — matige tot redelijke voorspelling.
c) Cutoff op 75ste percentiel: minder dieren als “ja” geklassificeerd → specificity stijgt (minder false positives), sensitivity daalt (meer echte ja’s gemist). PPV stijgt vaak; PAC kan beide kanten op.
Bij dassen voorspelde de voorspelscore de binaire uitkomst met matige criterion-validity. Op de mediane cutoff: sensitivity , specificity , PPV , NPV , PAC . Bij verschuiving naar het 75ste percentiel verbeterde specificity ten koste van sensitivity, conform de cutoff-trade-off.
Construct + criterion validity met classification table en correctie voor attenuatie is de hoofdingang. Voor verdere studie:
Multitrait-multimethod-matrix (Campbell & Fiske 1959) — meerdere constructen × meerdere methoden om convergent en divergent expliciet te toetsen.
ROC-curves en AUC — pROC::roc(). Cutoff-vrije evaluatie van diagnostische tests.
Likelihood ratios — alternatief voor sensitivity/specificity dat base rate apart houdt.
Bayesian updating — bij bekende prior-prevalence en testkenmerken: update naar posterieure waarschijnlijkheid van de aandoening.
Net Reclassification Improvement (NRI) — als je twee modellen vergelijkt op classification.
Calibratie — niet alleen welke uitkomst voorspeld, maar ook of de voorspelde kansen kloppen.
Voor verdieping: Pepe (2003, The Statistical Evaluation of Medical Tests); Sackett et al. (2000, Evidence-Based Medicine); Streiner et al. (2015).
Aan het eind van de dag
De vos zat tegen de schemer en wachtte. Hij had niet veel meer te zeggen.
“Sensitivity en specificity,” zei hij eindelijk. “PPV en NPV. Vier getallen, twee richtingen door de tabel.”
“En correctie voor attenuatie?” vroeg de bunzing.
“Een goocheltruc,” zei de vos. “Mooi om te kennen, gevaarlijk om te gebruiken. Wie hem inzet zonder zijn rauwe correlatie erbij: ik vind hem.”
“En morgen?”
“PCA,” zei de vos. “Komt de rat tevoorschijn. Veel items, weinig dimensies — hij rangschikt ze.” Hij keek even naar de boom waar de rat zat. “Doe je best.”
De rat blikte even op, en zijn ogen glinsterden. “Eigenwaarden. Eindelijk.”
De bunzing kroop naar zijn hol. Boven het bos werd het donker, en de vos sloop weg, geruisloos zoals altijd.
Verantwoording
Dit oefenboek is geschreven voor studenten die psychometrie leren via R. Het is materiaal van CountCamp, geen officieel onderdeel van een opleiding. De voorbeelden, datasets, vragen en formuleringen zijn origineel; de didactische volgorde is dat bewust niet — die volgt de gangbare opbouw van Nederlandse universitaire psychometrie-cursussen. De gebruikte drempels en formules zijn standaard psychometrische conventies; verwijzingen naar Cronbach (1951), Campbell & Fiske (1959) en Streiner, Norman & Cairney (2015) volgen de gebruikelijke citaatpraktijk in dit veld.
Waar dit thema een eigen weg gaat. De classification table staat hier met de werkelijkheid in de rijen en de voorspelling in de kolommen, en dus sensitiviteit en specificiteit per rij, PPV en NPV per kolom; andere boeken draaien dat om. Eigen is hoe kader B dat laat onthouden — gegeven dat maakt de zaal kleiner, en wat erna komt is waar je door deelt — omdat die regel ook werkt als je de tabel een keer andersom tegenkomt. Eigen keuze is ook hoe streng dit thema doet over correctie voor attenuatie: je leert hier niet alleen de formule, maar ook dat je een gecorrigeerde correlatie nooit in je eentje rapporteert — de rauwe ernaast, beide betrouwbaarheden erbij, en een interval eromheen. En dat de twee betrouwbaarheden in 3.A verzonnen zijn, staat er met zoveel woorden bij: deze dataset heeft geen losse items, en dan valt er niets aan interne consistentie te berekenen. De indeling van kader A — content, construct met convergent en divergent, criterion met concurrent en predictive — is de klassieke; die indeling en die namen zijn niet van ons.
Zegt ander materiaal dat je gebruikt iets anders dan dit oefenboek, reken dan met wat daar staat. Meestal is het verschil een afspraak — een drempel, een letter, de naam van een model — en geen rekenfout.