| Drie groepen op creativiteit, uiterlijk en intelligentie | |||
| K | U | I | |
|---|---|---|---|
| nerds | 130 | 100 | 140 |
| politieagenten | 80 | 110 | 80 |
| chippendales | 130 | 140 | 110 |
| Note. K = creativiteit, U = uiterlijke schoonheid, I = intelligentie. | |||
4. Principal Component Analysis (PCA) — minder is meer
Het verhaal van dit thema
De rat zat op de schommel-tak en keek naar de nieuwe lijst van de wezel: twaalf items.
“Twaalf vragen,” zei hij. “Te veel.”
“Dat zegt iedereen,” zei de wezel. “Maar ze meten elk iets anders.”
“Dat zegt iedereen ook.” De rat tikte met zijn klauwtje op een blad. “Ik wil plaatjes zien. Twaalf cirkels in een ruimte, en kijken hoeveel er eronder liggen. Vier? Drie? Twee? Eén?”
“En dan?”
“Dan houden we drie. Of twee. En de rest gooien we weg.” De rat lachte zonder geluid. “Minder is meer.”
We beginnen niet bij de techniek. We beginnen bij drie groepen mensen en een mening.
Nerds, politieagenten en chippendales
Wat een gewicht doet
Stel, je meet drie groepen: nerds, politieagenten en chippendales. En je meet ze op drie dingen — hun creativiteit, hun uiterlijke schoonheid en hun intelligentie. Die drie kort ik af als K, U en I; de K omdat de C verderop al vergeven is aan de componenten.
En de chippendales, voor wie die naam niets zegt: een Amerikaanse stripteasegroep uit de jaren tachtig, beroemd genoeg om een soortnaam te worden. Vlinderdas, manchetten, verder vooral geen overhemd. Houd dat plaatje even vast, want het verklaart zo meteen hun rij in de tabel.
Normaal meet je natuurlijk geen drie dingen maar vijfentwintig of honderd. Drie is hier genoeg om te zien wat er gebeurt.
Kijk even naar de rijen. De nerds zijn creatief en hun intelligentie is sky high; hun uiterlijk valt te bezien. De chippendales scoren hoog op uiterlijk, zijn ook creatief, en hun intelligentie is ook best redelijk. De politieagenten zitten er op K en I onder.
Nu wil je die drie getallen per groep terugbrengen tot één getal. In thema 1 en 2 deed je dat al: je telde de items op (rowSums) of je nam het gemiddelde (rowMeans). Een totaalscore, een schaalscore.
Maar we gaan niet zomaar een gemiddelde nemen. We nemen een gewogen gemiddelde.
Dat ken je al — je tentamencijfer
Je deeltentamen 1 telt voor mee en deeltentamen 2 voor . Je haalt een en een . Wat is je cijfer?
Geen . Het ligt dichter bij de , want die trekt er harder aan.
Hoe reken je het uit? Er is een gezellige manier:
En er is de manier waarin je de gewichten kunt zien staan:
Allebei goed. Maar vanaf nu denken we in die tweede vorm, want daar staat wat we willen zien: wat is het gewichtje dat bij de eerste variabele hoort, en wat bij de tweede?
Dat heet een gewogen som — of, wat hetzelfde is, een gewogen gemiddelde. Een gepoold gemiddelde. Carpoolen: je neemt twee dingen samen en je kijkt naar de weging.
Mijn eerste weging: intelligentie is het belangrijkst
Ik vind in het leven intelligentie nu eenmaal belangrijker dan creativiteit of uiterlijk. Dus ik kies mijn gewichten zo:
Normaal ligt een gewichtje tussen en . Dat maakt hier niet uit — het gaat om het idee. Ruw is ruk, maar het is relatief.
Reken maar mee voor de nerds. Eerst elk gewicht keer zijn score, dan pas optellen:
Kijk waar het gewicht van terechtkomt: die ene regel is in zijn eentje groter dan de andere twee samen.
| Dezelfde drie groepen, teruggebracht tot één gewogen som | ||||
| K | U | I | C1 | |
|---|---|---|---|---|
| nerds | 130 | 100 | 140 | 920 |
| politieagenten | 80 | 110 | 80 | 590 |
| chippendales | 130 | 140 | 110 | 840 |
| Note. C1 = 2K + 1U + 4I. K = creativiteit, U = uiterlijke schoonheid, I = intelligentie. | ||||
Drie scores, teruggebracht tot één. En de nerds staan bovenaan, de politieagenten onderaan.
Hoe komt dat? Kijk naar de gewichten. Ik heb het grootste gewicht aan intelligentie gegeven, dus een score op weerspiegelt vooral intelligentie, en een beetje creativiteit, en nog een klein beetje uiterlijk.
En nu wordt het leuk, want nu ga ik interpreteren. Wat hebben de nerds in het gewone leven méér dan de politieagenten — iets wat je bereikt mét creativiteit, uiterlijk en intelligentie? Zoiets als maatschappelijk succes. En omdat intelligentie hier het zwaarst weegt, noem ik even de mate van intellectueel succes.
Ja, ik ben een beetje bevooroordeeld, en dat mag je horen.
Tweede weging, gewoon omdat het kan
Nu draai ik het om. Ik vind creativiteit nog steeds belangrijk, maar vandaag vind ik uiterlijk nóg belangrijker:
Reken het opnieuw uit. Zelfde tabel, zelfde getallen, andere gewichten.
| Twee wegingen van dezelfde drie eigenschappen | |||||
| K | U | I | C1 | C2 | |
|---|---|---|---|---|---|
| nerds | 130 | 100 | 140 | 920 | 800 |
| politieagenten | 80 | 110 | 80 | 590 | 680 |
| chippendales | 130 | 140 | 110 | 840 | 930 |
| Note. C1 = 2K + 1U + 4I. C2 = 2K + 4U + 1I. K = creativiteit, U = uiterlijke schoonheid, I = intelligentie. | |||||
Kijk wat er gebeurde. Op wonnen de nerds. Op winnen de chippendales.
Zelfde drie groepen. Zelfde negen getallen. Andere winnaar.
Dat is het hele punt van deze bladzijde: een gewogen som is een keuze, en die keuze bepaalt wie er bovenaan komt.
En interpreteren doe je weer. Met wat kom je het verst in het leven als vooral je uiterlijk meetelt? Dan is het niet zozeer intellectueel succes — dan is het, heel ruim genomen, zoiets als theatersucces. Een nerd heeft dat ook wel, maar niet zoveel als een chippendale, want daar heb je vooral uiterlijk voor nodig.
Allebei de wegingen in één plaatje
Nu heb je twee getallen per groep. Twee getallen, dat is een plek op papier: naar rechts, naar boven.
Toon code (de tekenaar die allebei de plaatjes maakt)
# Eén tekenaar voor allebei de figuren, om dezelfde reden als bij de
# ladingenplot verderop: de twee plaatjes moeten op precies één ding
# verschillen, namelijk of de pijlen er staan. Had elk zijn eigen tekencode,
# dan was een verschuiving van een punt niet te onderscheiden van een andere
# marge -- en dit stel beweert juist dat er niets verschoven is.
teken_biplot <- function(titel, ondertitel, pijlen = FALSE) {

  # Een vierkant venster om de drie groepen heen. Vierkant moet, want
  # coord_fixed() hieronder maakt een stap op de ene as even groot als op de
  # andere -- en zonder dat is elke hoek in dit plaatje een leugen.
  mid  <- c(C1 = mean(range(groepen$C1)), C2 = mean(range(groepen$C2)))
  half <- max(diff(range(groepen$C1)), diff(range(groepen$C2))) / 2 * 1.55

  # De pijlen beginnen in het midden van de drie groepen. Dat is geen
  # willekeurig punt: de plek van een groep is precies dat midden plus de drie
  # pijlen, elk keer hoeveel die groep op die eigenschap boven of onder het
  # gemiddelde zit. Nagerekend in de setup-chunk.
  anker <- c(C1 = mean(groepen$C1), C2 = mean(groepen$C2))

  # De lengte van een pijl is een tekenkeuze en geen meting -- in een biplot
  # mag je de pijlen als groep korter of langer maken zonder dat er iets aan
  # de boodschap verandert. Alle drie krijgen dezelfde factor, dus hun
  # onderlinge verhouding klopt wél. De langste pijl komt tot 0.38 van de
  # halve vensterbreedte -- zo blijft er ruimte over voor zijn eigen letter.
  schaal <- (0.38 * half) / max(sqrt(colSums(bi_pijl^2)))

  pijl_df <- data.frame(
    eigenschap = colnames(bi_pijl),
    xend = anker[["C1"]] + schaal * bi_pijl["C1", ],
    yend = anker[["C2"]] + schaal * bi_pijl["C2", ],
    # De letter staat in het verlengde van zijn eigen pijl, niet op een plek
    # die een uitwijk-algoritme kiest. Anders springt hij tussen de twee lagen.
    xtxt = anker[["C1"]] + schaal * 1.13 * bi_pijl["C1", ],
    ytxt = anker[["C2"]] + schaal * 1.13 * bi_pijl["C2", ])

  p <- ggplot(groepen, aes(C1, C2)) +
    geom_point(colour = "#1b6ca8", size = 3.2)

  if (pijlen) {
    p <- p +
      geom_segment(data = pijl_df,
                   aes(x = anker[["C1"]], y = anker[["C2"]],
                       xend = xend, yend = yend),
                   colour = "firebrick", linewidth = 0.7,
                   arrow = arrow(length = unit(0.18, "cm")),
                   inherit.aes = FALSE) +
      geom_point(x = anker[["C1"]], y = anker[["C2"]], colour = "firebrick",
                 size = 1.4, inherit.aes = FALSE) +
      # Blauw voor de groepen, rood voor de eigenschappen. Dat is het enige
      # kleurpaar dat bij deuteranopie uit elkaar blijft vallen; groen naast
      # het rood van de pijlen loopt daar in elkaar over.
      geom_text(data = pijl_df, aes(x = xtxt, y = ytxt, label = eigenschap),
                colour = "firebrick", size = 3.8, fontface = "bold",
                inherit.aes = FALSE)
  }

  # De naam van een groep staat aan de buitenkant: recht wég van het midden van
  # de drie. Uitgerekend uit die richting en niet per groep neergezet, zodat het
  # label meeschuift als de tabel bovenaan verandert -- en zodat allebei de
  # lagen het op exact dezelfde plek zetten.
  buiten <- cbind(groepen$C1 - anker[["C1"]], groepen$C2 - anker[["C2"]])
  buiten <- buiten / sqrt(rowSums(buiten^2))
  etiket <- data.frame(groep = groepen$groep,
                       x = groepen$C1 + 0.085 * half * buiten[, 1],
                       y = groepen$C2 + 0.085 * half * buiten[, 2])

  p +
    geom_text(data = etiket, aes(x = x, y = y, label = groep),
              colour = "#1b6ca8", size = 3.4,
              hjust = ifelse(buiten[, 1] < 0, 1, 0),
              vjust = ifelse(buiten[, 2] < 0, 1, 0),
              inherit.aes = FALSE) +
    coord_fixed(xlim = mid[["C1"]] + c(-half, half),
                ylim = mid[["C2"]] + c(-half, half)) +
    labs(x = expression(italic(C)[1] * " — intellectueel succes"),
         y = expression(italic(C)[2] * " — theatersucces"),
         title = titel, subtitle = ondertitel) +
    theme_minimal(base_size = 11) +
    theme(panel.grid.minor = element_blank())
}
Eerst alleen de drie groepen
Toon code (de drie groepen als punten)
teken_biplot(
  titel = "Drie groepen, twee wegingen, één plaatje",
  ondertitel = paste0(
    "Naar rechts is meer intellectueel succes, naar boven meer\n",
    "theatersucces. De ", winnaar_C1, " staan het verst naar rechts,\n",
    "de ", winnaar_C2, " het hoogst."))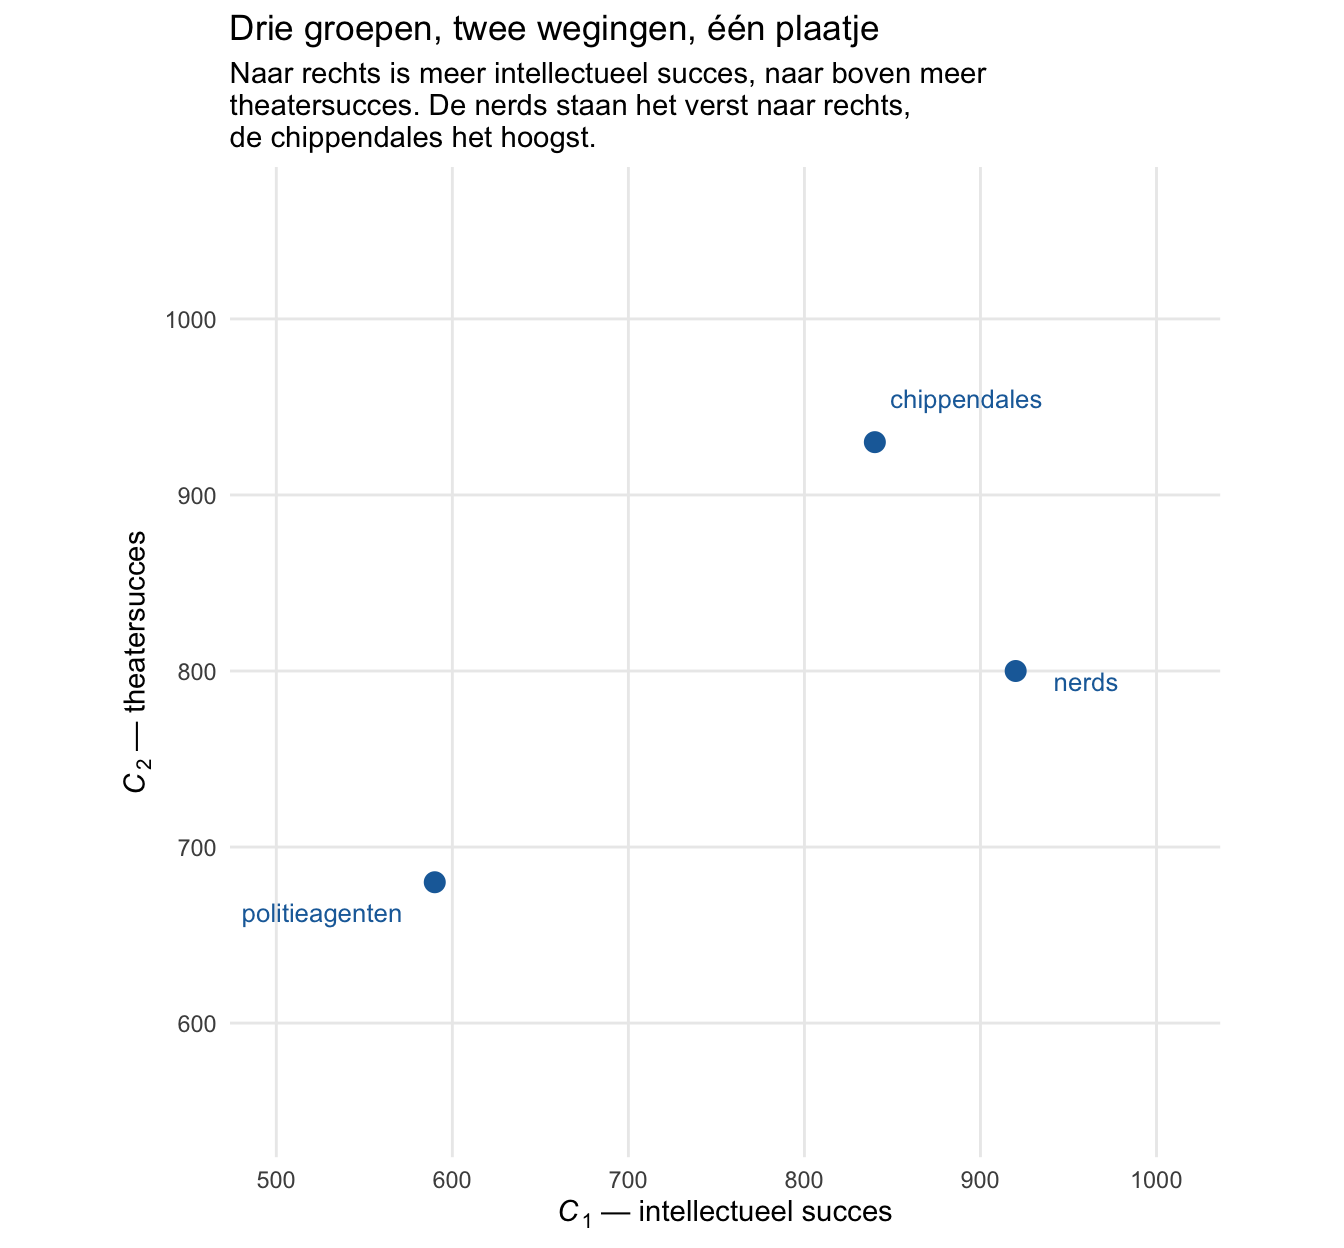
Twee tabellen zijn één plaatje geworden. Zoek de nerds maar op: 920 naar rechts, 800 omhoog — en daar staan ze.
De nerds en de chippendales liggen dicht bij elkaar, rechtsboven; de politieagenten liggen daar ver vandaan, linksonder, want die verliezen op allebei de wegingen. En kijk naar die twee bovenste: de nerds staan verder naar rechts, de chippendales staan hoger. Geen van beide doet allebei. Dat je op de ene as kunt winnen en op de andere niet, zie je hier in één oogopslag.
En nu de eigenschappen erover
Maar waaróm ligt een groep waar hij ligt? Daarvoor moeten de drie eigenschappen zelf het plaatje in. En dat kan, want een eigenschap heeft hier een richting.
Kijk nog eens naar de twee wegingen. Intelligentie weegt op en op . Eén punt meer intelligentie schuift een groep dus naar rechts en omhoog — dat is een pijl. Bij uiterlijk is het net andersom, en bij creativiteit is het allebei .
Toon code (dezelfde figuur, met de drie eigenschappen erover)
teken_biplot(
  titel = "Dezelfde drie groepen, nu met de eigenschappen erbij",
  ondertitel = paste0(
    "Elke pijl wijst de kant op waar een groep heen schuift als hij op\n",
    "die eigenschap hoger scoort. Intelligentie (I) trekt naar rechts,\n",
    "uiterlijk (U) naar boven, creativiteit (K) precies daartussenin."),
  pijlen = TRUE)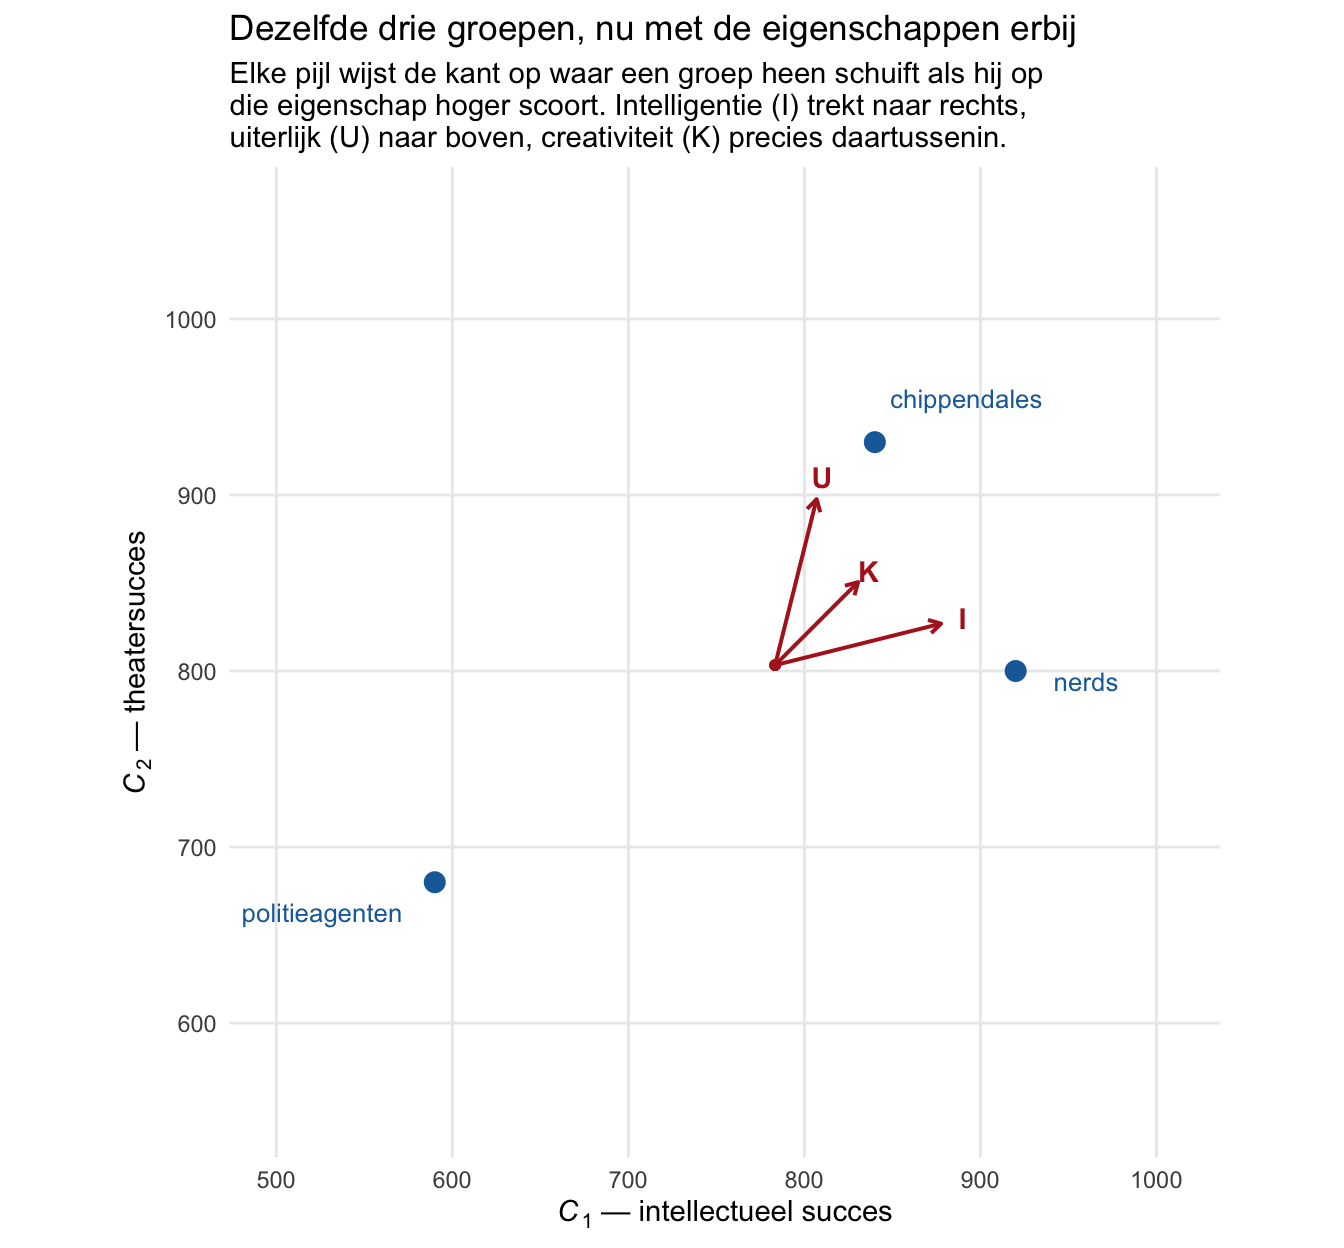
De drie stippen zijn geen millimeter verschoven; er is alleen een laag bijgekomen. En dat rode stipje in het midden, waar de pijlen uit komen, is de gemiddelde groep — daar kom je zo nog op terug.
Dus wat heb je nu ontdekt? Dat deze vragenlijst van drie items eigenlijk twee richtingen heeft. Een intellectuele-succes-richting als je de items op die ene manier weegt, en een theatersucces-richting als je ze op die andere manier weegt. Misschien zijn dat wel de enige twee wegingen die je wilt hebben. En dan zeg je: ik had drie items, maar dat interesseert me niet meer — ik heb het teruggebracht tot twee nieuwe dingen.
Dat is het gevoel. De rest van dit thema is dat gevoel, met machines erbij.
Wat R hier van maakt
De gewichtjes worden gezocht in plaats van gekozen
In het verhaal hierboven koos ík de gewichten. , en , omdat ik dat vond.
Vandaag geef je R die items en zeg je: ga jij maar zoeken of je richtingen vindt.
En wat R dan doet is dit. Hij gaat kijken of die gewichtjes een bepaalde waarde kunnen hebben, zódanig dat er iets zinvols uitkomt — en zinvol betekent hier eerst statistisch: zit er een heftige richting in, een richting waarin veel variatie zit. En als hij die gevonden heeft, zegt hij: leuk, en gaat hij verder zoeken. Kunnen we nóg andere gewichtjes verzinnen? Dat wordt dan de tweede component.
Dat is dezelfde vorm als mijn en hierboven. Alleen staan er nu letters op de plek van de gewichten, want R moet ze nog invullen.
Let op de twee cijfertjes onder de , want die volgorde ligt vast en je komt hem het hele hoofdstuk tegen: eerst het item, dan de component. Dus is het gewicht van item op component , en is het gewicht van datzelfde item op component . Op de eerste regel loopt het eerste cijfertje dus op — de items komen langs — terwijl het tweede op blijft staan.
Vul je in zo’n formule de itemscores van één persoon in, dan rolt er één getal uit: zijn componentscore. Hoe hoog scoort deze persoon op component ? De 920 van de nerds was er al zo een — alleen voor een hele groep, en met gewichten die ik zelf koos. Zo’n componentscore kun je daarna als schaalscore gebruiken in een volgende analyse, net zoals je in thema 1 een somscore gebruikte.
En dán, als de gewichten er staan, gaan we ze interpreteren. Dat is op zich subjectief, en daar zit eigenlijk de hele crux.
Meneer Holland en de honderd vragen
Reductie, op ware grootte
Holland was een psycholoog die onderzoek deed naar persoonlijkheid en beroepen. Zijn gedachte: als je een bepaalde persoonlijkheid hebt, vind je waarschijnlijk een bepaald beroep leuk. Dat is nogal handig om te weten.
Dus stelde hij heel veel vragen. Denk aan een vragenlijst van honderd items over alledaagse dingen — hoe vaak speel je een muziekinstrument, hoe vaak ga je boodschappen doen, verzin het maar.
Kun je je voorstellen dat sommige van die items met elkaar correleren?
En wat betekent het als twee items correleren? Dat de kans er is dat ze hetzelfde meten, of ongeveer hetzelfde. Speel je vaak muziek, componeer je, en schrijf je vaak gedichten — dan ben je waarschijnlijk creatief. Iets in die trant.
Even rekenen: bij honderd items heb je cellen in de correlatiematrix, min de honderd op de diagonaal is , en omdat elke correlatie er twee keer in staat houd je er over. Dat kun je niet even met het oog bekijken.
Waar het bij mij begon
Ik was tweeëntwintig, en tot dat moment vond ik statistiek saai. Echt saai. Het ging altijd over twee dingen: kun je iets voorspellen, en is er verschil? Is er verschil, is er verschil, is er verschil. Ik dacht in die tijd in derde en vierde afgeleiden — laat los wat dat precies zijn, het komt erop neer dat ik al bezig was met hoe een verandering zélf verandert — en dan krijg je een vak voorgeschoteld dat vraagt of twee gemiddeldes niet toevallig hetzelfde zijn.
Toen kreeg ik zo’n vragenlijst onder statistiek, ingevuld en wel, met bij elke invuller zijn beroep erbij. En ik kreeg er een techniek bij die je hier niet verwacht: geen PCA, maar discriminant-analyse.
Die stelt de vraag namelijk andersom, en dat is makkelijker te zien als je de twee routes naast elkaar legt.
De ene route zoekt groepjes items: welke vragen correleren hoog met elkaar en laag met de rest? Want dan meet zo’n groepje waarschijnlijk één ding. Dat is de route van dit hoofdstuk, en daar komen we zo op.
Discriminant-analyse gaat de andere kant op. Die begint bij groepen mensen die je al kent — bij mij waren dat de beroepen, want die stonden erbij — en zoekt dan de gewogen som van die honderd items die deze beroepen zo ver mogelijk uit elkaar trekt.
Zo’n gewogen som heet een discriminant-functie. Er kwamen er drie uit. Drie functies zijn drie assen, en elke as heeft twee uiteinden, dus dat geeft zes kanten. En die zes bleken precies te zijn wat meneer Holland allang had opgeschreven — alleen had hij ze bedacht en niet gevonden. Zes types, op zijn gevoel en met de vakliteratuur ernaast.
Let op het verschil dat hier telt. De beróepen kende ik: die stonden gewoon in het bestand. De zes types kende ik niet. Die kwamen eruit.
Op de ene as stonden de creatieve beroepen aan de ene kant: kunstenaars, muzikanten, dichters, schrijvers.
En nu de leuke vraag. Welke beroepen denk je dat aan de andere kant van die as zaten — dus welke persoonlijkheid is het mínst creatief?
Politiemensen. Holland noemde die kant conventional. Niet conservatief — dat woord leest als een politieke kleur, en het gaat hier over hoe je werkt. De as loopt van volgend naar zelf bepalend. Een agent voert uit: hij volgt regels, hij bepaalt niet zelf wat er moet gebeuren. Een kunstenaar bepaalt het juist wél zelf, en dat is zo’n beetje zijn hele vak. Vandaar dat die twee zo ver uit elkaar liggen.
Boekhouders horen hier ook thuis, en die van jou wil je precies hier hebben: als de boekhouding optelt tot wat het moet zijn, dan is het klaar.
Op een andere as stonden de investigative beroepen — wetenschappers. Niet toevallig vlak naast de creatievelingen, want voor wetenschap moet je ook creatief zijn. En daar tegenover: de enterprising beroepen, ondernemers. Waar priesters ook onder vielen.
Wat hebben een priester en een ondernemer gemeen, en wat onderscheidt ze allebei van een wetenschapper? Dat is dezelfde vraag, twee kanten op. Een echte wetenschapper is op zoek naar de waarheid. Een ondernemer boeit die waarheid niet zo — die verkoopt een waarheid. Net als een priester: dat is geen zoektocht maar iets wat je oplepelt. Misschien is het juist die onzekerheid van de wetenschap die de twee kanten scheidt.
En dan nog de sociale beroepen tegenover de realistische. Realistisch betekent hier niet “intelligent” maar vooral tastbaar: timmermannen en monteurs, mensen die met gereedschap werken. Als de deur past, dan klopt het. In de sociale beroepen zijn we pas blij als we elkaar begrijpen, en daar is niets tastbaars aan.
En daar zat ik dan, met drie assen uit een vragenlijst waar ik van tevoren niks van wist. Dit was niet is er verschil. Dit was een wereld die openging: je kunt van honderd dingen tegelijk vragen wat ze sámen doen. Zo’n optelling-met-gewichten heet een lineaire combinatie — een deftiger naam voor de gewogen som die je hierboven zelf hebt uitgerekend. Ik kende hem van de middelbare school, maar daar ging hij over lijnen en vlakken. Hier ging hij ineens over mensen.
En het gekste komt nog. Zo’n discriminant-functie — zo’n as — is gewoon een gewogen gemiddelde. Precies dat tentamencijfer van een paar bladzijden terug, alleen met honderd deelcijfers in plaats van twee. Aan de vorm is niets bijzonders. Het bijzondere is de weging: dat er ergens één stel gewichten ligt dat die beroepen zo ver mogelijk uit elkaar trekt, en dat je dat stel kunt vinden. Dát vond ik machtig, en dat vind ik nog steeds.
Vandaag maak jij dezelfde beweging, met één verschil. Ik zocht de weging met het grootste onderscheid tussen de beroepsgroepen. PCA kent helemaal geen groepen en zoekt de weging waarin de scores van de mensen het verst uit elkaar liggen. Zelfde machine, andere vraag.
Nu pas de puntenwolk
Hoeveel richtingen zitten er in een plat vlak?
Neem even twee items, en . Denk aan een wiskundeproefwerk: is een kale rekenvraag (“bereken de top van de parabool”) en is zo’n verhaaltjessom, met een taalverhaal eromheen.
Zijn die twee gecorreleerd? Ja — slimme mensen doen ze allebei goed en domme mensen allebei fout.
Teken de puntenwolk. Positief verband, dus van linksonder naar rechtsboven.
Nu een trucje: haal de assen weg en kijk alleen naar de wolk. Is het nog dezelfde wolk? Ja. De puntjes hebben ten opzichte van elkaar nog steeds dezelfde positie — de relatieve configuratie is niet veranderd.
Beschrijf die wolk nu nog eens. Wat zie je vooral gebeuren?
Eerst het simpele feit: de puntjes hebben niet allemaal dezelfde positie. Ze variëren. Maar hóe variëren ze? Vooral in één richting: van linksonder naar rechtsboven.
Zijn we het eens dat die puntjes op een plat vlak liggen? Dus hoeveel dimensies heeft dit figuur? Twee. Een plat vlak heeft er twee.
Maar een plat vlak heeft niet één richting — het heeft er twee. Dus waar gaat de tweede heen?
Er haaks op. Negentig graden. Zoals de breedte altijd haaks op de lengte staat, en bij lengte-breedte-hoogte precies hetzelfde verhaal. Daar heb je misschien nooit over nagedacht, maar zo kiezen we het altijd.
En nu zijn de richtingen op.
Met twee items houd je twee richtingen over, en dat is geen reductie. Maar je hebt normaal geen twee items — je hebt er vijfentwintig. Dan heb je ook vijfentwintig richtingen, en ga je kijken naar alleen de belangrijkste: die waar veel variatie zit. Als je van vijfentwintig naar drie of vier gaat en je kunt die vier interpreteren, dan heb je wat je zocht.
Dat is ook precies wat de Big Five is: honderd gedragingen, teruggebracht tot vijf assen. En dat is trouwens wat een taalmodel met woorden doet — elk woord krijgt een richting in een ruimte met heel veel dimensies. Oom wijst ongeveer dezelfde kant op als man, met een kleine hoek ertussen, want ze meten iets vergelijkbaars. En tante staat in diezelfde kleine hoek naast vrouw.
Onthoud die hoek. Een kleine hoek tussen twee richtingen betekent gecorreleerd. Een rechte hoek betekent: die twee hebben niets met elkaar te maken. Daar komen we bij het roteren op terug.
Werkmaterialen — R-pakketten en functies
De rat pakt zijn gereedschap
| Gereedschap | Waar het voor is | Pakket |
|---|---|---|
psych::principal() |
PCA met rotatie, ladingen en communaliteiten | psych |
eigen() |
Eigenwaarden en eigenvectoren van de correlatiematrix | base |
psych::scree() |
Scree plot | psych |
psych::fa.parallel() |
Scree plot met parallel analysis erbij (dat laatste is een extra van dit oefenboek) | psych |
psych::KMO() |
Sampling adequacy | psych |
psych::cortest.bartlett() |
Bartlett’s test of sphericity | psych |
prcomp() |
Base-R PCA (geen rotatie ingebouwd) | base |
Notatie — symbolen voor PCA
Wat je doet als je een vragenlijst valideert
De hele route, op één bladzijde
Vanaf hier gaat dit hoofdstuk één lange PCA doen, in stukjes. Zes stappen. Hieronder staan ze bij elkaar, zodat je onderweg weet waar je bent — en zodat je later kunt terugslaan zonder het hele hoofdstuk opnieuw te lezen.
| wat je doet | waar het staat | |
|---|---|---|
| 1 | Kijk eerst naar je data. Verdelingen, ontbrekende waarden, en vooral de correlatiematrix: zitten er groepjes items in die onderling hoog correleren? | 4.1.a |
| 2 | Toets de voorwaarden. Genoeg dieren per item — en de twee formele voorvragen, KMO en Bartlett. Haalt KMO de grens niet, dan meld je dat en kijk je verder: in zijn eentje beslist hij niet. | 4.1.b |
| 3 | Bepaal hoeveel componenten. Drie criteria: eigenwaarde boven (het Kaiser-criterium), de elleboog in de scree plot, en interpreteerbaarheid — dat laatste beslis je pas echt bij stap 4 en 5. Hoeveel variantie je vangt is geen vierde criterium: het zit al in de elleboog, de plek waar de verklaarde variantie ineens minder hard daalt. In zijn eentje kan het nooit beslissen, want elke extra component verklaart iets. | 4.1.c en 4.1.d |
| 4 | Roteer en interpreteer. Lees de ladingen, kijk welke items bij elkaar horen, en geef elke component een naam. | 4.2.a tot en met 4.2.d |
| 5 | Draai hem opnieuw met een ander aantal componenten. Eén keer minder, één keer meer. Wordt de interpretatie er beter of slechter van? ⟲ terug naar stap 3 | 4.2.e |
| 6 | Beslis op inhoud, niet op statistiek. En schrijf op wat je nu weet over je vragenlijst. | 4.2.e, en de modelzin in 4.2.d |
Let op dat pijltje bij stap 5. Dit is geen lijstje dat je één keer van boven naar beneden afloopt. Bij stap 5 herzie je het getal dat je bij stap 3 koos — je legt het model gewoon een ander aantal componenten op — en loopt daarmee opnieuw door stap 4 heen. Dat is geen teken dat je iets fout deed; zo hoort het. Een vragenlijst valideer je niet in één rechte lijn.
En stap 6 is waar het om begonnen was. In thema 3 keek je van buitenaf naar de construct-validiteit van een test, met andere tests ernaast. Vandaag kijk je van binnenuit.
Want je doet dit niet om componenten te verzamelen. Vallen de items uiteen in de groepjes die de ontwerper bedoeld had? Dan gedragen ze zich zoals het construct voorspelt, en dat is steun voor de construct-validiteit van die lijst. Vallen ze ánders uiteen, dan heb je iets geleerd dat je niet zocht.
4.0 Project- en datavoorbereiding
install.packages(c("tidyverse", "psych"))

# Alleen nodig als je de ladingenplot verderop zelf wilt natekenen:
install.packages("ggrepel")load("data/bos_dieren_dimensies.RData")
str(bos_dieren_dimensies)'data.frame': 200 obs. of 14 variables:
$ dier_id : Factor w/ 200 levels "d001","d002",..: 1 2 3 4 5 6 7 8 9 10 ...
$ diersoort: Factor w/ 4 levels "bunzing","egel",..: 4 1 2 2 1 3 4 4 1 4 ...
$ p1 : num 3 2 4 2 3 3 4 3 4 2 ...
$ p2 : num 3 2 4 3 4 3 5 4 4 1 ...
$ p3 : num 2 2 3 5 4 3 4 4 4 2 ...
$ p4 : num 3 3 3 3 4 3 3 4 3 2 ...
$ a1 : num 3 3 4 4 4 4 3 3 4 2 ...
$ a2 : num 3 2 5 3 3 4 2 3 3 3 ...
$ a3 : num 3 2 4 3 4 4 4 4 5 3 ...
$ a4 : num 2 2 4 3 4 3 4 4 3 4 ...
$ u1 : num 3 2 5 2 3 4 1 3 2 4 ...
$ u2 : num 4 3 5 3 3 3 3 5 3 4 ...
$ u3 : num 3 3 5 3 2 3 2 3 3 2 ...
$ u4 : num 3 4 5 3 4 3 2 4 2 4 ...Per dier: dier_id, diersoort, en twaalf items op een -puntsschaal. Vier over piekeren (p1 tot en met p4), vier over alertheid (a1 tot en met a4), vier over uitstelgedrag (u1 tot en met u4). Eén ontbrekende waarde op p3.
200 bosdieren dus, en 80 kraaien in de mini-dataset voor E7.
Let op dat die drie groepjes van vier de bedoeling van de ontwerper zijn, niet een uitkomst. Of de data zich daar iets van aantrekt, moet nog blijken.
items <- c("p1","p2","p3","p4","a1","a2","a3","a4","u1","u2","u3","u4")4.1 PCA — preconditie-checks en eigenwaarden
Hoeveel richtingen zitten erin?
“Eigenwaarden zijn aantal,” zei de rat. “Eerst hoeveel. Daarna welke.”
T2 — Wanneer PCA, en wanneer iets anders?
4.1.a Verkenning — correlatiematrix
Vandaag kijken we in de test zelf. Als twee items hoog correleren, meten ze waarschijnlijk hetzelfde. Dus voordat er één component berekend wordt: kijk naar de correlaties.
Net als in de vorige thema’s staan een paar stappen in twee schrijfwijzen naast elkaar: base R vooraan, en dat is het enige dat je zelf moet kunnen typen; dplyr staat ernaast om te kijken, en overslaan mag. Ze geven dezelfde getallen.
cor_mat <- cor(bos_dieren_dimensies[, items], use = "complete.obs")
round(cor_mat, 2)
p1 p2 p3 p4 a1 a2 a3 a4 u1 u2 u3 u4
p1 1.00 0.55 0.49 0.54 0.25 0.12 0.35 0.25 0.11 0.17 0.09 0.10
p2 0.55 1.00 0.50 0.56 0.27 0.17 0.27 0.31 0.07 0.12 0.08 0.11
p3 0.49 0.50 1.00 0.48 0.23 0.17 0.24 0.27 0.11 0.12 0.09 0.13
p4 0.54 0.56 0.48 1.00 0.25 0.23 0.29 0.33 0.12 0.20 0.17 0.20
a1 0.25 0.27 0.23 0.25 1.00 0.52 0.49 0.51 0.26 0.28 0.18 0.23
a2 0.12 0.17 0.17 0.23 0.52 1.00 0.53 0.47 0.29 0.31 0.21 0.23
a3 0.35 0.27 0.24 0.29 0.49 0.53 1.00 0.52 0.31 0.37 0.20 0.28
a4 0.25 0.31 0.27 0.33 0.51 0.47 0.52 1.00 0.29 0.25 0.17 0.23
u1 0.11 0.07 0.11 0.12 0.26 0.29 0.31 0.29 1.00 0.55 0.50 0.53
u2 0.17 0.12 0.12 0.20 0.28 0.31 0.37 0.25 0.55 1.00 0.57 0.59
u3 0.09 0.08 0.09 0.17 0.18 0.21 0.20 0.17 0.50 0.57 1.00 0.52
u4 0.10 0.11 0.13 0.20 0.23 0.23 0.28 0.23 0.53 0.59 0.52 1.00library(dplyr)
# select() kiest de twaalf itemkolommen. all_of() zegt erbij dat de namen in
# het rijtje `items` staan, en niet hier in de code.
cor_mat <- bos_dieren_dimensies |>
select(all_of(items)) |>
cor(use = "complete.obs")
round(cor_mat, 2) p1 p2 p3 p4 a1 a2 a3 a4 u1 u2 u3 u4
p1 1.00 0.55 0.49 0.54 0.25 0.12 0.35 0.25 0.11 0.17 0.09 0.10
p2 0.55 1.00 0.50 0.56 0.27 0.17 0.27 0.31 0.07 0.12 0.08 0.11
p3 0.49 0.50 1.00 0.48 0.23 0.17 0.24 0.27 0.11 0.12 0.09 0.13
p4 0.54 0.56 0.48 1.00 0.25 0.23 0.29 0.33 0.12 0.20 0.17 0.20
a1 0.25 0.27 0.23 0.25 1.00 0.52 0.49 0.51 0.26 0.28 0.18 0.23
a2 0.12 0.17 0.17 0.23 0.52 1.00 0.53 0.47 0.29 0.31 0.21 0.23
a3 0.35 0.27 0.24 0.29 0.49 0.53 1.00 0.52 0.31 0.37 0.20 0.28
a4 0.25 0.31 0.27 0.33 0.51 0.47 0.52 1.00 0.29 0.25 0.17 0.23
u1 0.11 0.07 0.11 0.12 0.26 0.29 0.31 0.29 1.00 0.55 0.50 0.53
u2 0.17 0.12 0.12 0.20 0.28 0.31 0.37 0.25 0.55 1.00 0.57 0.59
u3 0.09 0.08 0.09 0.17 0.18 0.21 0.20 0.17 0.50 0.57 1.00 0.52
u4 0.10 0.11 0.13 0.20 0.23 0.23 0.28 0.23 0.53 0.59 0.52 1.004.1.b KMO en Bartlett
Twee formele voorvragen. Bartlett’s test of sphericity toetst of de correlatiematrix verschilt van een identiteitsmatrix — dus of er überhaupt samenhang tussen de items zit.
Je wilt dat Bartlett significant is, maar dat betekent in de praktijk weinig: met echte psychologische data is hij vrijwel altijd significant. Tien psychologische variabelen die helemaal niets met elkaar te maken hebben, vind je bijna nooit — zeker niet als ze uit hetzelfde domein komen, en bij een PCA doen ze dat eigenlijk altijd. Een significante Bartlett zegt dus weinig; alleen een níét-significante zegt iets: dan hangt er vrijwel niets samen, en betekent een PCA niets.
De KMO-maat (Kaiser-Meyer-Olkin) vergelijkt twee soorten correlaties. De zero-order-correlaties zijn de gewone correlaties tussen twee items, zonder correctie — die ken je al, alleen niet onder deze naam. De partiële correlaties zijn dezelfde correlaties nadat de overlap met alle andere items eruit gehaald is. KMO deelt de som van alle gekwadrateerde gewone correlaties door diezelfde som plús de som van alle gekwadrateerde partiële correlaties:
Zie de noemer als twee stapels. Hangen je items echt als groep samen, dan verklaren de andere items het meeste van wat twee items delen. Na de correctie blijft er dan weinig over: de partiële correlaties zijn klein, de tweede stapel is bijna leeg, en de breuk komt dicht bij . Blijven er na de correctie nog flinke partiële correlaties over, dan loopt de samenhang niet netjes als groep, en zakt KMO.
KMO ligt altijd tussen en . Dit hoofdstuk houdt aan als voldoende. Andere bronnen zijn milder: op de schaal van Kaiser heten de ’s nog matig mediocre, en is pas alles onder onaanvaardbaar. Rond zit je bij items die als groep níéts delen: dan zijn de twee stapels ongeveer even groot.
Van die twee voorvragen is KMO de nuttigste. Bartlett zegt bij echte data bijna altijd ja; KMO zegt hoe netjes de samenhang als groep loopt, en daar gaat het bij een PCA om.
Onder de grens is geen stopbord. Een lage KMO kan ook bij items die wél bij elkaar horen: met maar een paar items per groepje blijft de tweede stapel flink gevuld, ook als de structuur netjes is. Bij de kraaien in E7 zie je dat, en daar staat ook waarom.
Haalt KMO de niet, dan zeg je dat eerlijk, en dan kijk je verder, naar twee dingen:
- De correlatiematrix. Zie je groepjes items die onderling duidelijk hoger correleren dan met de rest? Dat is een patroon, geen telling.
- De oplossing. Kun je de componenten straks een naam geven?
Pas met die twee erbij beslis je of je doorgaat. Wat je dan op een tentamen opschrijft, oefen je in E4.
Je leest soms dat KMO tussen (het slechtste geval) en ligt. Die is alleen geen bodem: de tweede stapel kan ook groter zijn dan de eerste, en bij items die niets met elkaar delen komt KMO vaker net onder de uit dan erboven. Aan wat als voldoende telt verandert dat niets. Dat blijft de .
R geeft KMO op twee niveaus: één getal voor de hele set (MSA) en één per item (MSAi). MSA staat voor measure of sampling adequacy — het is dus geen tweede maat maar dezelfde, per item uitgesplitst.
# KMO -- sampling adequacy.
psych::KMO(cor_mat)
Kaiser-Meyer-Olkin factor adequacy
Call: psych::KMO(r = cor_mat)
Overall MSA = 0.85
MSA for each item =
p1 p2 p3 p4 a1 a2 a3 a4 u1 u2 u3 u4
0.80 0.85 0.88 0.84 0.88 0.83 0.86 0.88 0.87 0.84 0.84 0.85 # Bartlett's test of sphericity. Geef hem het aantal dieren waar cor_mat op
# rust: complete.obs liet het dier met de ontbrekende p3 vallen.
n_compleet <- sum(complete.cases(bos_dieren_dimensies[, items]))
psych::cortest.bartlett(cor_mat, n = n_compleet)$chisq
[1] 854.7273
$p.value
[1] 1.57542e-137
$df
[1] 664.1.c Eigenwaarden en verklaarde variantie
Elke richting heeft een eigenwaarde (λ) — niet van meneer Eigen, het is gewoon de naam. Hoe groter, hoe meer variatie die component vangt.
# eigen() geeft de eigenwaarden van groot naar klein, en opgeteld zijn ze
# precies het aantal items. Daarom is eigenwaarde / length(ev) een aandeel: de
# VAF. cumsum() telt van boven naar beneden op.
ev <- eigen(cor_mat)$values
data.frame(
  component   = seq_along(ev),
  eigenwaarde = round(ev, 3),
  VAF         = round(ev / length(ev), 3),
  cumulatief  = round(cumsum(ev) / length(ev), 3)
)
component eigenwaarde VAF cumulatief
1 1 4.281 0.357 0.357
2 2 2.120 0.177 0.533
3 3 1.373 0.114 0.648
4 4 0.588 0.049 0.697
5 5 0.554 0.046 0.743
6 6 0.539 0.045 0.788
7 7 0.505 0.042 0.830
8 8 0.473 0.039 0.869
9 9 0.454 0.038 0.907
10 10 0.417 0.035 0.942
11 11 0.367 0.031 0.972
12 12 0.331 0.028 1.000# De eigenwaarden komen nog steeds uit eigen(); dplyr bouwt alleen de tabel
# eromheen, en mutate() zet er kolommen bij.
#
# Nieuw is n(): die telt de rijen van dít tabelletje. Eén per component,
# evenveel als er items zijn -- niet het aantal dieren.
#
# cumsum() telt de VAF-kolom van boven naar beneden op. Base R telt eerst op en
# deelt dan: dezelfde getallen.
ev <- eigen(cor_mat)$values
data.frame(component = seq_along(ev), eigenwaarde = ev) |>
mutate(VAF = eigenwaarde / n(),
cumulatief = cumsum(VAF)) |>
round(3) component eigenwaarde VAF cumulatief
1 1 4.281 0.357 0.357
2 2 2.120 0.177 0.533
3 3 1.373 0.114 0.648
4 4 0.588 0.049 0.697
5 5 0.554 0.046 0.743
6 6 0.539 0.045 0.788
7 7 0.505 0.042 0.830
8 8 0.473 0.039 0.869
9 9 0.454 0.038 0.907
10 10 0.417 0.035 0.942
11 11 0.367 0.031 0.972
12 12 0.331 0.028 1.0004.1.d Scree plot en parallel analysis
Een scree plot zet de eigenwaarden op volgorde in een figuur. Scree is Engels voor puin. Sta op een berg, kiep een kar puin naar beneden, en kijk waar het blijft liggen: op het stuk waar de helling horizontaal wordt. Dat is de knik, de elleboog: het punt waar de lijn overgaat van steil naar minder steil.
Let op dat woord minder. Een punt waar de lijn van steil naar steiler gaat is een verkeerde knik.
Toon code (scree plot + parallel analysis)
psych::fa.parallel(bos_dieren_dimensies[, items],
                   fa          = "pc",
                   n.iter      = 50,
                   show.legend = TRUE,
                   main        = "Scree plot en parallel analysis")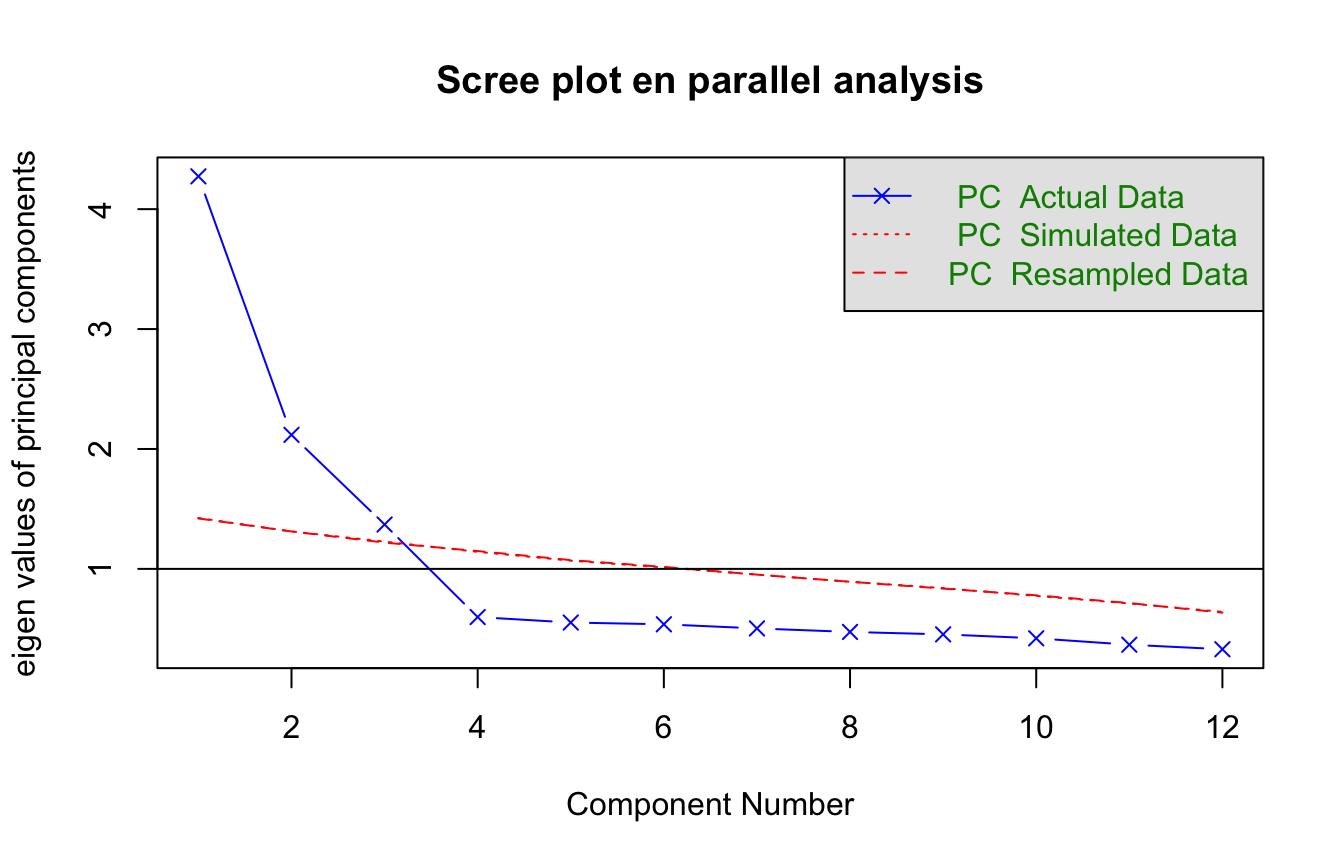
Parallel analysis suggests that the number of factors = NA and the number of components = 3 4.2 Componentladingen en rotatie
Welke items horen bij welke richting?
“Eigenwaarden zijn aantal,” zei de rat. “Ladingen zijn structuur.”
Een componentlading is het gewichtje van een item in een component — en je mag hem lezen als een correlatie tussen dat item en die component. Gewichtje, coëfficiënt, correlatie: hier is het hetzelfde ding. We nemen als grenswaarde voor “die hoort erbij”.
4.2.a Ongeroteerde PCA
pca_unrot <- psych::principal(bos_dieren_dimensies[, items],
                              nfactors = 3,
                              rotate   = "none",
                              use      = "complete")
print(pca_unrot, cut = 0.30, digits = 2)
Principal Components Analysis
Call: psych::principal(r = bos_dieren_dimensies[, items], nfactors = 3,
rotate = "none", use = "complete")
Standardized loadings (pattern matrix) based upon correlation matrix
PC1 PC2 PC3 h2 u2 com
p1 0.55 0.53 0.66 0.34 2.5
p2 0.55 0.57 0.67 0.33 2.3
p3 0.51 0.50 0.58 0.42 2.5
p4 0.60 0.46 0.65 0.35 2.3
a1 0.65 -0.47 0.64 0.36 1.8
a2 0.61 -0.53 0.67 0.33 2.0
a3 0.70 -0.37 0.63 0.37 1.5
a4 0.66 -0.41 0.61 0.39 1.7
u1 0.57 -0.52 0.62 0.38 2.1
u2 0.64 -0.50 0.71 0.29 2.2
u3 0.51 -0.52 0.36 0.66 0.34 2.8
u4 0.58 -0.49 0.67 0.33 2.5
PC1 PC2 PC3
SS loadings 4.28 2.12 1.37
Proportion Var 0.36 0.18 0.11
Cumulative Var 0.36 0.53 0.65
Proportion Explained 0.55 0.27 0.18
Cumulative Proportion 0.55 0.82 1.00
Mean item complexity = 2.2
Test of the hypothesis that 3 components are sufficient.
The root mean square of the residuals (RMSR) is 0.05
with the empirical chi square 54.41 with prob < 0.011
Fit based upon off diagonal values = 0.98Drie dingen in die uitvoer die er niet uitgelegd staan:
h2is de communaliteit, enu2is precies wat er overblijft: . Die twee tellen per rij altijd op tot . Haal die kolom niet door elkaar met het itemu2uit het uitstelgedrag-blok: het item staat links als rijnaam, dezeu2staat bovenaan als kolomkop.- Onderaan staat
SS loadings. Dat is de som van de gekwadrateerde ladingen per kolom — oftewel de eigenwaarde λ. R noemt hem alleen niet zo. De regel eronder,Proportion Var, is diezelfde λ gedeeld door het aantal items: de proportie verklaarde variantie. - Lege cellen zijn niet nul. Die zijn weggelaten door
cut = 0.30; er staat gewoon een kleiner getal. Zetcut = 0en je ziet ze.
Houd die u2 even vast, want volgende week krijgt hij een eigen pijl. In thema 5 tekent elk item er een pijltje van opzij bij — zijn error — en wat daarin zit heet in de uitvoer zijn residuvariantie. Het is dan geen restje meer dat overblijft maar een deel van het model. Dat komt doordat de vergelijking omdraait. Hier bouw je de component uít de items:
En in thema 5 komt het item juist uit de factoren, met een rest:
Let op dat die geen meer is. Een component maak je uít de items; een factor zit eronder en veroorzaakt ze. Het is met opzet een andere letter, want het is een ander soort ding.
En die rest is de u2 van hierboven. Zelfde getal, andere rol: hier valt het overschot buiten de boot, daar hoort het bij het model.
4.2.b Varimax-rotatie
Orto betekent recht. Denk aan de orthodontist — waarom ga je daarheen? Om je tanden recht te zetten. Onthoud dat maar: orto is recht, oftewel een hoek van negentig graden. Bij een orthogonale rotatie zoals varimax blijven de assen dus precies haaks op elkaar staan, en blijven de componenten ongecorreleerd.
Wat je met roteren wilt bereiken, heet simple structure: alle ladingen zo dicht mogelijk bij of bij (of ). Per item dus: hoog op één component, en zo dicht mogelijk bij nul op de andere.
Varimax zoekt die stand met één getal, en dat zie je het best aan twee kolommen naast elkaar. Kwadrateer de ladingen van één component. Op de eerste ongeroteerde component liggen die kwadraten allemaal tussen en : dicht op elkaar, weinig variantie. Na varimax staan er in de eerste kolom, RC1, vier tussen en — de uitstelgedrag-items — en de andere acht tussen en : ver uit elkaar, veel variantie. Een paar grote en de rest bijna nul — dat ís simple structure.
Varimax draait de assen dus tot die variantie, opgeteld over alle componenten, zo groot mogelijk is. In één zin: varimax maximaliseert de som van de varianties van de gekwadrateerde ladingen.
pca_var <- psych::principal(bos_dieren_dimensies[, items],
                            nfactors = 3,
                            rotate   = "varimax",
                            use      = "complete")
print(pca_var, cut = 0.30, digits = 2)
Principal Components Analysis
Call: psych::principal(r = bos_dieren_dimensies[, items], nfactors = 3,
rotate = "varimax", use = "complete")
Standardized loadings (pattern matrix) based upon correlation matrix
RC1 RC2 RC3 h2 u2 com
p1 0.80 0.66 0.34 1.1
p2 0.80 0.67 0.33 1.1
p3 0.75 0.58 0.42 1.1
p4 0.78 0.65 0.35 1.2
a1 0.77 0.64 0.36 1.2
a2 0.80 0.67 0.33 1.1
a3 0.73 0.63 0.37 1.4
a4 0.74 0.61 0.39 1.3
u1 0.75 0.62 0.38 1.2
u2 0.81 0.71 0.29 1.2
u3 0.81 0.66 0.34 1.0
u4 0.80 0.67 0.33 1.1
RC1 RC2 RC3
SS loadings 2.64 2.61 2.52
Proportion Var 0.22 0.22 0.21
Cumulative Var 0.22 0.44 0.65
Proportion Explained 0.34 0.34 0.32
Cumulative Proportion 0.34 0.68 1.00
Mean item complexity = 1.1
Test of the hypothesis that 3 components are sufficient.
The root mean square of the residuals (RMSR) is 0.05
with the empirical chi square 54.41 with prob < 0.011
Fit based upon off diagonal values = 0.98De kolommen heten nu RC1, RC2 en RC3 in plaats van PC1, PC2 en PC3. De R staat voor rotated: psych zegt daarmee zelf dat je naar een geroteerde oplossing kijkt.
TipEen communaliteit is een overlap — net als r²
Het Venn-diagram ken je al van correlatie: één cirkel per variabele, en elke cirkel is álle variatie in die variabele. Omdat alles gestandaardiseerd is, telt die variatie als . Waar twee cirkels overlappen, bewegen de twee variabelen samen. Die overlap is , de proportie verklaarde variantie — en niet , want het plaatje telt oppervlakte, en die oppervlakte is variantie: iets met kwadraten.
Een communaliteit is hetzelfde plaatje, alleen met meer cirkels. Neem a3: daar zijn alle drie de plakjes goed te zien.
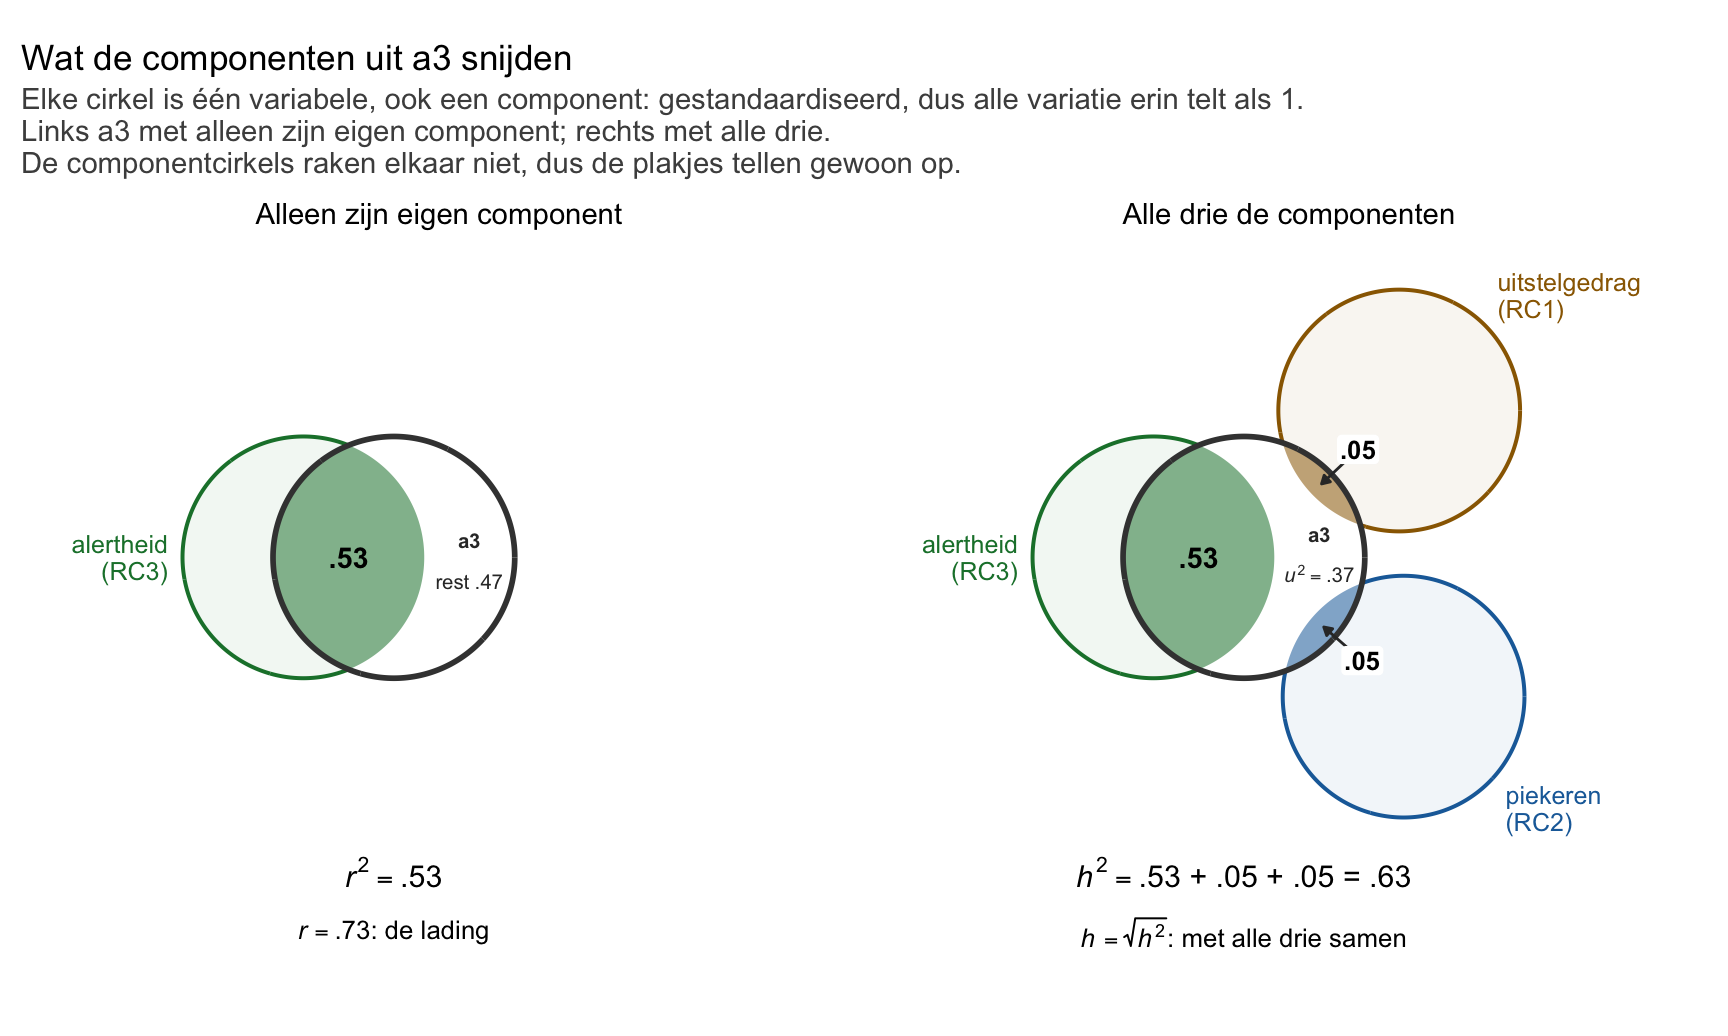
- Alleen zijn eigen component. Een lading mag je lezen als een correlatie tussen item en component. De lading van
a3op alertheid (in de uitvoerRC3) is , dus de overlap is : een gewone . - Alle drie. Zet de andere twee componenten erbij. Hun ladingen zijn klein, en — zo klein dat
cut = 0.30ze in de uitvoer hierboven weglaat. Toch snijdt elke component een eigen plakje uita3: voor uitstelgedrag (RC1) en voor piekeren (RC2). - Optellen. Kijk naar de kieren tussen de drie componentcirkels: ze raken elkaar níét, want na varimax zijn de componenten ongecorreleerd. De plakjes zijn dus los, en dan mag je ze gewoon optellen: . Dat is de communaliteit : het deel van de variatie in
a3dat de drie componenten samen terugverklaren. Eerst kwadrateren, dan optellen.
Wat er rechts binnen de zwarte rand van a3 wit blijft, is het restje . Links, met alleen zijn eigen component, bleef er nog wit; de twee kleine plakjes halen er en af, en rechts blijft er over: .
En de wortel? Zoals de wortel van weer de lading geeft, is ook een correlatie: die van a3 met de drie componenten samen, niet met één. Ken je meervoudige regressie, dan is dit een oude bekende: zet a3 als Y en de drie componenten als voorspellers, dan is gelijk aan , en dus aan .
Waar het plaatje ophoudt. Het laat alleen groottes zien: een lading van snijdt een even groot plakje als een van , want bij het kwadrateren valt het minnetje weg. En het werkt alleen zolang de componentcirkels elkaar niet raken. Straks, bij oblimin in 4.2.d, mogen de componenten correleren. Dan overlappen ook hún cirkels, en is een lading alleen nog een gewichtje, geen correlatie meer. Optellen klopt dan niet meer, en niet één kant op: bij a3 komt het sommetje eronder uit, bij andere items erboven. Waarom, zie je bij 4.2.d.
Wat rotatie wél en niet verandert
Dit is het scherpste stukje van dit thema, en het is ook een tentamensommetje.
Draaien we de assen, dan veranderen de ladingen. Alle ladingen. Dus je zou denken dat alles verandert. Maar er zijn twee dingen die precies hetzelfde blijven, en één die verschuift.
Neem de communaliteit van een item — over de rij kwadrateren en dan optellen.
| De communaliteit van een item verandert niet door rotatie | |||
| item | h² ongeroteerd | h² varimax | verschil |
|---|---|---|---|
| p1 | .659 | .659 | .000 |
| p2 | .672 | .672 | .000 |
| p3 | .578 | .578 | .000 |
| p4 | .654 | .654 | .000 |
| a1 | .637 | .637 | .000 |
| a2 | .671 | .671 | .000 |
| a3 | .632 | .632 | .000 |
| a4 | .613 | .613 | .000 |
| u1 | .621 | .621 | .000 |
| u2 | .706 | .706 | .000 |
| u3 | .663 | .663 | .000 |
| u4 | .666 | .666 | .000 |
| Note. h² = communaliteit: de som van de gekwadrateerde ladingen van een item over de drie behouden componenten – een som die mag omdat de componenten in allebei deze kolommen ongecorreleerd zijn. Het grootste werkelijke verschil tussen de twee kolommen bedraagt 1.4 × 10⁻¹⁵; de kolom verschil toont dat op drie decimalen en is dus overal .000. | |||
Nul. Over de hele linie, tot op 15 decimalen achter de komma nul.
Dat is ook logisch als je het je voorstelt. De communaliteit zegt hoeveel van een item door de drie componenten samen wordt teruggegeven. Draai je die drie assen als één geheel rond, dan blijft het item op dezelfde plek in de ruimte liggen — je bekijkt hem alleen vanuit een andere hoek. Hoe goed hij gevangen wordt, verandert daar niet van.
De eigenwaarden verschuiven wél:
| De eigenwaarden verschuiven wel, maar hun som niet | ||||
| λ ongeroteerd | λ varimax | VAF ongeroteerd | VAF varimax | |
|---|---|---|---|---|
| component 1 | 4.28 | 2.64 | .357 (35.7%) | .220 (22.0%) |
| component 2 | 2.12 | 2.61 | .177 (17.7%) | .218 (21.8%) |
| component 3 | 1.37 | 2.52 | .114 (11.4%) | .210 (21.0%) |
| samen | 7.77 | 7.77 | .648 (64.8%) | .648 (64.8%) |
| Note. λ = eigenwaarde: de som van de gekwadrateerde ladingen van alle items op één component. VAF = variance accounted for, oftewel λ gedeeld door het aantal items (12): de proportie verklaarde variantie, met het percentage tussen haakjes. Som van de drie eigenwaarden: 7.77 ongeroteerd en 7.77 na varimax. | ||||
De eerste component levert in, de andere twee winnen. Dat is precies wat roteren doet: het herverdeelt de variantie over de componenten, in plaats van alles op de eerste te stapelen.
Maar het totaal blijft staan: 64.8% ongeroteerd en 64.8% na varimax. Rotatie verschuift wat; het totaal blijft hetzelfde.
4.2.c Plaatjes — de ladingenplot
Een tabel met ladingen is niets anders dan een setje coördinaten. Zet ze in een assenstelsel en je ziet meteen wat er aan de hand is.
Om dat te kunnen tékenen nemen we even acht items en twee componenten — alleen p1–p4 en a1–a4. Met drie componenten kun je de draaiing niet meer op papier volgen.
Je krijgt hem in drie plaatjes: vóór, de draai, en ná. Het derde is degene waar het om gaat.
Toon code (de tekenaar die alle drie de plaatjes maakt)
# Eén tekenaar voor alle drie de figuren, en dat is geen zuinigheid. De drie
# plaatjes moeten op precies één ding verschillen: de getallen die erin gaan.
# Zou elk zijn eigen tekencode hebben, dan wordt een verschil in stijl -- een
# andere cirkel, een andere schaal -- op de bladzijde niet van een verschil in
# de data te onderscheiden. En dit hoofdstuk beweert straks dat er niets
# veranderd is.
teken_ladingen <- function(L, xlab, ylab, titel, ondertitel, assen = NULL) {
  lad <- as.data.frame(L)
  names(lad) <- c("C1", "C2")
  lad$item   <- rownames(L)
  lad$blok   <- ifelse(startsWith(lad$item, "p"), "piekeren", "alertheid")

  p <- ggplot(lad, aes(C1, C2)) +
    annotate("path",
             x = cos(seq(0, 2 * pi, length.out = 200)),
             y = sin(seq(0, 2 * pi, length.out = 200)),
             colour = "grey85") +
    geom_hline(yintercept = 0, colour = "grey55") +
    geom_vline(xintercept = 0, colour = "grey55")

  # De rode assen gaan er vóór de pijlen in, zodat de pijlen bovenop liggen.
  if (!is.null(assen)) {
    p <- p + geom_segment(data = assen,
                          aes(x = x, y = y, xend = xend, yend = yend),
                          colour = "firebrick", linewidth = 0.7,
                          inherit.aes = FALSE)
  }

  p +
    geom_segment(aes(x = 0, y = 0, xend = C1, yend = C2, colour = blok),
                 arrow = arrow(length = unit(0.18, "cm")), linewidth = 0.8) +
    # Vier van de acht namen liggen minder dan twee graden uit elkaar, dus
    # ggrepel in plaats van een vaste nudge -- anders vallen p2/p3 en a3/a4
    # letterlijk over elkaar heen.
    ggrepel::geom_text_repel(aes(label = item, colour = blok),
                             size = 3.4, show.legend = FALSE,
                             min.segment.length = 0.15, seed = 4,
                             box.padding = 0.55, point.padding = 0.25,
                             force = 8, max.overlaps = Inf,
                             segment.size = 0.3, segment.alpha = 0.6) +
    # Blauw en groen: bij deuteranopie versmelt oranje met het rood van de
    # assen, en dan lopen de alertheid-pijlen en de as C2-na-rotatie in elkaar
    # over.
    scale_colour_manual(values = c(piekeren = "#1b6ca8", alertheid = "#1a7f37"),
                        name = NULL) +
    # Ladingen zijn begrensd op 1 en krijgen dus geen voorloopnul, ook niet op
    # een aslabel.
    scale_x_continuous(breaks = seq(-1, 1, 0.5), labels = apa) +
    scale_y_continuous(breaks = seq(-1, 1, 0.5), labels = apa) +
    coord_fixed(xlim = c(-1.15, 1.15), ylim = c(-1.15, 1.15)) +
    labs(x = xlab, y = ylab, title = titel, subtitle = ondertitel) +
    theme_minimal(base_size = 11) +
    theme(panel.grid.minor = element_blank(),
          legend.position  = "bottom")
}
Eén — vóór de rotatie
Dit is wat rotate = "none" je geeft. Assen recht, pijlen waar ze vallen.
Toon code (de ongeroteerde oplossing)
teken_ladingen(
  fig_u,
  xlab  = expression(italic(C)[1] * " ongeroteerd"),
  ylab  = expression(italic(C)[2] * " ongeroteerd"),
  titel = "Vóór de rotatie: acht items in de twee-componentenruimte",
  ondertitel = paste0(
    "Alle acht wijzen naar rechts: allemaal positief op C1.\n",
    "Verticaal splitst het — piekeren onder de as, alertheid erboven.\n",
    "Geen van beide assen loopt door een bundel heen."))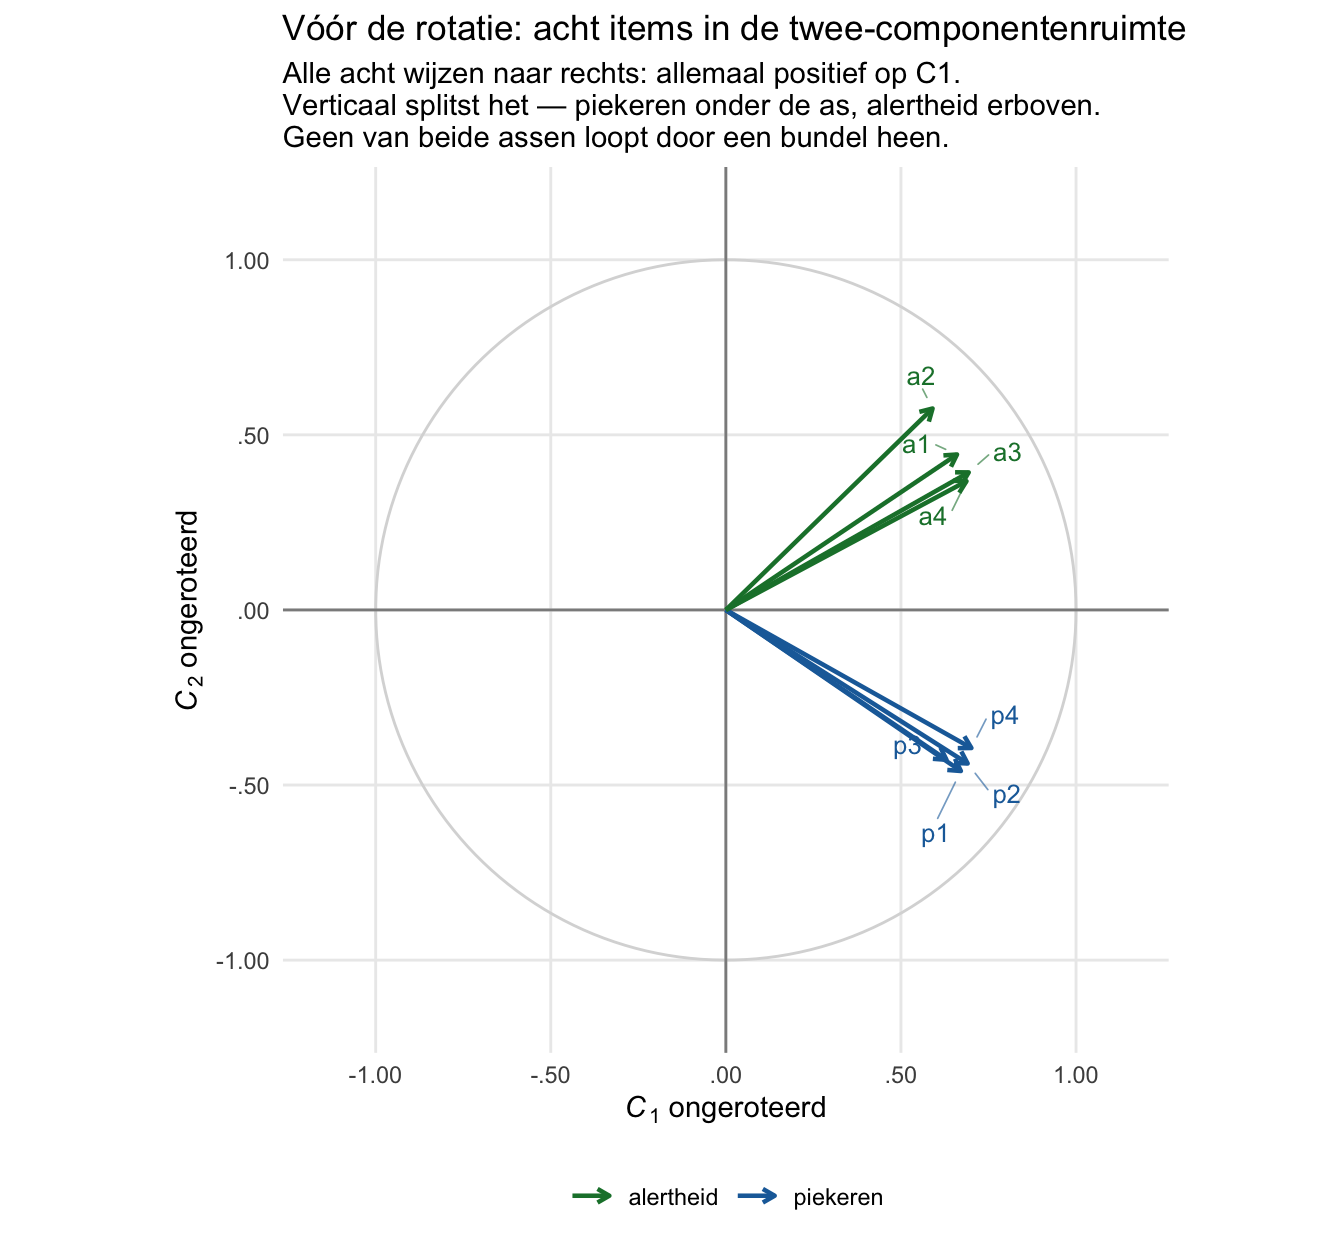
Alle acht wijzen naar rechts, en geen van de twee assen loopt door een bundel heen. Dat is de ongeroteerde oplossing die je in 4.2.a in getallen zag: een eerste component die alles optelt, en een tweede die het verschil doet. Leesbaar is het niet — je kunt geen enkele as een naam geven.
Twee — de draai
Toon code (ladingenplot met geroteerde assen)
# De geroteerde assen: de kolommen van de rotatiematrix, doorgetrokken
# naar beide kanten zodat het een as wordt en geen pijl.
as_lijnen <- data.frame(
  x    = -1.05 * Rot[1, ], y    = -1.05 * Rot[2, ],
  xend =  1.05 * Rot[1, ], yend =  1.05 * Rot[2, ],
  naam = c("C1 na rotatie", "C2 na rotatie")
)

teken_ladingen(
  fig_u,
  xlab  = expression(italic(C)[1] * " ongeroteerd"),
  ylab  = expression(italic(C)[2] * " ongeroteerd"),
  titel = "De draai: dezelfde acht items, met de nieuwe assen erover",
  ondertitel = paste0(
    "Recht en grijs: de ongeroteerde assen.\n",
    "Schuin en rood: dezelfde twee richtingen na varimax, ",
    graden(abs(fig_hoek)), "° met de klok mee\ngedraaid en nog steeds ",
    fig_haaks, "° uit elkaar."),
  assen = as_lijnen) +
  annotate("text", x = as_lijnen$xend[1], y = as_lijnen$yend[1],
           label = "italic(C)[1]*' na rotatie'", parse = TRUE,
           colour = "firebrick", hjust = -0.05, vjust = 1.4, size = 3.2) +
  annotate("text", x = as_lijnen$xend[2], y = as_lijnen$yend[2],
           label = "italic(C)[2]*' na rotatie'", parse = TRUE,
           colour = "firebrick", hjust = -0.02, vjust = -0.8, size = 3.2)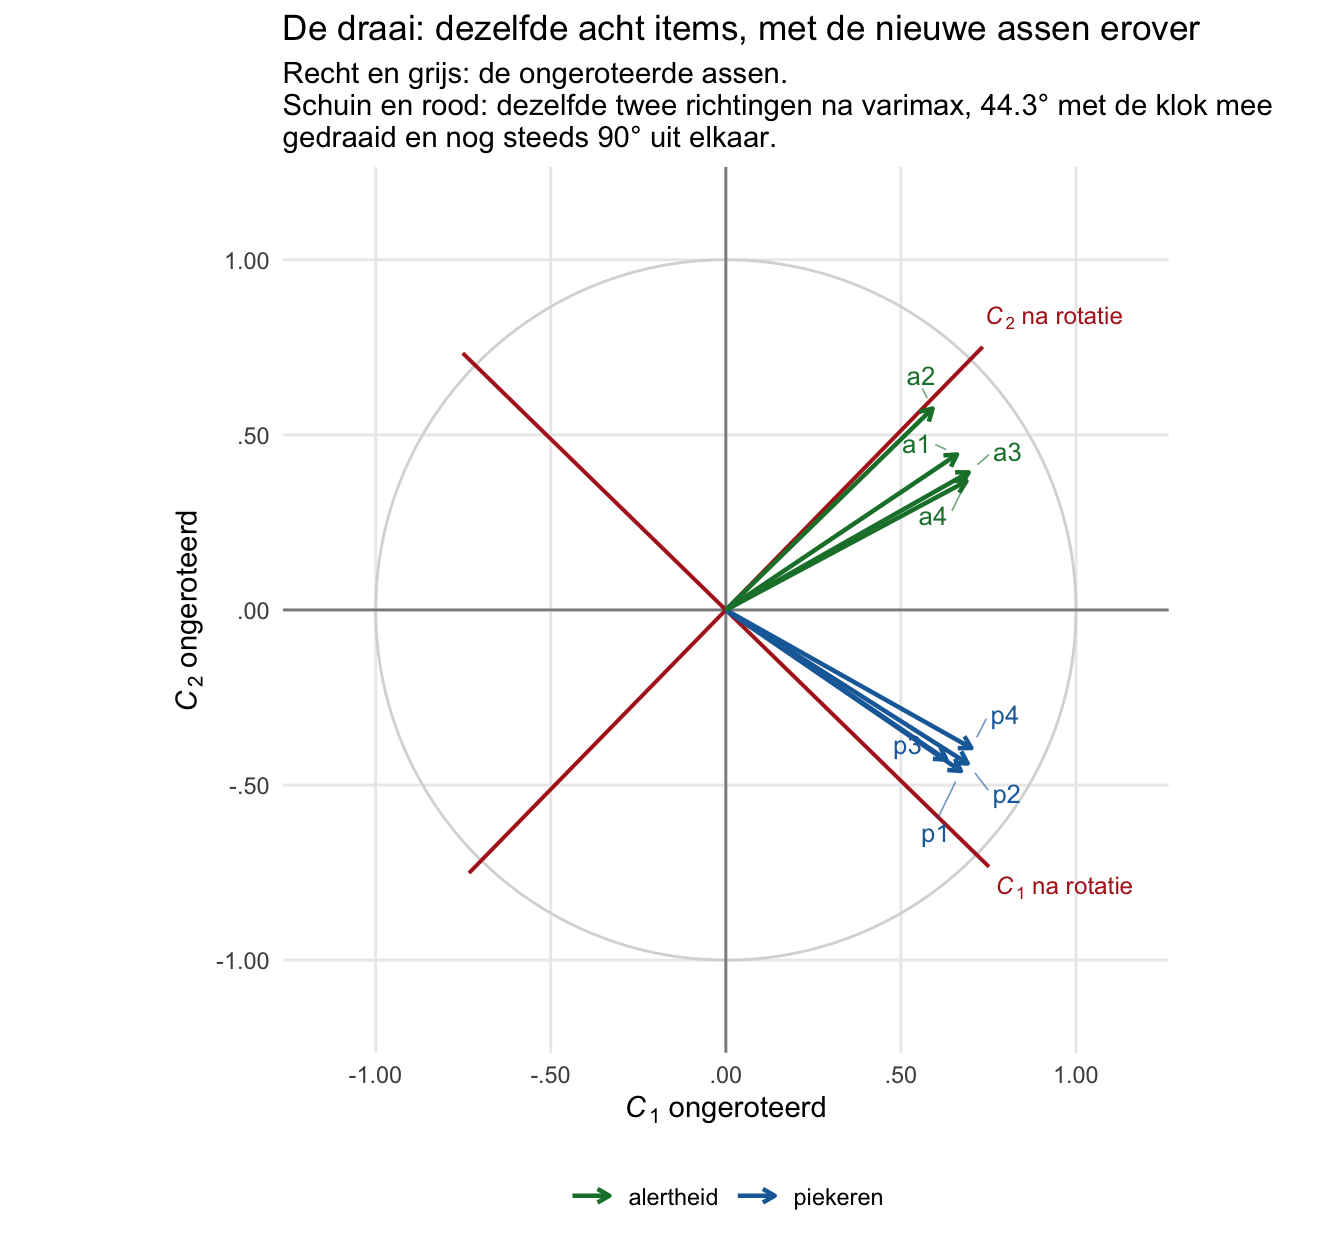
Drie — ná de rotatie
En dan het plaatje dat je in een artikel te zien krijgt.
Want zo staat het er daar niet bij. Niemand tekent twee assenkruizen over elkaar heen; er staat één stel assen, recht, met de items eromheen. De draai is uit beeld verdwenen — niet weggemoffeld, gewoon klaar. Dus rechten we de rode assen: we leggen ze horizontaal en verticaal neer en kijken er recht op.
Toon code (de geroteerde oplossing, recht vooruit)
teken_ladingen(
  fig_v,
  xlab  = expression(italic(C)[1] * " na rotatie"),
  ylab  = expression(italic(C)[2] * " na rotatie"),
  titel = "Ná de rotatie: dezelfde acht items, gewone assen",
  ondertitel = paste0(
    "Elke as loopt nu door een bundel. Piekeren ligt langs C1,\n",
    "alertheid langs C2, en allebei dicht bij nul op de andere.\n",
    "Ten opzichte van elkaar is er niets veranderd."))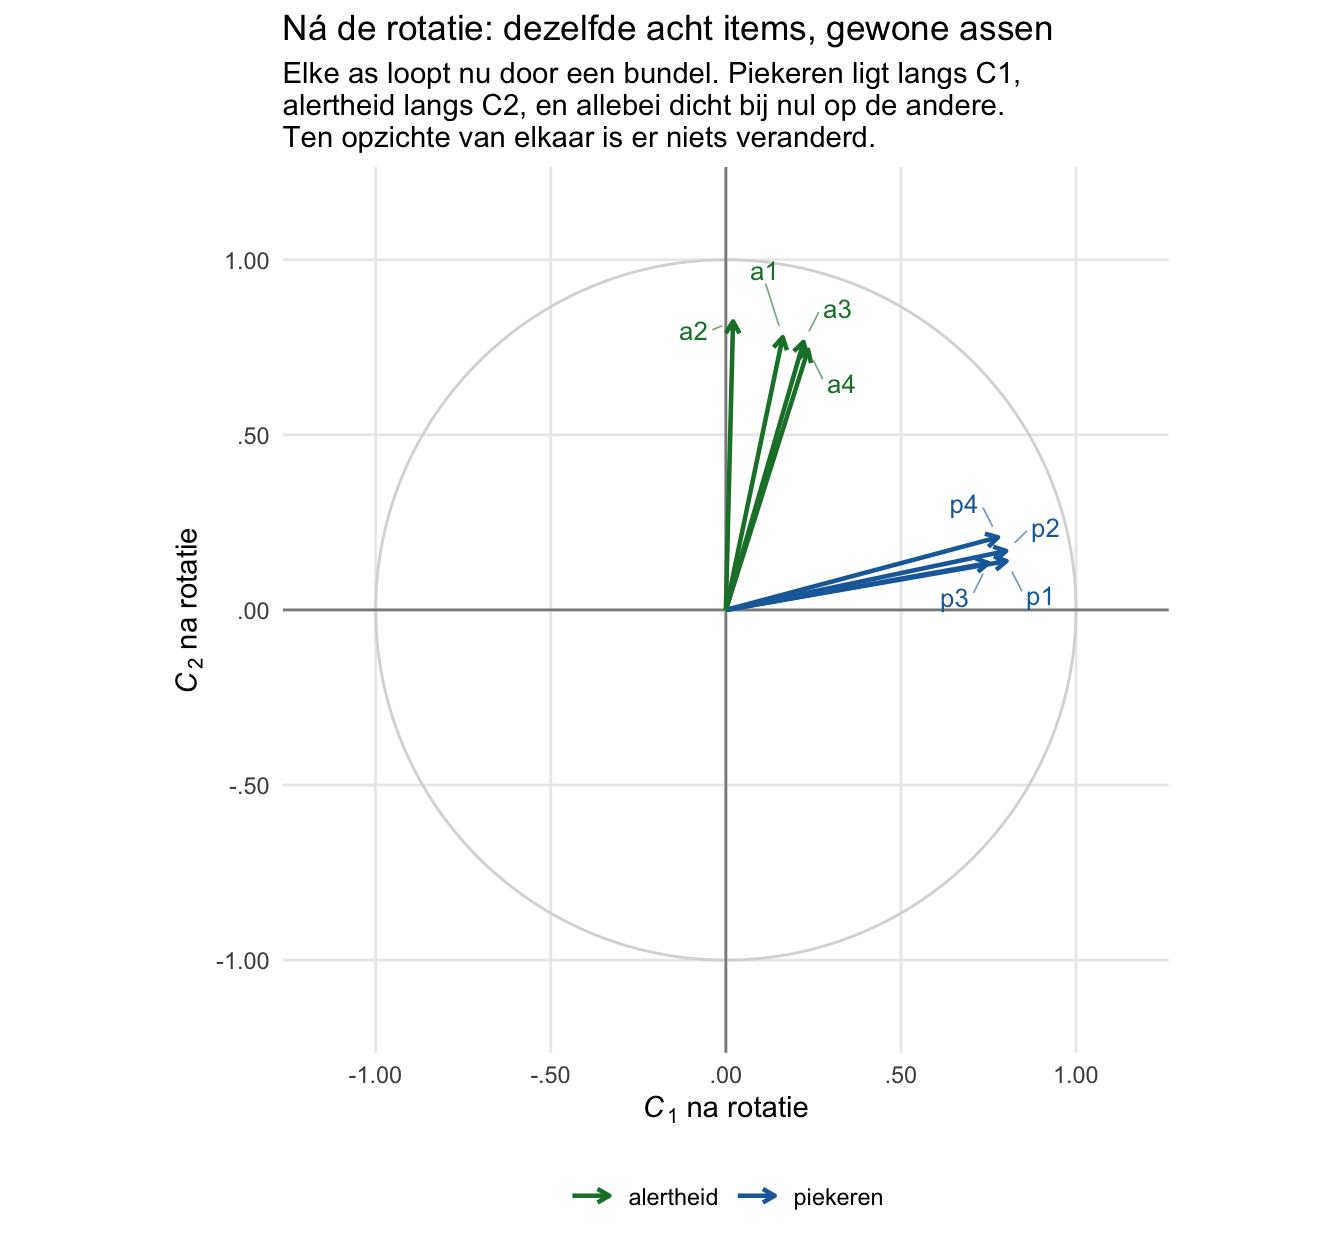
4.2.d Oblimin — moeten die assen wel haaks?
Varimax dwingt de componenten ongecorreleerd. Maar wie zegt dat dat terecht is?
Bij intelligentie zijn de dimensies vaak wél gecorreleerd — ruimtelijk inzicht hangt samen met taalvermogen. Bij een oblique rotatie zoals oblimin mogen de assen scheef staan, en mogen de componenten dus correleren.
pca_obl <- psych::principal(bos_dieren_dimensies[, items],
                            nfactors = 3,
                            rotate   = "oblimin",
                            use      = "complete")
print(pca_obl, cut = 0.30, digits = 2)
Principal Components Analysis
Call: psych::principal(r = bos_dieren_dimensies[, items], nfactors = 3,
rotate = "oblimin", use = "complete")
Standardized loadings (pattern matrix) based upon correlation matrix
PC3 PC2 PC1 h2 u2 com
p1 0.82 0.66 0.34 1.0
p2 0.81 0.67 0.33 1.0
p3 0.76 0.58 0.42 1.0
p4 0.78 0.65 0.35 1.0
a1 0.80 0.64 0.36 1.0
a2 0.85 0.67 0.33 1.0
a3 0.73 0.63 0.37 1.1
a4 0.75 0.61 0.39 1.0
u1 0.75 0.62 0.38 1.1
u2 0.80 0.71 0.29 1.0
u3 0.85 0.66 0.34 1.0
u4 0.82 0.67 0.33 1.0
PC3 PC2 PC1
SS loadings 2.64 2.61 2.53
Proportion Var 0.22 0.22 0.21
Cumulative Var 0.22 0.44 0.65
Proportion Explained 0.34 0.34 0.33
Cumulative Proportion 0.34 0.67 1.00
With component correlations of
     PC3  PC2  PC1
PC3 1.00 0.18 0.37
PC2 0.18 1.00 0.35
PC1 0.37 0.35 1.00
Mean item complexity = 1
Test of the hypothesis that 3 components are sufficient.
The root mean square of the residuals (RMSR) is 0.05
with the empirical chi square 54.41 with prob < 0.011
Fit based upon off diagonal values = 0.98# Component-correlatiematrix.
cat("\nComponentcorrelaties:\n")
Componentcorrelaties:round(pca_obl$Phi, 2) PC3 PC2 PC1
PC3 1.00 0.18 0.37
PC2 0.18 1.00 0.35
PC1 0.37 0.35 1.004.2.e Opnieuw draaien met een ander aantal componenten
Een PCA doe je nooit maar één keer.
Je doet hem een paar keer — één keer met twee componenten, één keer met drie, misschien zelfs met vier — en dan kijk je welke oplossing je het beste uitgelegd krijgt. Dat klinkt als vals spelen: net zolang doorzoeken tot er iets moois uitkomt. Het is precies andersom. De criteria uit 4.1.d hebben je een startpunt gegeven, en nu ga je kijken of dat startpunt ook een tabel oplevert die je kúnt lezen.
Drie componenten waren het. Dus draaien we er nu twee, en daarna vier.
Twee componenten
pca_2 <- psych::principal(bos_dieren_dimensies[, items],
                          nfactors = 2,
                          rotate   = "varimax",
                          use      = "complete")
print(pca_2, cut = 0.30, digits = 2)
Principal Components Analysis
Call: psych::principal(r = bos_dieren_dimensies[, items], nfactors = 2,
rotate = "varimax", use = "complete")
Standardized loadings (pattern matrix) based upon correlation matrix
RC1 RC2 h2 u2 com
p1 0.76 0.58 0.42 1.0
p2 0.79 0.62 0.38 1.0
p3 0.72 0.51 0.49 1.0
p4 0.75 0.58 0.42 1.0
a1 0.44 0.48 0.42 0.58 2.0
a2 0.51 0.36 0.39 0.61 1.8
a3 0.50 0.50 0.49 0.51 2.0
a4 0.41 0.52 0.44 0.56 1.9
u1 0.77 0.60 0.40 1.0
u2 0.80 0.65 0.35 1.0
u3 0.73 0.53 0.47 1.0
u4 0.76 0.58 0.42 1.0
RC1 RC2
SS loadings 3.23 3.17
Proportion Var 0.27 0.26
Cumulative Var 0.27 0.53
Proportion Explained 0.50 0.50
Cumulative Proportion 0.50 1.00
Mean item complexity = 1.3
Test of the hypothesis that 2 components are sufficient.
The root mean square of the residuals (RMSR) is 0.07
with the empirical chi square 123.95 with prob < 0.00000000089
Fit based upon off diagonal values = 0.96Vier componenten
pca_4 <- psych::principal(bos_dieren_dimensies[, items],
                          nfactors = 4,
                          rotate   = "varimax",
                          use      = "complete")
print(pca_4, cut = 0.30, digits = 2)
Principal Components Analysis
Call: psych::principal(r = bos_dieren_dimensies[, items], nfactors = 4,
rotate = "varimax", use = "complete")
Standardized loadings (pattern matrix) based upon correlation matrix
RC2 RC1 RC3 RC4 h2 u2 com
p1 0.69 0.59 0.83 0.17 2.0
p2 0.79 0.67 0.33 1.2
p3 0.80 0.69 0.31 1.2
p4 0.78 0.66 0.34 1.2
a1 0.77 0.65 0.35 1.2
a2 0.81 0.69 0.31 1.1
a3 0.64 0.59 0.81 0.19 2.3
a4 0.75 0.65 0.35 1.3
u1 0.75 0.62 0.38 1.2
u2 0.80 0.74 0.26 1.3
u3 0.81 0.68 0.32 1.0
u4 0.80 0.67 0.33 1.1
RC2 RC1 RC3 RC4
SS loadings 2.65 2.49 2.39 0.82
Proportion Var 0.22 0.21 0.20 0.07
Cumulative Var 0.22 0.43 0.63 0.70
Proportion Explained 0.32 0.30 0.29 0.10
Cumulative Proportion 0.32 0.62 0.90 1.00
Mean item complexity = 1.3
Test of the hypothesis that 4 components are sufficient.
The root mean square of the residuals (RMSR) is 0.05
with the empirical chi square 54.99 with prob < 0.00031
Fit based upon off diagonal values = 0.98En de winnaar is drie
| Dezelfde twaalf items, opgelost met twee, drie en vier componenten | |||
| twee | drie | vier | |
|---|---|---|---|
| items met een kruislading boven .30 | 4 | 0 | 2 |
| laagste primaire lading | .48 | .73 | .64 |
| verklaarde variantie | 53.3% | 64.8% | 69.7% |
| Note. De kolommen twee, drie en vier zijn het aantal componenten dat aan het model is opgelegd. Primaire lading = de grootste absolute lading van een item; kruislading = de op een na grootste. Alle drie de oplossingen zijn varimax-geroteerd op dezelfde 199 dieren. | |||
Kijk naar de onderste rij, want daar zit een valstrik. Vier componenten verklaren méér variantie dan drie, en drie meer dan twee. Dat is geen toeval en het is ook geen argument: élke component die je erbij haalt verklaart iets. Neem er en je zit op 100% — en dan heb je niets teruggebracht. Verklaarde variantie kiest dus altijd voor méér. Toch telt hij mee: je wilt genoeg verklaarde variantie met zo weinig mogelijk componenten, en de elleboog is precies de plek waar hij ineens minder hard groeit. Hoeveel genoeg is, daarover verschillen de meningen. Maar in zijn eentje kan hij nooit beslissen waar je stopt.
De bovenste twee rijen zeggen wél iets. Bij twee componenten hangen er 4 items tussen twee stoelen in; bij vier zijn het er 2, en dat zijn precies de twee waar die vierde component op rust. Bij drie is er geen enkele.
Maar het doorslaggevende argument staat in geen van de drie rijen, want het is geen getal. Bij twee componenten kreeg alertheid geen eigen naam. Bij vier kwam er een component bij waar geen woord voor bestaat. Bij drie kun je alle drie benoemen — piekeren, alertheid, uitstelgedrag — en dát is waarom het er drie zijn.
Dat is wat er bij de scree plot al stond. Nu heb je het gedaan.
4.2.f De neus van de heks
Er woont een heks in dit bos. Niet aardig, niet gemeen, vooral druk — en tot in haar botten overtuigd dat zij de mooiste neus van het bos heeft.
De kraai gelooft er niets van. “Van voren,” zegt hij, “heb je bijna geen neus.”
“Van vóren,” zegt de heks, en ze draait haar hoofd.
Ze heeft gelijk, en het is precies wat er met een ladingenplot aan de hand is. Je hebt net besloten dat er drie componenten zijn. Maar een bladzijde is plat, dus je tekent er twee. En wat je dan ziet, is de wolk van voren.
Toon code (twee aanzichten op dezelfde twaalf items)
# Twee aanzichten op één wolk. Net als bij de drie figuren hierboven moeten de
# twee vlakken op precies één ding verschillen -- welke component er verticaal
# staat -- dus het zijn twee facetten van één plot en niet twee plots naast
# elkaar. Dezelfde schaal, dezelfde cirkel, geen stijlverschil dat op een
# verschil in de data kan lijken.
#
# Welke kolommen dat zijn wordt niet ingetikt: neus_as en neus_vlak komen uit
# de setup en worden daar uitgezocht.
aanzicht <- function(kolommen) {
  d <- as.data.frame(L_var[, kolommen, drop = FALSE])
  names(d) <- c("x", "y")
  d$item   <- rownames(L_var)
  d$blok   <- unname(blok_naam[substr(d$item, 1, 1)])
  d$vlak   <- paste0(colnames(L_var)[kolommen[1]], " horizontaal, ",
                     colnames(L_var)[kolommen[2]], " verticaal")
  d
}
tweeluik <- rbind(aanzicht(neus_vlak), aanzicht(c(neus_vlak[1], neus_as)))
tweeluik$vlak <- factor(tweeluik$vlak, levels = unique(tweeluik$vlak))

# Alle twaalf pijlen beginnen in de oorsprong, en de vier stompjes eindigen daar
# vlakbij. ggrepel kent alleen de punten die hij labelt, niet dat drukke
# kruispunt, en legde een naam dus pal op de nullijn. Geef hem de oorsprong er
# als naamloos punt bij, dan houdt hij die plek vrij.
#
# En waarom de namen hier NIET netjes op een ring rond de cirkel staan, wat bij
# zo'n plaatje gebruikelijk is: dan krijgt elk stompje een lang dun aanwijslijntje
# in het verlengde van zijn eigen pijl, en op een figuur die moet laten zien dat
# die pijl kórt is leest zo'n lijntje als de rest van de pijl. Met een hoge
# afstootkracht wijken de namen naar de lege onderkant uit, en daar wijst het
# lijntje van de pijl wég in plaats van hem te verlengen.
oorsprong <- do.call(rbind, lapply(levels(tweeluik$vlak), function(v) {
  data.frame(x = 0, y = 0, item = "", blok = "piekeren",
             vlak = factor(v, levels(tweeluik$vlak)))
}))
tweeluik_labels <- rbind(tweeluik, oorsprong)

# De naam van een STOMPJE gaat naar de lege onderkant, niet naar buiten langs
# zijn eigen pijl. Reden: testlezer Beeldverteller vond op 21-9-2026 drie
# gevallen waarin het aanwijslijntje vrijwel in het verlengde van de korte pijl
# lag -- `p4` rechts wees 56° omhoog en zijn lijntje 38°, dus het lás als de
# rest van de pijl. Op een figuur die juist moet laten zien dat die pijl kórt
# is, is dat de ene fout die je niet mag maken.
#
# De wolk ligt hier altijd rechtsboven (varimax op positief samenhangende
# items), dus "omlaag" is altijd weg van elke pijl. De lange pijlen houden hun
# naam gewoon bij de punt.
kort <- sqrt(tweeluik_labels$x^2 + tweeluik_labels$y^2) < 0.45
tweeluik_labels$ny <- ifelse(kort, -0.55 - tweeluik_labels$y, 0)
tweeluik_labels$nx <- ifelse(kort, 0, 0)

ggplot(tweeluik, aes(x, y)) +
  annotate("path", x = cos(seq(0, 2 * pi, length.out = 200)),
           y = sin(seq(0, 2 * pi, length.out = 200)), colour = "grey85") +
  geom_hline(yintercept = 0, colour = "grey55") +
  geom_vline(xintercept = 0, colour = "grey55") +
  geom_segment(aes(x = 0, y = 0, xend = x, yend = y, colour = blok),
               arrow = arrow(length = unit(0.15, "cm")), linewidth = 0.7) +
  ggrepel::geom_text_repel(data = tweeluik_labels,
                           aes(label = item, colour = blok), size = 3,
                           show.legend = FALSE, seed = 11, box.padding = 0.5,
                           point.padding = 0.3, force = 6, force_pull = 1,
                           nudge_x = tweeluik_labels$nx,
                           nudge_y = tweeluik_labels$ny,
                           max.iter = 20000,
                           min.segment.length = 0, max.overlaps = Inf,
                           segment.size = 0.3, segment.alpha = 0.6) +
  scale_colour_manual(values = c(piekeren = "#1b6ca8", alertheid = "#1a7f37",
                                 uitstelgedrag = "#9a6700"), name = NULL) +
  scale_x_continuous(breaks = seq(-1, 1, 0.5), labels = apa) +
  scale_y_continuous(breaks = seq(-1, 1, 0.5), labels = apa) +
  coord_fixed(xlim = c(-1.15, 1.15), ylim = c(-1.15, 1.15)) +
  facet_wrap(~ vlak) +
  labs(x = NULL, y = NULL,
       title = "Dezelfde twaalf items, twee aanzichten",
       subtitle = paste0(
         "Links kijk je recht op de wolk en lijken de ",
         telwoord(length(a_items)), " ",
         neus_linkerblok, "-items stompjes.\nRechts draai je een kwartslag: ",
         "dan zijn ze even lang als de rest, en zijn de\n", neus_rechterblok,
         "-items de stompjes geworden.")) +
  theme_minimal(base_size = 11) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        panel.spacing = unit(1.2, "lines"))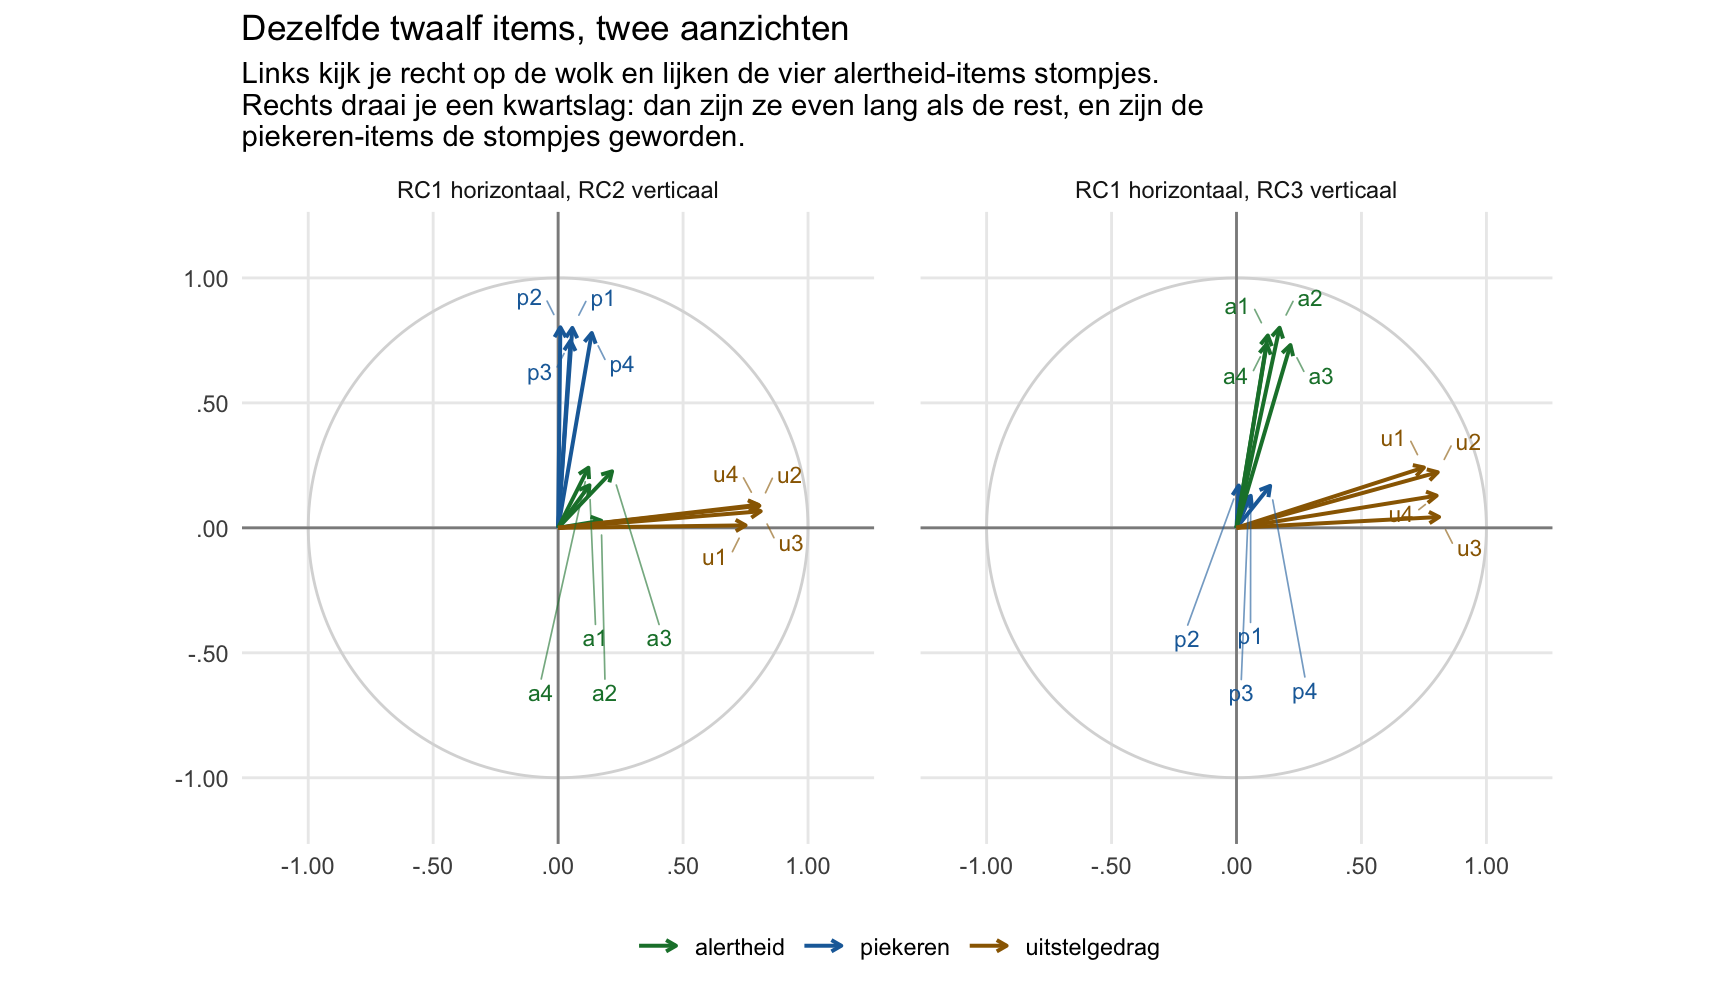
Waarom die neus zo lang is: de wortel van h²
Bij de ladingenplot stond het al: de lengte van een pijl is de wortel van zijn communaliteit. Die uitspraak geldt in de volle ruimte — hier dus met alle drie de componenten erin.
Teken je er maar twee, dan zie je die lengte niet. Je ziet zijn schaduw op het vlak dat je toevallig getekend hebt. Schrijf de drie ladingen van een item als , en , dan is het verschil één term:
Neem a2, de kortste van de vier — in het linkerplaatje is dat het groene stompje dat plat langs de horizontale as ligt. Doe de som in stapjes, dan zie je meteen waar zijn lengte gebleven is:
| wat je in het vlak ziet | |
| dat in het kwadraat | |
| zijn lading op RC3, in het kwadraat | |
| samen: | |
| en de wortel daarvan: zijn echte lengte |
Kijk naar de derde regel. Die ene lading draagt 95.5% van zijn hele communaliteit — de neus ís het item zo ongeveer. En die as steekt loodrecht de bladzijde uit, dus hij wijst recht naar je toe.
Examen-stijl vragen
R-practical opdrachtje
De kraai en haar perceptie
E8 — Tellen vóór je rekent, en twee tekeningen
OpgeletAntwoord — open na je eigen poging
a) 78. De matrix is 13 bij 13, dus 169 cellen. Haal de 13 van de diagonaal eraf en je houdt er 156 over. Elke correlatie staat er twee keer in — boven en onder de diagonaal — dus deel door twee: .
b) 13. Eén per item, en dat is precies de diagonaal.
c) . Oftewel : de hele onderste driehoek van de matrix, de diagonaal meegerekend.
Onthoud dat laatste getal, want volgende week heeft het een naam. In thema 5 heet het , en dan is het je voorraad: alle informatie die je hebt om een model uit te schatten. Elke pijl die je tekent kost er één van. Wat overblijft zijn je vrijheidsgraden. In thema 5 staat dezelfde formule als : daar heet het aantal items , omdat er iets anders gaat betekenen.
(Dat is een andere dan die uit de eigenvalue-decompositie helemaal aan het begin van dit hoofdstuk. Die was een matrix vol eigenvectoren; deze is gewoon een aantal. Ook hier geldt weer: kijk wat er bij staat.)
d) Leg je eigen blaadje ernaast.
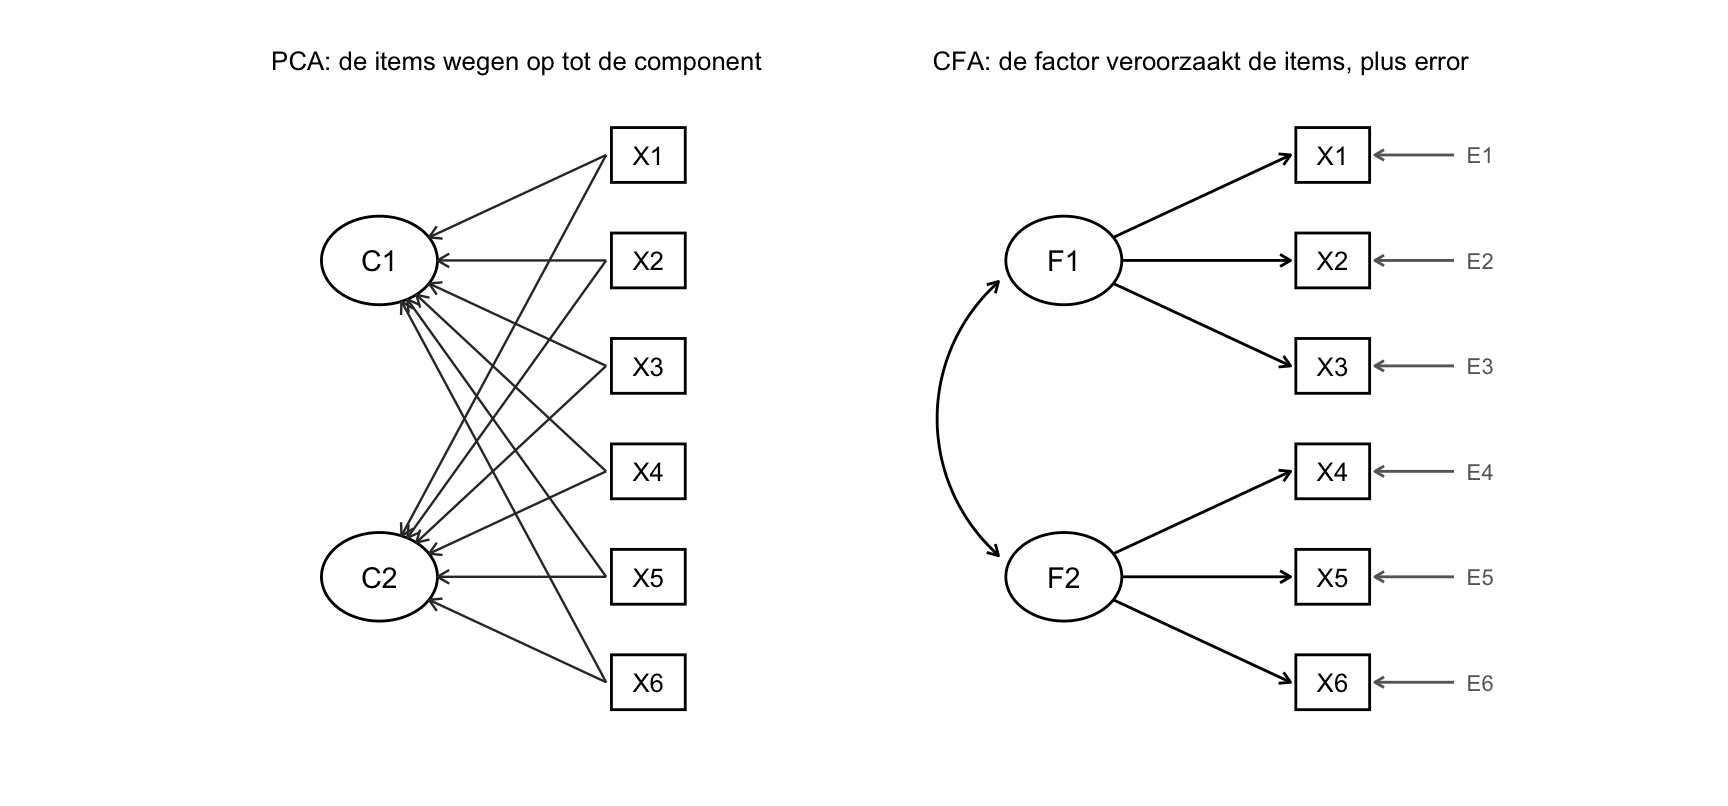
Hierboven staan dezelfde 6 items twee keer getekend: links als PCA, rechts als CFA. Eerst wat in allebei hetzelfde is. Een vierkantje is iets dat je gemeten hebt, een ovaal iets dat je er niet rechtstreeks aan af kunt lezen. Tekende jij alles als vierkantjes, dan mist je plaatje dat onderscheid.
Twee verschillen, en de rest volgt daaruit.
- PCA (links). 6 vierkantjes, 2 ovalen die hier en heten — componenten — en de pijlen wijzen van de items naar de componenten. Elk item heeft een pijl naar élke component, dus 12 pijlen, en die kruisen elkaar in het midden. Verder staat er niets: geen errorpijlen, want een component ís de gewogen som van de items, en er blijft niets over dat je apart zou modelleren.
- CFA (rechts). Dezelfde 6 vierkantjes en 2 ovalen, maar die heten nu en — factoren, want het is een ander soort ding — en de pijlen wijzen de andere kant op: van de factor naar het item. Elk item krijgt er van opzij een grijs pijltje bij, zijn error: tot en met , grijs en zonder hokje omdat je hem niet gemeten hebt. Je tekent bovendien niet alle 12 pijlen maar alleen die waarvan jij denkt dat ze er zijn — hier 3 items per factor. Wat je niet tekent, staat op nul.
Die ’tjes ken je al onder een andere naam. Het is de u2 uit de uitvoer van 4.2.a, het stuk van een item dat de oplossing niet terugverklaart. In thema 4 is dat een restje dat overblijft; in thema 5 krijgt het een eigen pijl en hoort het bij het model.
En de samenhang tussen de twee dimensies? Rechts zie je hem staan: de gebogen dubbele pijl tussen en , die je zelf trekt of weglaat. Links staat hij niet, en dat hoort zo — bij PCA heb je die vraag al beantwoord met je keuze van rotatie: varimax zegt nee, oblimin zegt ja.
R-spiekblad — PCA van begin tot eind
Dezelfde route als bij Wat je doet als je een vragenlijst valideert, nu in code.
# 1. Pakketten en data laden ------------------------------------------
library(tidyverse)
library(psych)
load("data/bos_dieren_dimensies.RData")

items <- c("p1","p2","p3","p4","a1","a2","a3","a4","u1","u2","u3","u4")

# 2. Kijk eerst naar de correlaties -----------------------------------
cor_mat <- cor(bos_dieren_dimensies[, items], use = "complete.obs")
round(cor_mat, 2)

# 3. Toets de voorwaarden ---------------------------------------------
psych::KMO(cor_mat)                         # onder .70? melden, en verder kijken
n_compleet <- sum(complete.cases(bos_dieren_dimensies[, items]))
psych::cortest.bartlett(cor_mat, n = n_compleet)   # n waar cor_mat op rust

# 4. Hoeveel componenten? ---------------------------------------------
eigen(cor_mat)$values                       # Kaiser: hoeveel boven 1?
psych::fa.parallel(bos_dieren_dimensies[, items],
                   fa = "pc", n.iter = 50)  # knik (elleboog) + parallel analysis (extra)
# En dan het derde criterium: welke oplossing kun je interpreteren? Zie 7.

# 5. Ongeroteerd, om te zien wat rotatie straks oplost -------------------
psych::principal(bos_dieren_dimensies[, items],
                 nfactors = 3, rotate = "none")

# 6. Varimax (assen blijven haaks) en oblimin (assen mogen scheef) -----
pca_var <- psych::principal(bos_dieren_dimensies[, items],
                            nfactors = 3, rotate = "varimax")
print(pca_var, cut = 0.30, digits = 2)

pca_obl <- psych::principal(bos_dieren_dimensies[, items],
                            nfactors = 3, rotate = "oblimin")
pca_obl$Phi                                 # componentcorrelaties

# 7. Opnieuw, met een ander aantal componenten ------------------------
# Eén minder en één meer, en dan kijken welke je het best uitgelegd krijgt.
for (k in c(2, 3, 4)) {                     # k: het aantal componenten
  cat("\n---", k, "componenten ---\n")
  print(psych::principal(bos_dieren_dimensies[, items],
                         nfactors = k, rotate = "varimax"),
        cut = 0.30, digits = 2)
}

# 8. Zelf narekenen ---------------------------------------------------
L <- unclass(pca_var$loadings)[, 1:3]
rowSums(L^2)     # communaliteiten -- over de RIJ
colSums(L^2)     # eigenwaarden    -- over de KOLOM
colSums(L^2) / length(items)   # VAF per component
Wat blijft liggen
- Exploratory Factor Analysis (EFA) —
psych::fa(). Modelleert latente factoren mét meetfout. - Confirmatory Factor Analysis (CFA) —
lavaan::cfa(). Toetst een vooraf gespecificeerde structuur. Thema 5. - Componentscores in R — wat ze zijn, las je bij Wat R hier van maakt. Uitrekenen gaat via
pca_var$scores: per dier een score op elke component, klaar voor een latere regressie. - Biplot — items en personen in één figuur, via
psych::biplot.psych(). De ladingenplot in 4.2.c toont alleen de items. - Robuuste PCA bij uitbijters, sparse PCA bij heel veel items.
Voor verdieping: Tabachnick en Fidell (2019), hoofdstuk 13 en 14; Costello en Osborne (2005); Fabrigar en Wegener (2012).
Aan het eind van de dag
De rat zat tegenover zijn ladingenplot en was bijna tevreden.
“Drie richtingen,” zei hij. “Twaalf items, drie groepjes. Roteren maakt ze leesbaar en verandert niets aan hoe goed ze een item vangen.”
“En je gewichtjes?” vroeg de bunzing.
“Die heb ik niet gekozen. Die zijn gezocht.” De rat keek naar zijn pijlen. “Dat is het verschil met die chippendales aan het begin. Daar koos iemand wat belangrijk was. Hier heeft de machine de richtingen gevonden en moet ik zeggen wat ze betékenen.”
“En als je dat niet kan?”
“Dan klopt er iets niet aan mijn vragenlijst. Of aan mijn aantal componenten. Dan draai ik hem opnieuw met twee, en met vier, en kijk ik welke ik uitgelegd krijg.”
“En morgen?”
“CFA,” zei de rat. “De das gaat het toetsen. Niet ontdekken zoals ik nu deed — bevestigen. Hij heeft een model en kijkt of de data erop past.” Hij keek naar de plek waar de das altijd zat. “Hij graaft fundamenten. Mijn werk is verkennen, dat van hem is bevestigen.”
De bunzing knikte en kroop weg. Boven het bos werd het donker, en de rat liet zijn pijlen op de plot staan.
Verantwoording
Dit oefenboek is geschreven voor studenten die psychometrie leren via R. Het is materiaal van CountCamp, geen officieel onderdeel van een opleiding. De voorbeelden, datasets, vragen en formuleringen zijn origineel; de didactische volgorde is dat bewust niet — die volgt de gangbare opbouw van universitaire psychometrie-cursussen. Verwijzingen naar Tabachnick en Fidell (2019), Costello en Osborne (2005) en Fabrigar en Wegener (2012) volgen de gebruikelijke citaatpraktijk in dit veld.
Waar dit thema een eigen weg gaat. Eigen keuze is de data: de bosdieren zijn van ons, met opzet, zodat alles wat hier staat op je eigen scherm na te draaien is. Eigen keuze is ook waar dit hoofdstuk begint — bij een gewogen som en bij je tentamencijfer, en pas bladzijden later bij het woord dimensie. De twee voorbeelden bij het Kaiser-criterium en bij de knik in de scree-plot zijn psych::bfi en Harman74.cor, allebei datasets die met R meekomen, want een vuistregel geloof je pas als je hem zelf hebt zien omvallen. En KMO en Bartlett staan hier op stap 2 van de route en niet als twee horden vooraf: ze horen bij de stof en je moet ze kennen, maar ze zeggen alleen of er iets te vinden valt, niet of wat je vindt iets betekent.
Zegt ander materiaal dat je gebruikt iets anders dan dit oefenboek, reken dan met wat daar staat. Meestal is het verschil een afspraak — een drempel, een letter, de naam van een model — en geen rekenfout.
Versie: oktober 2026 — CountCamp Lab