5. Confirmatory Factor Analysis (CFA) — eerst tekenen, dan pas kijken
Het verhaal van dit thema
De das stak zijn kop boven het zand uit en keek naar de rat, die nog steeds op zijn schommeltak zat.
“Jij hebt vorige week gezocht,” zei de das. “Twaalf items, en je liet de machine uitzoeken hoeveel richtingen erin zaten.”
“Drie,” zei de rat. “Piekeren, alertheid, uitstelgedrag. Netjes.”
“Dat ga ik niet zoeken. Dat weet ik al.” De das klom eruit en veegde het zand van zijn poten. “Ik teken het eerst. Drie factoren, elk vier items. En dán pas kijk ik naar de data — en dan vraag ik: klopt dit?”
“En als het niet klopt?”
“Dan klopt het niet.” De das gromde. “Maar ik ga niet net zo lang pijlen bijtekenen tot het wél klopt. Dat is bouwen op drijfzand.”
De bunzing, die dit alles had aangehoord, stak zijn snuit omhoog. “En als het bíjna klopt?”
De das dacht na. “Dan kijk ik wáár het wringt. Daar heb ik de residuen voor.” Hij snoof. “Kijken waar het wringt is iets anders dan het dichtsmeren.”
Dit thema gaat over die weddenschap: eerst tekenen, dan pas kijken. Dezelfde 200 bosdieren als vorige week, dezelfde twaalf items op een -puntsschaal. De rat liet de data de pijlen tekenen. De das tekent ze zelf, en de data mogen alleen nog zeggen of hij gelijk had.
Drie hoofdvragen:
- Past het model dat de das tekende bij de data? Een toets () en drie fit-maten: RMSEA, NFI en CFI.
- Hoe sterk hangen de items aan hun factor? Gestandaardiseerde ladingen, en de toets of zo’n pijl van nul verschilt.
- Waar wringt het, en wat doe je daarmee? Residuen lezen, en weten wanneer je er niet achteraan mag.
Voordat we beginnen — wat je al hebt
Drie dingen die je al kunt, en één pijl die omdraait
Even terug, want “eigenlijk voelt het gewoon een beetje hetzelfde. Het moet een beetje hetzelfde voelen.”
Regressie. Als ik regressiemodel zeg, dan denk jij: zo’n lijntje. Puntenwolk, lijntje erdoorheen. Dat lijntje leg je zo netjes mogelijk óp de data, en dan vraag je: past het? Vandaag doen we niets anders. “We bouwen een model, leggen hem op de data en we kijken of het past.” Alleen is het model vandaag geen lijntje maar een tekening met pijlen.
Thema 4. Vorige week had je twaalf items en keek je of er groepjes in zaten die lekker samen correleerden. Dat zag je aan de ladingen: items die hoog op één component laadden, hoorden bij elkaar. Teken je dat, dan wijzen de pijltjes van de items naar de component. Je hoefde van tevoren niets te weten. Dat was exploratief: ontdekken.
Thema 1. Een somscore was een optelling van items. Een component in thema 4 was een gewogen optelling. Allebei: items erin, één getal eruit.
En nu draait de pijl om.
De vijf stappen — je route, voor je vertrekt
Waar dit hoofdstuk je langs brengt
“Dus dat is wel de hoofdprocedure. […] Dat is in principe gewoon het hele proces, dus maak het ook niet te heftig.”
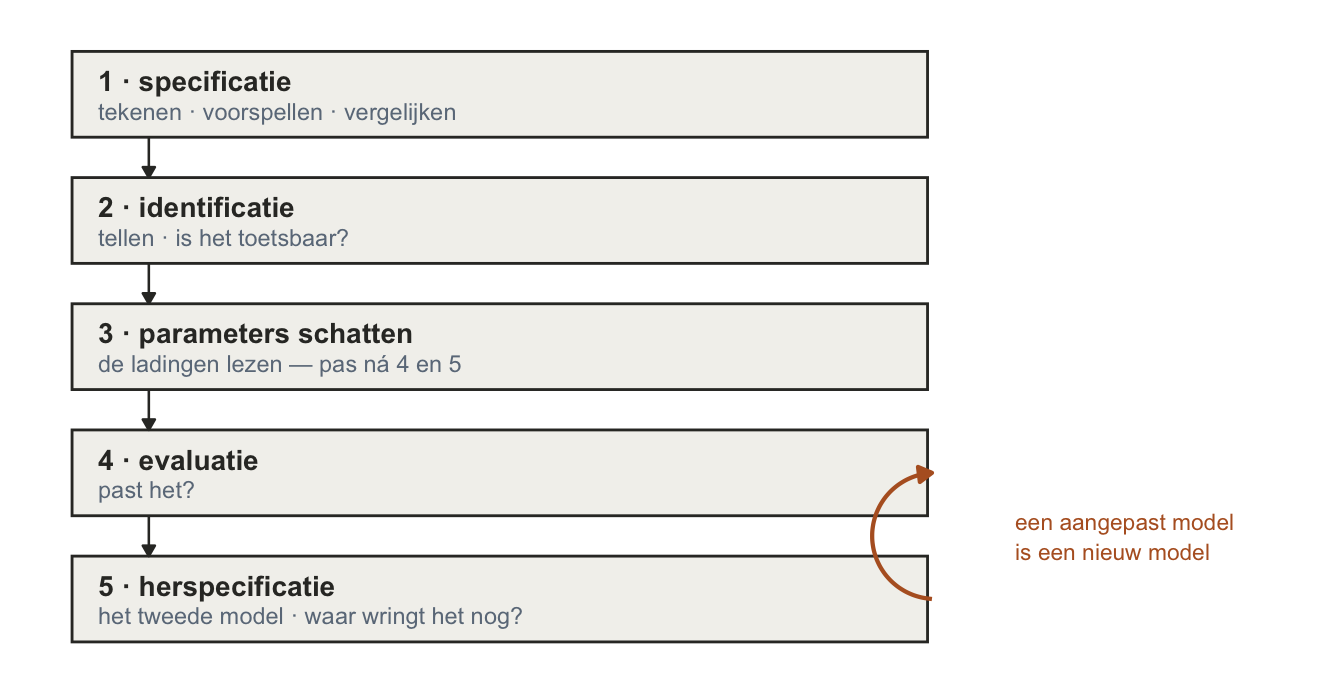
Een CFA loopt langs vijf stappen, en die vijf moet je kennen. Hier staan ze, voordat je er eentje doet:
Dit hoofdstuk loopt die vijf langs, maar niet netjes van boven naar beneden. Onder elke kop hierna staat een grijze regel die zegt welke stap je op dat moment doet, en die regel loopt niet op. Stap 5 kom je al vroeg tegen, ruim vóór stap 4: het residu — wat je waarneemt min wat je model beloofde — is het gereedschap van de herspecificatie, en je moet weten wat dat gereedschap ís voordat de fitmaten je iets kunnen zeggen. Daarna komt stap 2, en na stap 2 meteen stap 4. Van 4 gaat het terug naar 5, dan naar 3, en aan het eind nog één keer naar 5. Stap 3 is dus niet overgeslagen — hij komt laat.
Dat is geen slordigheid. R rekent eerst stap 3 en dan stap 4: het schatten gebeurt in dezelfde regel als de fit, dus je hebt stap 3 al gedaan zonder het te merken. Jij leest eerst stap 4 en dan pas stap 3 — want past het model niet, dan hoef je de pijlen niet meer te bekijken.
Het is dus geen lijstje maar een rondje — al gaat dat rondje niet terug naar het begin. De oranje pijl rechts zegt waar hij wél heen gaat: pas je je model aan, dan is het een nieuw model, en dat moet opnieuw langs de evaluatie, stap 4.
Wat je bij elke stap precies dóét, staat aan het eind van dit hoofdstuk nog een keer op een rij. Dan heb je ze alle vijf gedaan, en zegt die tabel je ook echt iets.
Eerst tekenen: het model van de das
stap 1 · specificatie
Vierkantjes, rondjes, pijlen
Pak een blaadje. Teken twaalf vierkantjes onder elkaar: p1 tot en met p4, a1 tot en met a4, u1 tot en met u4. Zet er drie ovalen naast — piekeren, alertheid, uitstelgedrag — en trek pijlen. Van welke ovaal naar welke vierkantjes? Doe het eerst zelf; hieronder staat hoe de das het deed.
Waarom vierkantjes en ovalen? Items zijn dingen die zich laten zien. Hoe vaak pieker jij? Tien keer per dag — dat is gedrag, dat kun je meten. Dat heet manifest. Wat daar misschien aan ten grondslag ligt — een sombere bui, een neiging tot uitstellen — kun je niet zien. Dat heet latent. Een vierkantje is manifest, een ovaal is latent, en de pijl gaat van de ovaal naar het vierkantje: er bestaat zoiets als piekeren in dit dier, en dat veroorzaakt zijn antwoord op p1.
En dan de errorpijlen. Als ik precies zou weten hoeveel dit dier piekert, zou ik dan precies kunnen voorspellen wat het op p1 invult? Vast niet. Er zit ruis in. Dus elk item krijgt nog een pijltje van opzij: , de error van item 1. Die error is óók latent — je ziet hem net zomin als het piekeren zelf — maar hij krijgt gewoonlijk géén rondje. Teken hem als een zónder ovaal eromheen, met één rechte pijl het vierkantje in. Het nummer loopt met het item mee: p1 is item 1 en krijgt , u4 is item 12 en krijgt . (In sommige boeken staat er wél een ellips omheen. Zelfde ding, andere tekenwijze.)
Toon code (semPaths)
# fixedStyle: alles wat in het model vást staat (de factorvarianties op 1, de
# drie samenhangen op 0) wordt niet getekend -- lijntype 0 is onzichtbaar.
# Anders tekent semPaths gestippelde dubbele pijlen tussen de factoren, en
# dat is precies wat de das níét getekend heeft.
#
# style = "lisrel" sinds 30-9-2026, en dat is de hele reden dat deze figuur nu
# bij de tekst klopt. Standaard ("ram") tekent semPaths de error als een
# DUBBELE ZELFLUS aan het vierkantje; de tekst hierboven tekent hem als een
# kale E met EEN ENKELE RECHTE PIJL het vierkantje in (errors zijn ook latent,
# maar krijgen gewoonlijk geen ellips). "lisrel" geeft precies die vorm --
# enkele pijl, geen bronknoop. Wat er dan nog mist is de letter E zelf, en dat
# zegt het bijschrift.
#
# LET OP voor wie dit terugdraait: de vorige versie beweerde in het bijschrift
# dat semPaths die vorm niet KON tekenen. Dat was fout, en het kwam
# doordat er in de argumentenlijst gezocht was op "resid|error|exo|node" --
# `style` viel buiten dat net. Testlezer Beeldverteller ving het (30-9-2026).
#
# label.scale.equal sinds 30-9-2026: zonder die schakelaar krimpt semPaths
# ELK label apart tot het in zijn eigen rondje past, en dan staat
# "uitstelgedrag" (dertien letters) zichtbaar kleiner op de bladzijde dan
# "alertheid" en "piekeren". Drie factoren die even belangrijk zijn horen even
# groot te staan; nu kiest qgraph een maat die voor alle drie past.
#
# mar en fig-height sinds 30-9-2026: twaalf vierkantjes horen twaalf losse
# dingen te zijn, en ze lagen tegen elkaar aan -- een vak was precies zo hoog
# als de afstand tussen twee vakken, en de kolom las als één tabel. `mar` is de
# marge die semPaths om de tekening houdt, als onder-links-boven-rechts.
# Standaard is dat hier 5, 8, 5, 8; boven en onder naar 1 geeft de kolom de
# hoogte die anders wit bleef. Kleinere vakjes waren de andere weg, maar dan
# krimpen ALLE letters mee, ook de factornamen: `label.scale.equal` geeft elk
# label de kleinste maat die overal past.
q_model_1 <- semPaths(fit_1,
         what             = "path",
         layout           = "tree",
         rotation         = 2,
         sizeMan          = 5,
         sizeLat          = 12,
         nCharNodes       = 0,
         freeStyle        = c("black", 1),
         fixedStyle       = c("white", 0),
         residuals        = TRUE,
         intercepts       = FALSE,
         title            = FALSE,
         style            = "lisrel",
         label.scale.equal = TRUE,
         mar              = c(1, 8, 1, 8))
errorletters(q_model_1, items)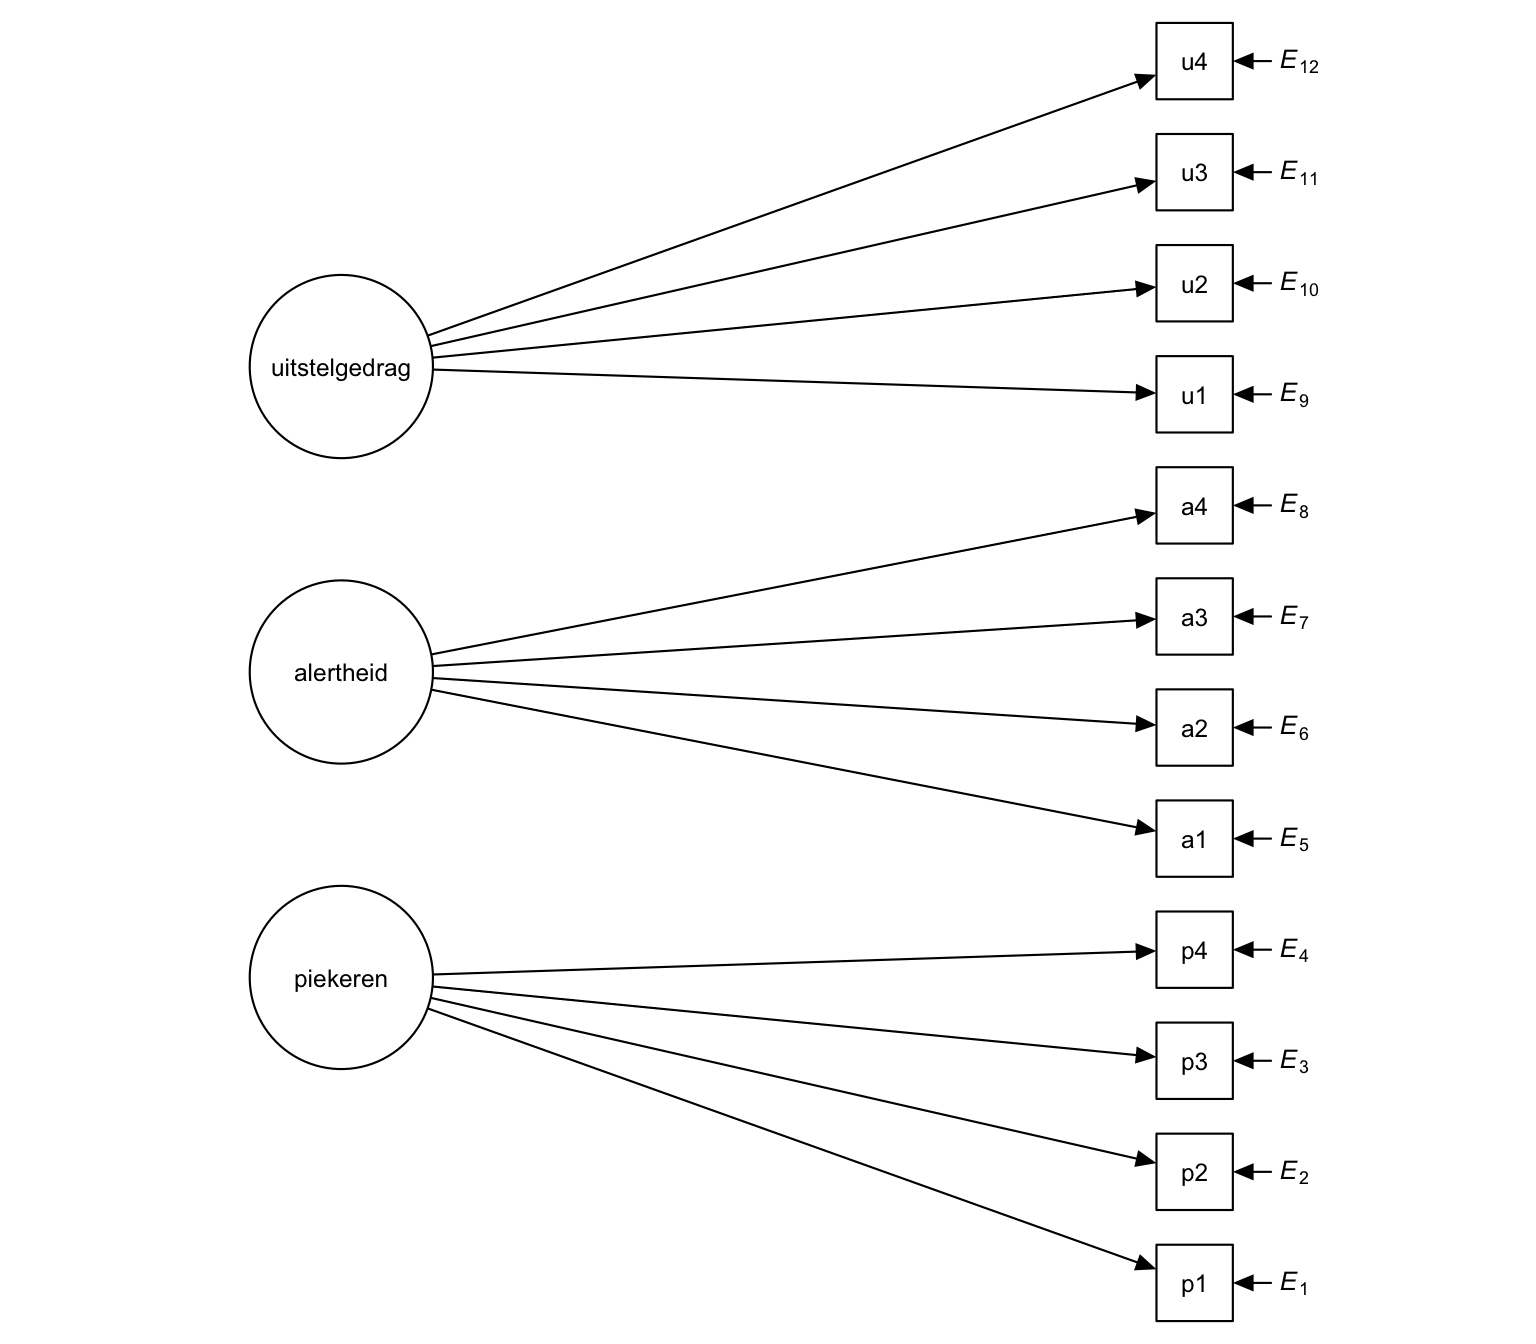
p1 onderaan. Rechts van elk vierkantje komt een korte pijl naar binnen met een ernaast: dat is zijn error. De nummers lopen met de items mee — p1 is item 1 en krijgt , u4 is item 12 en krijgt .
Kijk naar wat er niet staat. Tussen de drie ovalen loopt geen enkele pijl. De das heeft dat met opzet gedaan: “Piekeren is piekeren en uitstellen is uitstellen. Twee verschillende dingen.” Wat je niet tekent, staat op nul — een verband dat er niet is. Onthoud dat, want daar gaat de das straks op stuk.
En let op het verschil, want dat is de hele grap van een confirmatief model: een pijl weglaten is niet dat weet ik niet, het is die is nul. Daar is een woord voor: zo’n vastgezette nul is een restrictie — een parameter die jij op een vaste waarde zet, in plaats van hem door R te laten schatten. Een restrictie is geen open plek maar een bewering, en precies daarom valt er straks iets te toetsen. Een model dat overal een pijl trekt heeft geen restricties, belooft niets en kan dus ook niet ongelijk krijgen.
Nog één ding aan die tekening, en dat is het ding waar dit hele thema aan hangt. Neem p1. Welke pijlen wijzen erheen? Eén van piekeren en één van . Dus:
Het item is het gevolg van de factor, en een beetje error. Dat is een regressievergelijking — één predictor, één gewicht, en een restje. Zo’n gewicht heet hier een lading, : item op factor . “Of je dat nou b of a noemt — laten we het maar even gewoon a noemen vanaf nu.” Je ziet dezelfde lading ook als geschreven, met dezelfde volgorde: eerst het item, dan de factor. Kom je tegen, lees dan de lading van item 1 op factor 1 — zelfde pijl, andere letter. Voor elk item schrijf je zo’n regeltje op, en samen zijn die twaalf regeltjes je model. “Dus voor elk item zou je even moeten kijken wat voorspelt hem.”
Zo’n regeltje heet een structurele vergelijking — preciezer een meetvergelijking, omdat hij een item aan zijn factor koppelt — en de tekening een pijldiagram. Het zijn twee manieren om hetzelfde model op te schrijven, en ze zijn gelijkwaardig: elke pijl die een vierkantje in wijst is een stukje van zijn vergelijking, en elk stukje van de vergelijking is een pijl. Alleen de dubbele pijlen tússen de ovalen zitten niet in die twaalf regels; die schrijf je er apart onder, zoals lavaan dat ook doet met ~~.
Je ziet de vergelijking ook wel met een vóór de : , item 1 op factor 1, bij ons dus p1 op piekeren. Die is geen getal dat iemand geschat heeft — het is de afspraak dat de error zijn volle gewicht meekrijgt, zodat er op die pijl niets te schatten valt. Wat er bij een errorpijl wél geschat wordt, is hoe groot de error zelf is: zijn variantie. Daarom telt elke errorpijl straks als één parameter.
OpmerkingWat er draait sinds thema 4
Je hebt net getekend, dus je hebt het in je hand. Leg je tekening naast die van vorige week:
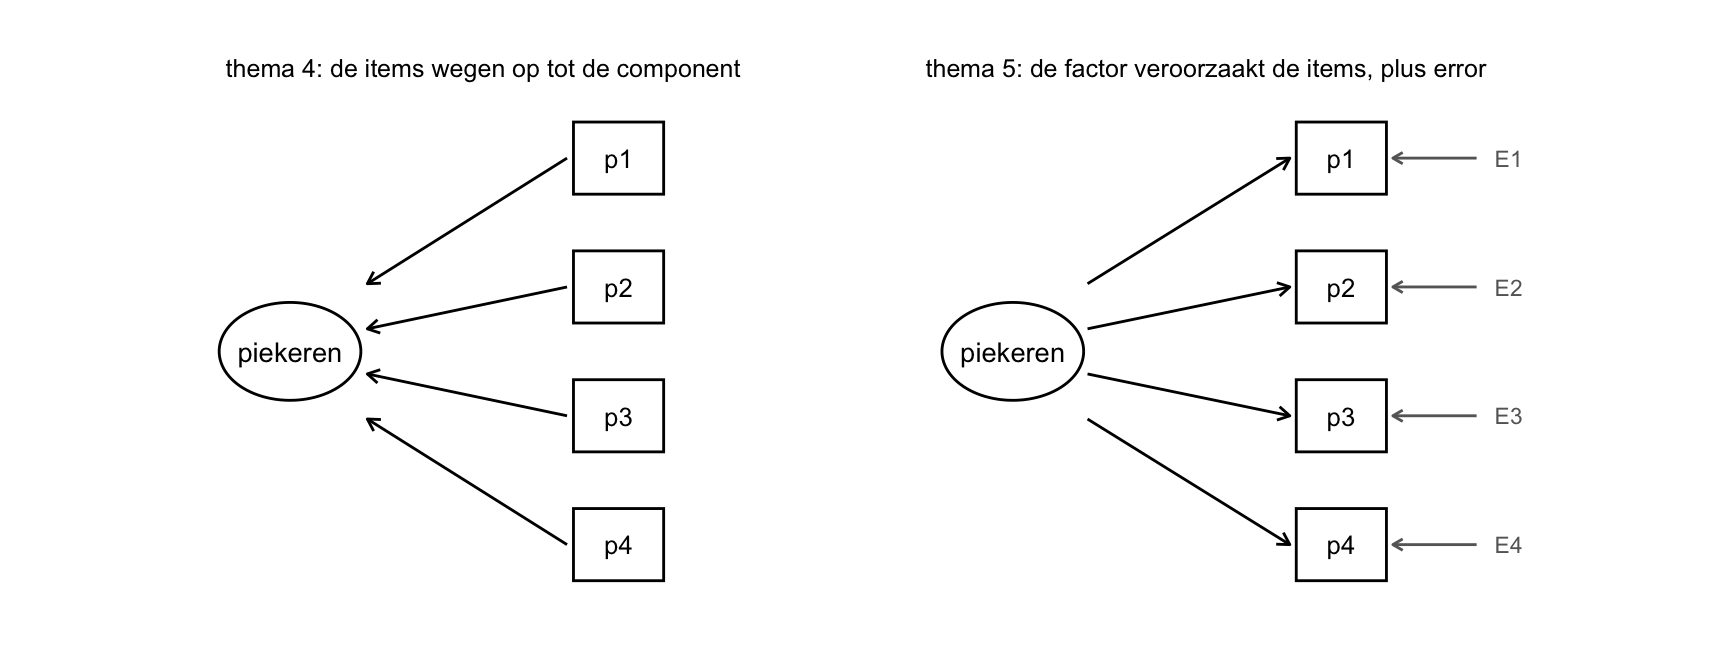
Drie dingen zie je aan die tekening, en die zijn het hele verschil:
- De pijl draait. Vorige week was een component een gewogen som van items. Nu zit de factor in het dier en veroorzaakt hij het antwoord. Een factor is vanaf nu geen optelsom meer.
- Elk item houdt een error over. Wat de factor niet verklaart, krijgt zijn eigen pijltje. Thema 4 had dat niet.
- Jij tekent de pijlen, en wat je niet tekent staat op nul. Vorige week mocht elk item overal op laden en draaide je daarna de assen tot het leesbaar werd. Dat draaien bestaat hier niet meer.
Wat hetzelfde blijft: een lading heet net als vorige week , item eerst en dan de factor, en een hoge lading betekent net als vorige week dit item hoort bij die factor. En er komt één ding bij: een toets. Verderop komt dit een paar keer kort terug, precies waar het verschil bijt.
De weddenschap: wat voorspelt dit plaatje?
stap 1 · specificatie
Plusjes en nulletjes, vóór er één getal is
Vul dit in voordat je verder leest. Stel dat het model van de das klopt, en stel dat je bij onze bosdieren de correlatiematrix van de twaalf items opvraagt. Wat verwacht je dan in de cel van p1 met p2? En in de cel van p1 met a1? Zet een + of een 0. Meer hoeft niet.
“Stel dat dit idee klopt. Stel, stel, stel, stel.” Twee piekeritems horen bij dezelfde factor, dus die moeten samenhangen — anders zou het raar zijn. Dat wordt een dikke plus. Hoe dik weet je niet: “dat mag punt 8 zijn, dat mag punt 9 zijn, maar het mag niet 0 zijn.” En p1 met a1? Volgens de das hebben piekeren en alertheid niets met elkaar te maken. Dus daar hoort een nul.
Toon code (de voorspelde matrix)
voorspeld <- expand.grid(rij = items, kol = items, stringsAsFactors = FALSE) |>
  mutate(ri = match(rij, items), ki = match(kol, items),
         teken = case_when(ri == ki ~ "1",
                           blok[rij] == blok[kol] ~ "+",
                           TRUE ~ "0")) |>
  filter(ri >= ki)

ggplot(voorspeld, aes(ki, -ri)) +
  geom_tile(aes(fill = teken), colour = "white", linewidth = 0.8) +
  geom_text(aes(label = teken, colour = teken), size = 5) +
  scale_fill_manual(values = c("+" = "#cfe3f0", "0" = "white", "1" = "grey85"),
                    guide = "none") +
  scale_colour_manual(values = c("+" = "black", "0" = "grey45", "1" = "black"),
                      guide = "none") +
  scale_x_continuous(breaks = 1:k, labels = items, position = "top", expand = c(0, 0)) +
  scale_y_continuous(breaks = -(1:k), labels = items, expand = c(0, 0)) +
  coord_fixed() +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 11) +
  theme(panel.grid = element_blank())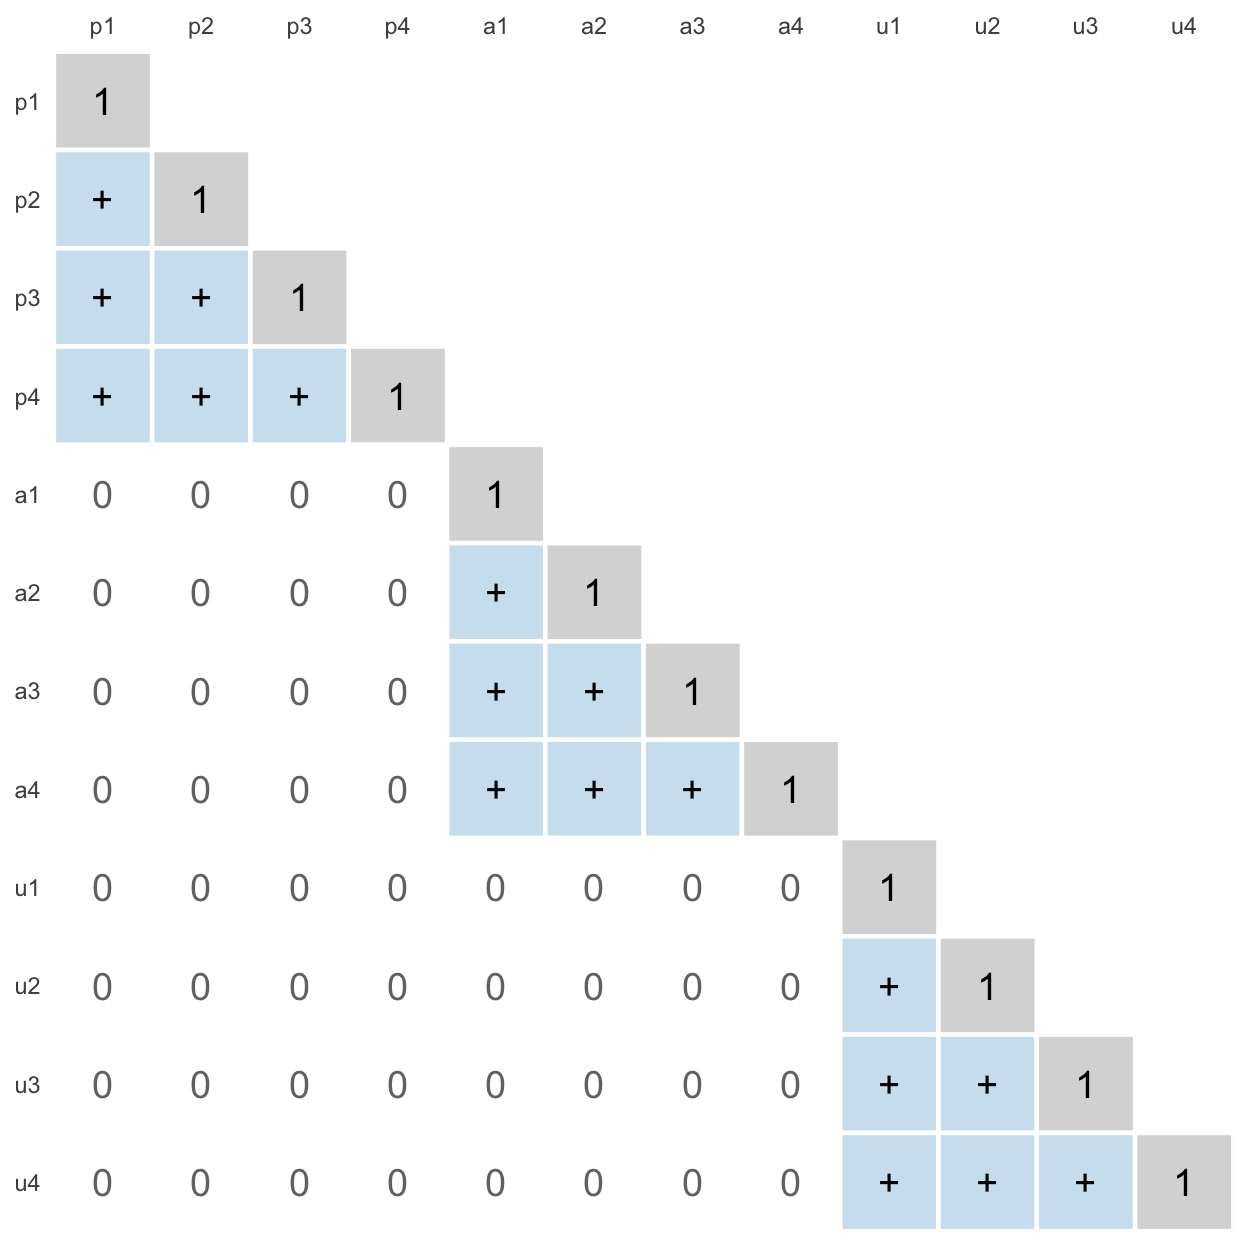
Dit is de verwachte, theoretische correlatiematrix. Er staat nog geen enkel getal in, en toch zegt hij iets: drie blokken plusjes op de diagonaal, en daarbuiten alleen nullen. Dat is wat de das belooft. Zeg tegen R hoe je model eruitziet, en R rekent uit hoe die matrix er dan precies uit zou moeten zien — niet alleen plus of nul, maar de getallen zelf. Die noemen we straks de teruggeschatte matrix.
En nu de data. De echte correlatiematrix, gewoon opgevraagd — in base R, en in het tabblad ernaast met dplyr. Base R is weer wat je zelf moet kunnen typen; het dplyr-tabblad mag je overslaan.
# items: de twaalf itemnamen, p1 tot en met u4, net als in thema 4.
round(cor(bos_dieren_dimensies[, items], use = "complete.obs"), 2)
p1 p2 p3 p4 a1 a2 a3 a4 u1 u2 u3 u4
p1 1.00 0.55 0.49 0.54 0.25 0.12 0.35 0.25 0.11 0.17 0.09 0.10
p2 0.55 1.00 0.50 0.56 0.27 0.17 0.27 0.31 0.07 0.12 0.08 0.11
p3 0.49 0.50 1.00 0.48 0.23 0.17 0.24 0.27 0.11 0.12 0.09 0.13
p4 0.54 0.56 0.48 1.00 0.25 0.23 0.29 0.33 0.12 0.20 0.17 0.20
a1 0.25 0.27 0.23 0.25 1.00 0.52 0.49 0.51 0.26 0.28 0.18 0.23
a2 0.12 0.17 0.17 0.23 0.52 1.00 0.53 0.47 0.29 0.31 0.21 0.23
a3 0.35 0.27 0.24 0.29 0.49 0.53 1.00 0.52 0.31 0.37 0.20 0.28
a4 0.25 0.31 0.27 0.33 0.51 0.47 0.52 1.00 0.29 0.25 0.17 0.23
u1 0.11 0.07 0.11 0.12 0.26 0.29 0.31 0.29 1.00 0.55 0.50 0.53
u2 0.17 0.12 0.12 0.20 0.28 0.31 0.37 0.25 0.55 1.00 0.57 0.59
u3 0.09 0.08 0.09 0.17 0.18 0.21 0.20 0.17 0.50 0.57 1.00 0.52
u4 0.10 0.11 0.13 0.20 0.23 0.23 0.28 0.23 0.53 0.59 0.52 1.00library(dplyr)
bos_dieren_dimensies |>
select(all_of(items)) |>
cor(use = "complete.obs") |>
round(2) p1 p2 p3 p4 a1 a2 a3 a4 u1 u2 u3 u4
p1 1.00 0.55 0.49 0.54 0.25 0.12 0.35 0.25 0.11 0.17 0.09 0.10
p2 0.55 1.00 0.50 0.56 0.27 0.17 0.27 0.31 0.07 0.12 0.08 0.11
p3 0.49 0.50 1.00 0.48 0.23 0.17 0.24 0.27 0.11 0.12 0.09 0.13
p4 0.54 0.56 0.48 1.00 0.25 0.23 0.29 0.33 0.12 0.20 0.17 0.20
a1 0.25 0.27 0.23 0.25 1.00 0.52 0.49 0.51 0.26 0.28 0.18 0.23
a2 0.12 0.17 0.17 0.23 0.52 1.00 0.53 0.47 0.29 0.31 0.21 0.23
a3 0.35 0.27 0.24 0.29 0.49 0.53 1.00 0.52 0.31 0.37 0.20 0.28
a4 0.25 0.31 0.27 0.33 0.51 0.47 0.52 1.00 0.29 0.25 0.17 0.23
u1 0.11 0.07 0.11 0.12 0.26 0.29 0.31 0.29 1.00 0.55 0.50 0.53
u2 0.17 0.12 0.12 0.20 0.28 0.31 0.37 0.25 0.55 1.00 0.57 0.59
u3 0.09 0.08 0.09 0.17 0.18 0.21 0.20 0.17 0.50 0.57 1.00 0.52
u4 0.10 0.11 0.13 0.20 0.23 0.23 0.28 0.23 0.53 0.59 0.52 1.00Vergelijk hem met je plusjes en nulletjes. Binnen de blokken lopen de correlaties van tot — plusjes, zoals beloofd. Maar kijk naar de cellen daarbuiten: van tot . Dat zijn geen nullen. Kleiner dan de plusjes, jawel — maar niet nul.
Je ziet het al, met het blote oog en zonder één toets: de das heeft iets gemist. Wat precies, en hoe erg, dat gaan we nu netjes doen.
Wat je waarneemt min wat je beloofde
stap 5 · herspecificatie
r − r̂ = residu
Twee getallen, verzin ze zelf. Stel, in het echt is de correlatie tussen p1 en p2 punt 8. En het model had gezegd: punt 7 — ik doe maar wat. Hoeveel zit het model ernaast? En stel dat de correlatie tussen p1 en a1 in het echt punt 3 is, terwijl het model nul had beloofd?
Dat verschil per cel is het residu: wat je waarneemt min wat het model beloofde. Punt 8 min punt 7 is punt 1, en punt 3 min 0 is punt 3. En die tweede is erger.
is het residu van item met item . Waarom daar een z voor staat, lees je zo meteen. Het dakje op betekent, net als bij in regressie: dit is wat uit het model rolt. Zo’n residu bereken je voor élke cel, en dan heb je een hele residuenmatrix. “Daar hoop je eigenlijk dat er allemaal nulletjes staan.” Want dan klopt jouw plaatje met de werkelijkheid: waargenomen is teruggeschat.
Eén afspraak nog. Hoe groot mag zo’n residu zijn voor je ervan schrikt? “Laten we even afspreken voor nu: als het tussen de min punt 1 en de plus punt 1 ligt, dan vinden we het wel dicht bij 0.” Een tiende in een correlatie is wat je met het blote oog in een puntenwolk terugziet; daaronder zoeken we niet.
R gaat die residuenmatrix straks voor je uitrekenen. Maar niet nu. Eerst nog twee dingen die je vóór het rekenen doet — en die je allebei met de hand moet kunnen.
Tellen voor je rekent: V, p en df
stap 2 · identificatie
Een cadeautje op je tentamen
Tel de pijlen op je tekening. Alle pijlen, elke soort apart: de errorpijlen, de pijlen van een ovaal naar een vierkantje, en de dubbele pijlen tussen ovalen. Schrijf de drie getallen op. Doe het echt, want zo meteen controleer je het tegen wat lavaan zegt.
Drie soorten, netjes onder elkaar:
- errorpijlen: elk item heeft er één, dus 12.
- voorspelpijlen — de ladingen: elk item hangt aan precies één factor, dus ook 12.
- correlatiepijlen — de dubbele: de das tekende er 0.
Samen , en anders dan in thema 4 telt die hier geen items maar de parameters van het model: alle getalletjes die R straks moet schatten. “Een dubbele pijl telt als één dingetje. Je wil één dingetje ervan weten.”
Nu de andere kant: hoeveel informatie heb je om die 24 getallen uit te halen? Kijk naar je plusjes-en-nullen-matrix van de weddenschap en tel de vakjes — de onderste driehoek, mét de diagonaal. Je komt op 78. Dat is : alle varianties (de diagonaal, 12 stuks) plus alle covarianties eronder. Elke pijl die je tekent, eet één van die vakjes op.
Met de formule gaat het sneller dan tellen:
met het aantal items, een letter die in thema 4 nog de componenten telde.
En dan:
“Het zit altijd in het tentamen.” De vrijheidsgraden van een model: hoeveel getallen je probeert na te bootsen, min hoeveel getallen je daarvoor mag schatten. Ben je het ermee eens dat hoe meer pijlen je trekt, hoe hoger wordt — en dus hoe lager ? Een complexer model heeft minder vrijheidsgraden. Houd dat vast.
Eén regel om erbij te onthouden: tel de pijlen, en zeg erbij dat de factoren op staan. Waarom dat erbij moet, staat hieronder; om mee te rekenen volstaat de regel.
Is het model wel te toetsen? Identificatie
stap 2 · identificatie
Eén punt, oneindig veel lijnen
Teken twee puntjes op een blaadje, en trek er een regressielijn door. Lukt dat? Ja — hij kan niet missen. En nu: zou je uit die twee puntjes kunnen schatten hoe die lijn bij herhaling zou variëren? Dat wordt lastig. “Als je maar twee puntjes hebt, heb je te weinig informatie om te schatten hoe het zou variëren bij herhaling.” Je kunt de lijn wel tekenen, maar niet toetsen. En met één puntje? Dan passen er oneindig veel lijnen doorheen, en kun je hem niet eens tekenen.
Dat is wat je vertelt over een model:
| ondergeïdentificeerd under-identified | meer pijlen dan vakjes: het model is niet te schatten | |
| precies geïdentificeerd just identified | precies genoeg: te schatten, maar niet te toetsen — het past altijd | |
| overgeïdentificeerd over-identified | er blijft informatie over, en dáár toets je mee |
Je kent dit al van vroeger. : dat los je op, . Maar ? Als één is, is negen; als twee is, is acht. Oneindig veel oplossingen — ondergeïdentificeerd, het geval . Geef er een tweede vergelijking bij, , en het stelsel is wél op te lossen: uit de eerste volgt , vul dat in de tweede in, en er komt precies één antwoord uit — en . Een nul als antwoord voelt raar, maar het is er precies één. Dat is , precies geïdentificeerd: het past perfect, en juist daarom valt er niets te toetsen.
En nu het derde geval, en dat is degene waar dit hoofdstuk in leeft. Zet er een dérde vergelijking bij, , en kijk wat je oplossing daar doet: , en er werd 18 gevraagd. Er bestaat nu geen enkel paar en dat alle drie de vergelijkingen tegelijk waarmaakt. Wat je dan doet is niet opgeven maar het beste compromis zoeken — de waarden die er gezamenlijk het minst naast zitten. En dat restje, dat wat er ná het beste compromis nog overblijft, is precies wat straks meet. Dat is : overgeïdentificeerd, geen perfecte maar wel een minst slechte oplossing, en toetsbaar.
Twee onbekenden hebben twee vergelijkingen nodig. Een model met 24 parameters heeft 24 vakjes nodig, en toetsen kan pas met wat er daarna overblijft.
Je kunt het lavaan zelf laten zeggen. Eén factor, piekeren, en dan met twee, drie en vier items:
fit_twee <- cfa('piekeren =~ p1 + p2', data = bos_dieren_dimensies, std.lv = TRUE)Warning: lavaan->lav_model_vcov():
Could not compute standard errors! The information matrix could not be
inverted. This may be a symptom that the model is not identified.fit_drie <- cfa('piekeren =~ p1 + p2 + p3', data = bos_dieren_dimensies, std.lv = TRUE)
fit_vier <- cfa('piekeren =~ p1 + p2 + p3 + p4', data = bos_dieren_dimensies, std.lv = TRUE)
round(rbind(twee = fitMeasures(fit_twee, c("npar", "df", "chisq", "pvalue")),
drie = fitMeasures(fit_drie, c("npar", "df", "chisq", "pvalue")),
vier = fitMeasures(fit_vier, c("npar", "df", "chisq", "pvalue"))), 3) npar df chisq pvalue
twee 4 -1 NA NA
drie 6 0 0.000 NA
vier 8 2 0.064 0.968Twee items: , , dus — en lavaan waarschuwt meteen dat het model misschien niet geïdentificeerd is. Drie items: , , — de is precies nul en er is geen -waarde, want er valt niets te toetsen. Pas bij vier items blijft er iets over. “Eigenlijk is drie items voor één construct, of twee items, een beetje weinig. Vanaf drie zeggen we nou oké dat kan nog wel; misschien vanaf vier beter.” Nu weet je waarom.
Eén waarschuwing hoort er nog bij: een model kan ook empirisch ondergeïdentificeerd zijn, door afhankelijkheden in de data. Op papier klopt de telling, maar hoe de items in je data samenhangen — of juist níét samenhangen — laat je toch zitten. Stel dat één van die drie piekeritems met geen van de andere twee samenhangt: dan houd je in feite twee items over, en twee was al te weinig. Je ziet het aan de uitvoer: rare schattingen met enorme standaardfouten, vaak met een waarschuwing van lavaan erbij.
Het model van de das heeft , dus ruim boven nul. Overgeïdentificeerd. “Wij zijn blij. We kunnen toetsen. We kunnen door.”
Past het? Het eerste model in R
stap 4 · evaluatie
De das legt zijn tekening op de data
Voorspel eerst. Je hebt de correlatiematrix gezien: plusjes waar plusjes beloofd waren, en tussen de blokken correlaties van tot waar nullen beloofd waren. Denk je dat het model van de das past? Zeg het hardop, en kijk dan pas naar de uitvoer.
fit_1 <- cfa(model_1, data = bos_dieren_dimensies, std.lv = TRUE)
fitMeasures(fit_1, c("npar", "chisq", "df", "pvalue", "nfi", "cfi", "rmsea"))
npar chisq df pvalue nfi cfi rmsea
24.000 108.416 54.000 0.000 0.877 0.933 0.071 Eerst een check die niets kost: npar is 24 en df is 54. Dat zijn precies de getallen die je even terug met de hand telde. “Hebben wij goed gerekend. Hebben we een check.” (Eén dier heeft p3 niet ingevuld — dat ken je uit thema 4. lavaan laat dat dier weg en rekent met 199 van de 200 dieren; in summary() zie je dat straks staan als Used en Total.)
En kijk eerst even naar wat het model heeft teruggeschat — de matrix die bij de tekening hoort, nu met getallen in plaats van plusjes en nullen:
round(cov2cor(fitted(fit_1)$cov), 2) p1 p2 p3 p4 a1 a2 a3 a4 u1 u2 u3 u4
p1 1.00
p2 0.55 1.00
p3 0.48 0.50 1.00
p4 0.54 0.56 0.49 1.00
a1 0.00 0.00 0.00 0.00 1.00
a2 0.00 0.00 0.00 0.00 0.51 1.00
a3 0.00 0.00 0.00 0.00 0.52 0.52 1.00
a4 0.00 0.00 0.00 0.00 0.50 0.50 0.50 1.00
u1 0.00 0.00 0.00 0.00 0.00 0.00 0.00 0.00 1.00
u2 0.00 0.00 0.00 0.00 0.00 0.00 0.00 0.00 0.56 1.00
u3 0.00 0.00 0.00 0.00 0.00 0.00 0.00 0.00 0.50 0.57 1.00
u4 0.00 0.00 0.00 0.00 0.00 0.00 0.00 0.00 0.52 0.59 0.53 1.00Dat zijn je plusjes en je nullen. Binnen de blokken heeft lavaan de plusjes ingevuld met wat er het best paste; tussen de blokken staat, letterlijk, nul — want dat had de das getekend. Alles wat nu volgt is de vergelijking van déze matrix met de echte.
De toets: chi-kwadraat
Kijk nog eens naar die residuenmatrix vol nulletjes waar we op hoopten. Denk de minnetjes even weg en tel alle afwijkingen bij elkaar op. Als het model klopt, moet dat bij elkaar nul zijn. In het echt is het nooit nul; de vraag is of het significant van nul afwijkt. Zie die optelling als een toetswaarde — en die toetswaarde is .
Nu de hypothesen, en dit is het moment waarop het even raar wordt. Wat zou zeggen over ons model? zegt altijd hetzelfde: geen verschil. Dus is: model en data zijn hetzelfde, het model past. En : het past niet.
Voluit geschreven luidt dezelfde : de geobserveerde en de teruggeschatte variantie-covariantiematrix zijn identiek. Dat is je weddenschap van daarnet — de echte matrix naast de matrix die het model belooft. (Een variantie-covariantiematrix is de ruwe versie van een correlatiematrix; voor deze toets komt het op hetzelfde uit.)
“Het is best verwarrend hier zo. Want je wil H0, toch?” Als psycholoog wil je bewijzen dat je model klopt, en dat betekent hier: je hoopt op . Precies andersom dan je gewend bent. De redding is een vaste routine, en die staat hieronder in het kader.
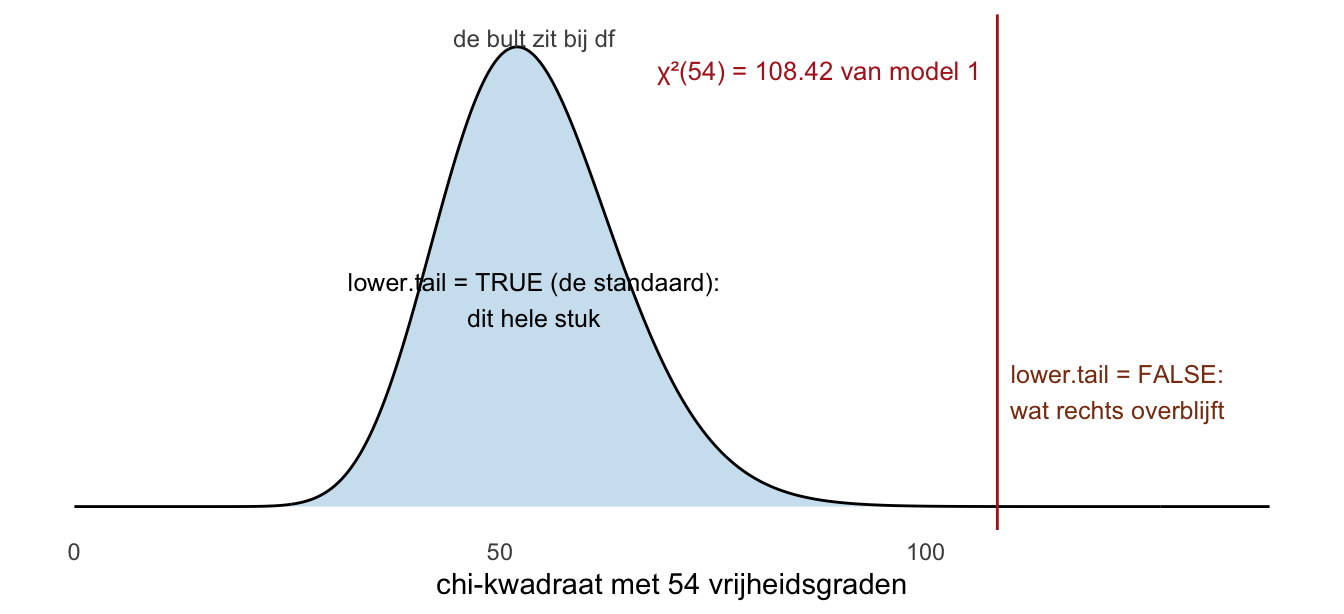
, p < .001. When p is low, H0 must go. We verwerpen : het model van de das past niet op de data. “Volgens deze toets. Het is een rot model dus.”
De fit-maten: goodness en badness
is een toets, met een -waarde en dus een beslissing. Daarnaast zijn er fit-maten — ook wel beschrijvende fitmaten genoemd, omdat ze beschrijven in hoeverre de data met het model overeenkomen: een getal, een grenswaarde, en verder niets. “Bij die fitmaten had je geen p-waarde. Dat is gewoon op grenswaarde beslissen.” Een fit-maat is geen toets, en doet ook niet alsof.
Handiger dan de namen is een indeling in twee soorten. Bij een goodness of fit is hoger beter; bij een badness of fit is hoger juist slechter, en kijk je dus de andere kant op.
En dan de getallen. Dit oefenboek werkt per maat met drie banden, niet één grens. De banden goed en redelijk komen uit een overzichtsartikel van Schermelleh-Engel et al. (2003). Bij RMSEA blijft er een vakje tussen zitten waar geen naam op staat:
| maat | goed | redelijk | geen etiket | slecht | |
|---|---|---|---|---|---|
| goodness of fit | CFI | – | — | ||
| NFI | – | — | |||
| badness of fit | RMSEA | – | – |
Een streepje in de kolom geen etiket betekent: bij die maat sluiten de banden op elkaar aan, dus daar valt niets tussenin. Alleen RMSEA heeft een gat.
In Engelstalige bronnen heet de middelste band acceptable of adequate; hier heet hij altijd redelijk. Links en rechts heten good en poor.
Dat lege vakje is in deze tabel echt leeg, en dat moet je weten. De middenband van RMSEA loopt tot en slecht begint pas bij . Wat daartussen ligt, krijgt hier geen naam; in de literatuur heet het soms matig (zie het kader hieronder), maar die naam zegt je niet of het model goed genoeg is. Dat is niet iets wat jij moet oplossen; het is iets wat je moet herkennen. Kom je een RMSEA van tegen, dan is het eerlijke antwoord: niet meer redelijk, nog niet slecht — en dan leunt je conclusie op de andere twee maten. Noteer het, en doe niet alsof je een grens weet die er niet staat.
Nu ons eigen model. Per maat het getal, en in welke band hij valt:
| De drie fitmaten van model 1 | ||
| maat | model 1 | band |
|---|---|---|
| RMSEA (badness) | 0.071 | redelijk |
| NFI (goodness) | .877 | slecht |
| CFI (goodness) | .933 | slecht |
twee stemmen voor slecht, en zei ook al nee.
En als de maten het oneens zijn? Dat gebeurt, zoals je hier ziet. Dit oefenboek gebruikt daar één regel voor: volg de meerderheid. Zo beslist niet één maat in zijn eentje. Dus tel, en ga met de meeste mee — hier is de uitkomst slecht.
Drie dingen die je bij dat tellen moet weten:
- Je telt alleen de drie maten. De -toets doet niet mee in de telling. Die heeft zijn eigen beslissing, op een -waarde, en die rapporteer je apart. Anders zou je een toets en drie vuistregels in één stapeltje gooien.
- Soms is er geen meerderheid. Drie maten in drie verschillende banden — goed, redelijk, slecht — geeft niets om mee te gaan. Dan verzin je er geen: je schrijft op dát de maten het oneens zijn, en de -toets en de residuen doen het werk.
- Tellen is beslissen, niet rapporteren. Wat je opschrijft is alles: de toets en alle drie de maten, ook de maat die iets anders zei. Dat ze het oneens waren is zelf een resultaat, en dat poets je niet weg door alleen de meerderheid te noemen.
Eén streep of drie banden. Je komt ook materiaal tegen dat per maat maar één streep trekt — bijvoorbeeld NFI , CFI en RMSEA als eis voor een goede fit. Leg die drie getallen naast de tabel hierboven en je ziet dat het precies de ondergrens is — de streep tussen slecht en de rest.
Let wel op het woord, want daar zit het enige verschil. Met één streep zijn er twee vakken, goed en niet goed, en heet alles boven die streep goed. De drie banden knippen dat bovenste vak nog een keer doormidden in redelijk en goed. Een NFI van heet met één streep dus goed en hier redelijk, en dat is geen tegenspraak maar een fijnere verdeling van hetzelfde. Rapporteer daarom het getal en niet alleen het woord — dan kan niemand zich vergissen in welke indeling je gebruikte. Vraagt een opgave om één woord, gebruik dan de indeling die de opgave zelf aanreikt.
Drie maten, en dat is het hele rijtje. (lavaan drukt er in summary() nog een paar méér af. Die tellen hier niet mee; over de bekendste daarvan, TLI, en waarom hij niet meetelt, gaat het kader hieronder.) De literatuur legt de lat nog weer anders, en ook dat staat daar.
Eén gewoonte houd je erbij: grenswaarden zijn afspraken, geen natuurwetten. Werk je met ander materiaal, kijk dan welke afspraak dat volgt — niet omdat je iets anders verwacht, maar omdat je dan weet wáár je zou kijken.
De residuen: wáár gaat het mis?
Toets en maten zeggen dat het niet past. Nu willen we weten waar. Daarvoor is de residuenmatrix, en lavaan rekent hem uit met residuals() — met type = "cor", zodat hij op correlatieschaal staat:
round(residuals(fit_1, type = "cor")$cov, 2) p1 p2 p3 p4 a1 a2 a3 a4 u1 u2 u3 u4
p1 0.00
p2 0.00 0.00
p3 0.01 0.00 0.00
p4 0.00 0.00 0.00 0.00
a1 0.25 0.27 0.23 0.25 0.00
a2 0.12 0.17 0.17 0.23 0.01 0.00
a3 0.35 0.27 0.24 0.29 -0.02 0.01 0.00
a4 0.25 0.31 0.27 0.33 0.01 -0.03 0.01 0.00
u1 0.11 0.07 0.11 0.12 0.26 0.29 0.31 0.29 0.00
u2 0.17 0.12 0.12 0.20 0.28 0.31 0.37 0.25 -0.01 0.00
u3 0.09 0.08 0.09 0.17 0.18 0.21 0.20 0.17 0.00 0.01 0.00
u4 0.10 0.11 0.13 0.20 0.23 0.23 0.28 0.23 0.01 0.00 -0.01 0.00Zoek eerst zelf. Waar staan de grote getallen — verspreid, of bij elkaar? En wat is hun teken?
Toon code (residuen als tegels)
teken_residuen <- function(r, titel = NULL) {
  as.data.frame(as.table(r)) |>
    setNames(c("rij", "kol", "res")) |>
    mutate(rij = as.character(rij), kol = as.character(kol),
           ri = match(rij, items), ki = match(kol, items)) |>
    filter(ri > ki) |>
    ggplot(aes(ki, -ri, fill = res)) +
    geom_tile(colour = "white", linewidth = 0.6) +
    geom_text(aes(label = res(res, 2)), size = 2.8) +
    scale_fill_gradient2(low = "#b2182b", mid = "white", high = "#2166ac",
                         midpoint = 0, limits = c(-.4, .4), name = "residu") +
    scale_x_continuous(breaks = 1:k, labels = items, position = "top", expand = c(0, 0)) +
    scale_y_continuous(breaks = -(1:k), labels = items, expand = c(0, 0)) +
    coord_fixed() +
    labs(x = NULL, y = NULL, title = titel) +
    theme_minimal(base_size = 11) +
    theme(panel.grid = element_blank(), legend.position = "bottom")
}
teken_residuen(res_1)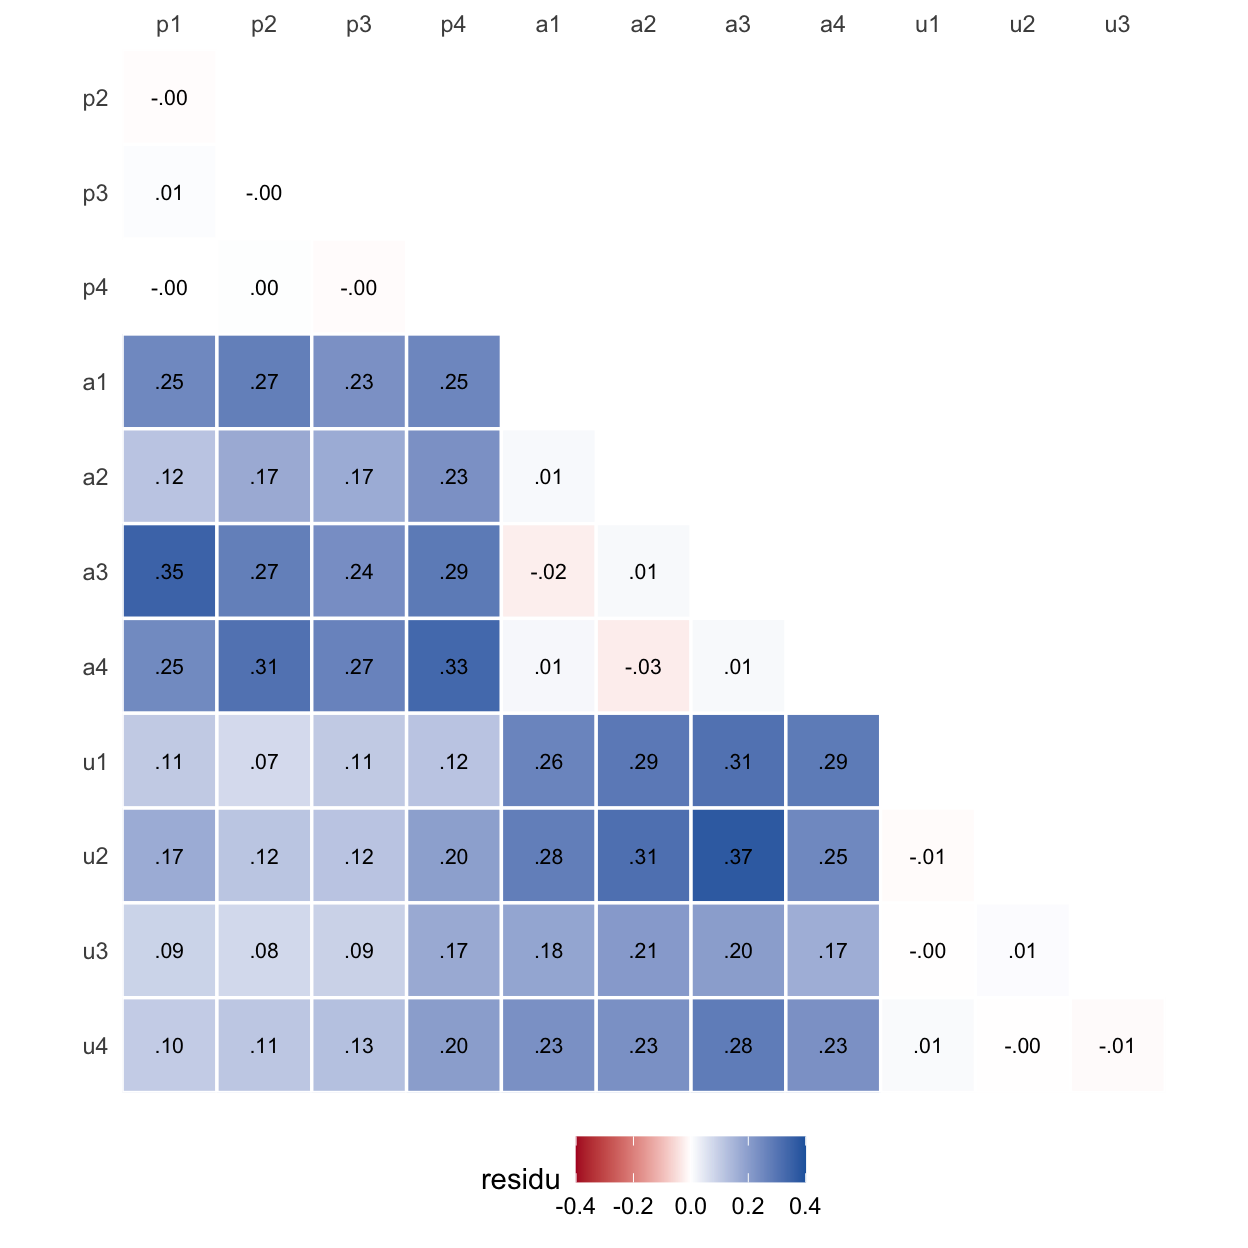
Een heel blok positieve residuen tussen de items van twee factoren betekent één ding: die twee factoren hangen wél samen, en het model ontkent dat. Het model zat te laag — het onderschat elke correlatie tussen die twee groepen tegelijk.
“Maar wat denk je zelf? Wij zijn natuurlijk geen naïeve psychologen.” Piekeren en uitstelgedrag hangen samen; dat wist je in thema 4 al, toen de componenten onder oblimin bleken te correleren. De das ook, eigenlijk. Dus hij geeft één ding toe.
De das geeft één ding toe: drie dubbele pijlen
stap 5 · herspecificatie
Model 2, en hoeveel het scheelt
Voorspel weer eerst. De das tekent drie dubbele pijlen bij, tussen elk paar factoren. Wat gebeurt er met ? Met ? En wordt de groter of kleiner? Schrijf je drie antwoorden op.
model_2 <- '
  piekeren      =~ p1 + p2 + p3 + p4
  alertheid     =~ a1 + a2 + a3 + a4
  uitstelgedrag =~ u1 + u2 + u3 + u4
'
fit_2 <- cfa(model_2, data = bos_dieren_dimensies, std.lv = TRUE)
fitMeasures(fit_2, c("npar", "chisq", "df", "pvalue", "nfi", "cfi", "rmsea"))
npar chisq df pvalue nfi cfi rmsea
27.000 38.362 51.000 0.904 0.956 1.000 0.000 Drie pijlen erbij: gaat van 24 naar 27, van 54 naar 51. Erbij bij , eraf bij — “bedenk wel even, gaat het er nou juist bij of gaat het er vanaf? Want het was V min p, hè? Dat is best verwarrend allemaal.” En de zakt van naar .
: model 2 past. , p = .90. Niet significant, dus blijft staan: de data zeggen geen nee tegen dit model. RMSEA (goed), NFI (goed), CFI (goed) — alle drie in de bovenste band, en ook binnen de grenzen uit de literatuur. Vier op vier, en niets om een meerderheid over te tellen.
Let wel op wat je daarmee koopt. De data kunnen “hmmm” zeggen of “nee”, maar nooit “ja”: een model dat niet verworpen wordt is verenigbaar met de data, en er zijn altijd andere modellen die dat óók zijn. Een model kan worden weerlegd, niet bewezen.
De weg: vier modellen op één lijn
Teken dit als een weg — dat beeld is waar de rest van dit thema aan hangt.
“Denk even aan Den Haag. We hebben de stad Leiden. En we hebben de stad Amsterdam. Alsof ze op één weg aan elkaar liggen.” Den Haag is de data. Leiden is ons model — model 2. En Amsterdam is het nulmodel: het allerslechtste model ter wereld. Model 1, het naïeve, ligt ergens onderweg tussen Leiden en Amsterdam. De afstand tot Den Haag is de : hoe kleiner, hoe beter het past.
Wat is dat nulmodel? Denk gewoon: gemiddelde. “Wij hebben twaalf items. Dus het nulmodel voor die twaalf items is gewoon die twaalf gemiddelden.” Geen verbanden, alles is error: twaalf vierkantjes met alleen hun errorpijl. Tel: , dus . In de uitvoer heet dit baseline.
Toon code (de weg)
weg <- data.frame(
  x    = c(0, 1, 2, 3),
  naam = c("de data", "model 2\n(de das geeft toe)", "model 1\n(de das, naïef)", "het nulmodel"),
  chi  = c(0, fm2$chisq, fm1$chisq, fm2$baseline.chisq),
  df   = c(NA, fm2$df, fm1$df, fm2$baseline.df))
# Elke boog is een halve ellips met een BEKENDE top, en daar staat zijn getal,
# in een wit label. Tot 25-9-2026 tekende annotate("curve") de bogen en stond
# het label op halve hoogte -- het getal van het nulmodel lag daardoor op de
# boog van model 1, en alleen de kleur (oranje tegen bruin) zei dat het daar
# niet hoorde. Testlezer Beeldverteller ving dat. Nu ligt de top vast.
boog <- function(a, b, h, kleur, txt) {
  t   <- seq(0, pi, length.out = 80)
  pad <- data.frame(x = (a + b) / 2 + (b - a) / 2 * cos(t), y = h * sin(t))
  list(geom_path(data = pad, aes(x, y), colour = kleur, linewidth = 0.7),
       # `linewidth = 0` haalt het randje om het witte labelvlak weg. Tot
       # 27-9-2026 stond hier `label.size = 0`; die naam is sinds ggplot2 3.5
       # vervangen door `linewidth`, en een onbekende parameter wordt
       # genegeerd -- met een waarschuwing die niemand zag, want de
       # waarschuwingentoets kon thema 5 tot vandaag niet meten. Het randje
       # stond er dus gewoon nog omheen.
       annotate("label", x = (a + b) / 2, y = h, label = txt, colour = kleur,
                size = 3.4, fill = "white", linewidth = 0))
}
ggplot(weg, aes(x, 0)) +
  geom_hline(yintercept = 0, colour = "grey60") +
  geom_point(size = 4) +
  geom_text(aes(label = naam), vjust = 1.6, size = 3.3, lineheight = 0.9) +
  boog(0, 1, 0.30, "#1b6ca8", sprintf("χ²(%d) = %s", fm2$df, fmt_b(fm2$chisq))) +
  boog(0, 2, 0.55, "#c47a10", sprintf("χ²(%d) = %s", fm1$df, fmt_b(fm1$chisq))) +
  boog(0, 3, 0.85, "#8a3b12", sprintf("χ²(%d) = %s", fm2$baseline.df, fmt_b(fm2$baseline.chisq))) +
  boog(1, 2, -0.40, "#1a7f37", sprintf("Δχ²(%d) = %s", d_12_df, fmt_b(d_12_print))) +
  scale_x_continuous(limits = c(-0.3, 3.3)) +
  scale_y_continuous(limits = c(-0.6, 0.98)) +
  labs(x = "afstand tot de data — niet op schaal", y = NULL) +
  theme_minimal(base_size = 11) +
  theme(axis.text = element_blank(), panel.grid = element_blank())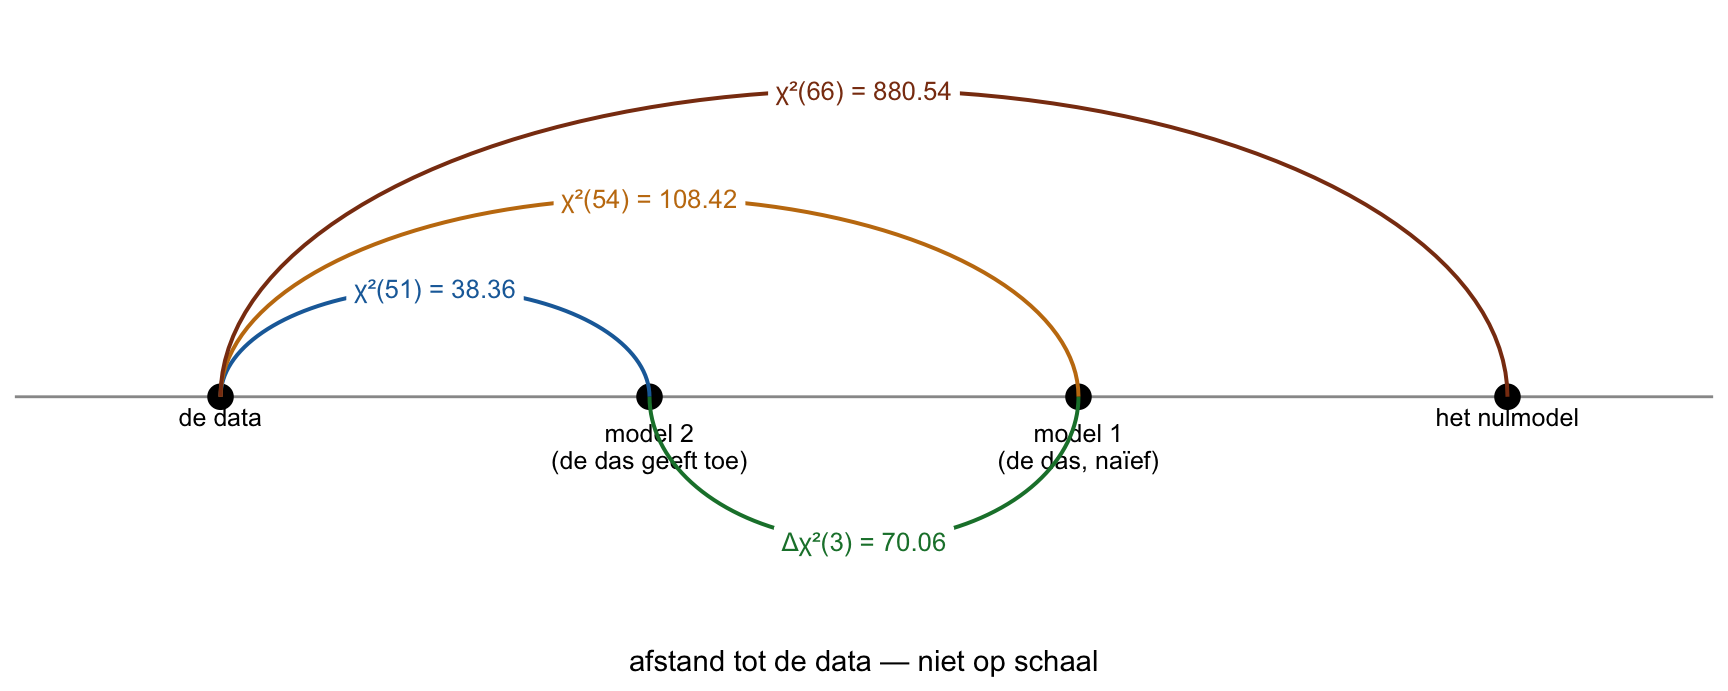
Δχ² — is model 2 écht beter dan model 1?
Twee vragen die op elkaar lijken en het niet zijn. Allebei hebben ze een naam:
| vraagt | waarmee | |
|---|---|---|
| modeltoets | past dít ene model bij de data? | de uit de evaluatie |
| effecttoets | past het ene model beter dan het andere? | het verschil van twee chi-kwadraten |
De modeltoets heb je nu twee keer gedaan: één keer op model 1 (afgewezen) en één keer op model 2 (niet afgewezen). Wat hieronder komt is de effecttoets. En let op de vangrail die daarbij hoort en niet bij de modeltoets: een effecttoets mag alleen als de twee modellen genest zijn. Wat dat betekent, staat verderop; hier zijn ze dat, want er zijn alleen pijlen bij gekomen.
Gok eerst. Drie pijlen erbij en de zakt met . Is dat veel voor drie pijlen? Hier is je maat, en je hebt hem al gezien: als er niets aan de hand is, zit de bult van een bij zijn eigen vrijheidsgraden. Drie pijlen die níéts doen, zouden de dus met ongeveer laten zakken. Vergelijk daarmee.
Twee modellen, en de vraag of het ingewikkelde er echt iets bij wint. Weer hypothesen, en weer zegt geen verschil:
De toetswaarde is de afstand tussen de twee: het verschil van hun chi-kwadraten, met als vrijheidsgraden het verschil van hun . “Altijd groot min klein.”
Precies drie, want er zijn precies drie pijlen bijgekomen. En dan de -waarde. Vraag je een groep studenten wat je hiervoor in R typt, dan komt er bijna altijd eerst dit:
pchisq(70.06, df = 3)[1] 1“Heeft hij 1? Dan hebben we een probleem.” Want dit klopt niet. Kijk terug naar de staart-tekening van de chi-kwadraat: R geeft je hier de kans op een kleinere waarde — het hele blauwe stuk links van je streep, en bij een grote is dat vrolijk alles. Jij wilt wat er rechts overblijft. “By default staat hij dus op lower. Maar je wil upper.” Dus een derde argument erbij:
pchisq(70.06, df = 3, lower.tail = FALSE)[1] 4.143914e-15Dat lower.tail = FALSE is niet optioneel; vergeet je het, dan denk je dat er niets is terwijl er alles is. En wat komt eruit? . R schrijft dat in wetenschappelijke notatie, en daar kijk je zo overheen. Schrijf hem eens uit: dat is
met 14 nullen achter de komma voordat er iets komt. “Dus het is gewoon 0.” Knijtersignificant. We verwerpen : model 2 verschilt echt van model 1.
En dan één stapje dat je zelf moet zetten, want de toets zegt alleen verschillend en niet beter. Denk terug aan de weg: een model met meer pijlen ligt altijd dichter bij de data — pijlen erbij kan de fit nooit slechter maken. Van twee geneste modellen staat het complexere dus per definitie voor of gelijk. Verschillen ze significant, dan kan dat maar één kant op zijn, en daarom betekent verschilt hier is beter. Die drie dubbele pijlen doen iets. Of tenminste één van de drie; welke, dat zegt deze toets niet.
En zonder R? Zit je zonder console — op een tentamen, bijvoorbeeld — dan hoeft dat ook niet: je hebt aan één opgezochte grens genoeg.
Zoek in een chi-kwadraattabel bij jouw de kritieke waarde, en kijk of je toetswaarde erboven ligt. Ligt hij erboven, dan is het significant; ligt hij eronder, dan niet. Meer hoef je niet te doen.
Bij is die grens . Onze van ligt daar ruim boven, dus significant — dezelfde beslissing als hierboven. (Zo’n tabel heeft meestal meer kolommen: de grens voor p < .001 ligt bij deze op , en ook daar zitten we overheen.)
Het verschil tussen de twee routes is dus alleen wat je overhoudt: de tabel geeft je een ja of nee, pchisq() geeft je er de -waarde bij.
(Reken je met de ongeronde chi-kwadraten, zoals anova() verderop doet, dan kom je op en een net iets andere -waarde. Dat is afronding, geen verschil.)
Genest — wanneer mag je twee modellen vergelijken?
Kijk naar de tekening van model 1 en de drie regels van model 2. Kun je van de ene naar de andere komen door alléén pijlen bij te tekenen, zonder er één weg te halen? Ja: drie dubbele pijlen erbij en je hebt model 2. Dan zijn ze genest, en alleen dan mag de effecttoets — alleen dan zegt iets.
“Wanneer is een vogeltje lekker genest? Als hij er niet doorheen pleurt.” Hieronder staat een tak met drie takjes, en daaroverheen, dunner, dezelfde tak met twee:
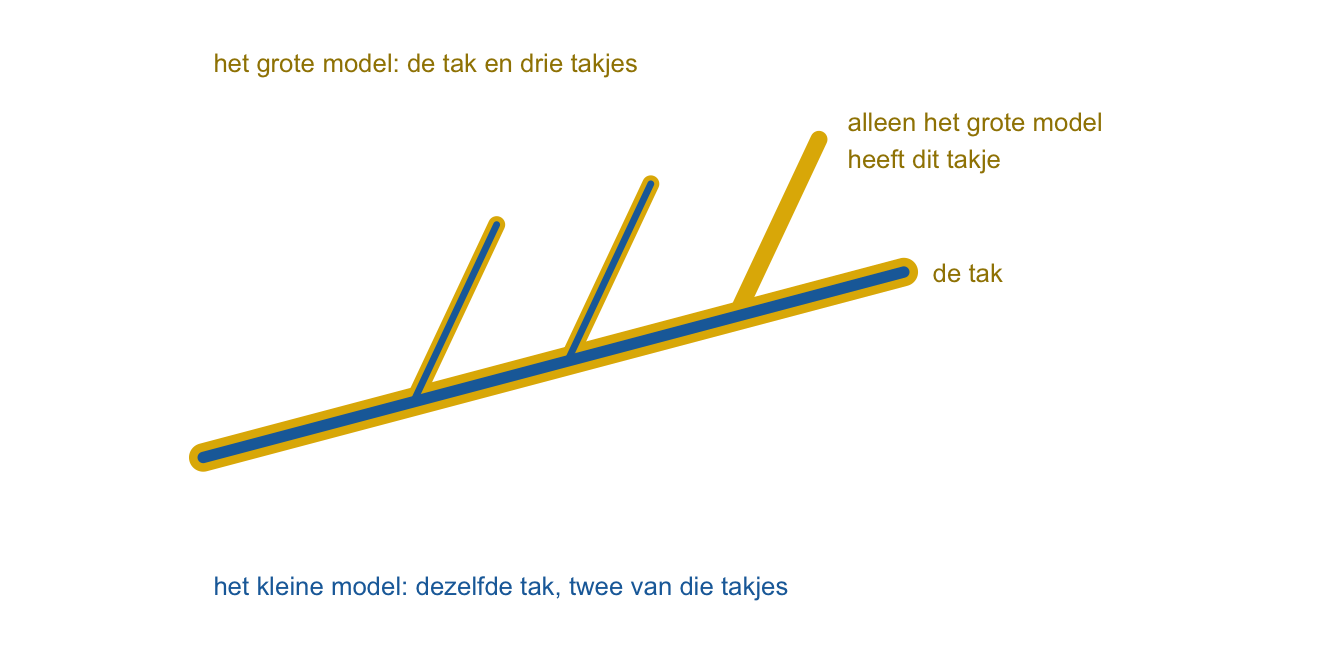
Het kleine model zit in het grote: het grote heeft alles wat het kleine heeft, plus een takje extra. “Een nestje kan zich niet nesten in een vogel. Maar een vogeltje kan wel genest zijn in een nestje.” Strikt genomen is het kleine model genest binnen het grote.
De praktische regel: begin bij één van de twee en kijk of je naar de andere komt door alleen toe te voegen. Lukt het niet, doe het dan ook andersom. Moet je in beide richtingen zowel toevoegen áls weghalen, dan zijn ze niet genest en zegt het verschil van hun chi-kwadraten niets. “Zit zeker in het tentamen. Het is gewoon een weggevertje. Even goed kijken, dubbel kijken, heen en terug.”
In lavaan doet anova() de verschiltoets voor je — en die controleert niet of je modellen genest zijn. Dat blijft jouw werk:
anova(fit_1, fit_2)
Chi-Squared Difference Test

      Df    AIC    BIC   Chisq Chisq diff   RMSEA Df diff Pr(>Chisq)
fit_2 51 5997.1 6086.0  38.362
fit_1 54 6061.1 6140.2 108.416     70.054 0.33514       3  4.156e-15 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
De pijlen zelf: een lading is een regressiegewicht
stap 3 · parameters schatten (hier: lezen)
Wat er op elke pijl staat
Kijk eens naar het labeltje onder het kopje: we gingen van stap 4 naar 5, en nu terug naar 3. Dat is geen slordigheid. De vijf stappen zijn geen rij maar een rondje — een cyclus — en dit hoofdstuk loopt dat rondje langs, met het schatten op de plek waar jij het nodig hebt. Dat is precies het rondje dat aan het begin van dit hoofdstuk staat getekend.
Want R en jij doen het in een andere volgorde, en dat is geen toeval:
- R schat eerst alle parameters, en rekent daarna pas de fit uit. Dat moet ook wel: zonder schattingen valt er niets te vergelijken.
- Jij kijkt eerst of het model past, en pas als het antwoord ja is, kijk je wat er op de pijlen staat.
Waarom die volgorde ertoe doet: past het model niet, dan zijn de ladingen zinloos om te interpreteren. Ze staan er wel — R drukt ze gewoon af — maar het zijn de beste schattingen bij een tekening waarvan de data net gezegd hebben dat hij niet klopt. Een mooie lading in een afgewezen model is een net getal op een verkeerde plek. Daarom komen de pijlen van model 1 in dit hoofdstuk niet aan bod en die van model 2 wel.
Kijk naar de uitvoer hieronder en zoek de lading van p1 op piekeren. Je vindt hem drie keer, op één regel. Welke van de drie zou je rapporteren?
summary(fit_2, standardized = TRUE)lavaan 0.7-2 ended normally after 17 iterations
Estimator ML
Optimization method NLMINB
Number of model parameters 27
Used Total
Number of observations 199 200
Model Test User Model:
Test statistic 38.362
Degrees of freedom 51
P-value (Chi-square) 0.904
Parameter Estimates:
Standard errors Standard
Information Expected
Information saturated (h1) model Structured
Latent Variables:
Estimate Std.Err z-value P(>|z|) Std.lv Std.all
piekeren =~
p1 0.737 0.068 10.880 0.000 0.737 0.730
p2 0.744 0.066 11.321 0.000 0.744 0.753
p3 0.661 0.070 9.504 0.000 0.661 0.656
p4 0.765 0.068 11.207 0.000 0.765 0.747
alertheid =~
a1 0.726 0.070 10.427 0.000 0.726 0.706
a2 0.661 0.065 10.248 0.000 0.661 0.697
a3 0.754 0.068 11.170 0.000 0.754 0.745
a4 0.741 0.072 10.327 0.000 0.741 0.701
uitstelgedrag =~
u1 0.747 0.071 10.552 0.000 0.747 0.706
u2 0.770 0.062 12.509 0.000 0.770 0.804
u3 0.672 0.065 10.399 0.000 0.672 0.698
u4 0.718 0.064 11.159 0.000 0.718 0.737
Covariances:
Estimate Std.Err z-value P(>|z|) Std.lv Std.all
piekeren ~~
alertheid 0.491 0.071 6.926 0.000 0.491 0.491
uitstelgedrag 0.237 0.082 2.888 0.004 0.237 0.237
alertheid ~~
uitstelgedrag 0.497 0.070 7.135 0.000 0.497 0.497
Variances:
Estimate Std.Err z-value P(>|z|) Std.lv Std.all
.p1 0.477 0.064 7.456 0.000 0.477 0.467
.p2 0.423 0.060 7.077 0.000 0.423 0.433
.p3 0.578 0.069 8.326 0.000 0.578 0.569
.p4 0.464 0.065 7.181 0.000 0.464 0.442
.a1 0.529 0.068 7.775 0.000 0.529 0.501
.a2 0.463 0.059 7.892 0.000 0.463 0.514
.a3 0.456 0.063 7.211 0.000 0.456 0.445
.a4 0.569 0.073 7.841 0.000 0.569 0.509
.u1 0.561 0.070 7.991 0.000 0.561 0.501
.u2 0.324 0.051 6.316 0.000 0.324 0.354
.u3 0.475 0.059 8.080 0.000 0.475 0.512
.u4 0.434 0.057 7.581 0.000 0.434 0.457
piekeren 1.000 1.000 1.000
alertheid 1.000 1.000 1.000
uitstelgedrag 1.000 1.000 1.000(De fit-maten laat deze summary() weg; die had je al met fitMeasures(). Wil je alles in één keer, zet er dan fit.measures = TRUE bij.)
Neem van p1 op piekeren, uit Std.all: . “Zie dit als een factorlading, componentlading. Net zoals bij PCA. Zie het als een regressiegewicht. Een gewichtje wat je toekent.” Hoger op piekeren, hoger op p1. Zo zou je op elke pijl het bijbehorende gewichtje kunnen schrijven:
Toon code (semPaths met schattingen)
# residuals = TRUE sinds 30-9-2026. Stond op FALSE, en dan tekende deze figuur
# GEEN errors terwijl de eerste tekening er twaalf had -- twee plaatjes van
# hetzelfde model dat er anders uitziet, zonder dat er iets veranderd was.
#
# DoNotPlot + kale_errors(): met what = "std" zet semPaths op elke pijl zijn
# schatting, en op een errorpijl is dat de residuvariantie. Die getallen landen
# precies waar de letter E moet staan, en ze horen niet bij wat deze figuur
# vertelt. kale_errors() haalt ze eraf en maakt de errors zwart, zodat ze er
# hier hetzelfde uitzien als in de eerste tekening.
#
# mar en fig-height: dezelfde maat als de eerste tekening, om dezelfde reden
# (losse vakjes). De dubbele pijl van .24 blijft zo in zicht: bij sizeLat 11
# viel de 4 al achter het rondje van alertheid, gemeten 30-9-2026.
q_model_2 <- semPaths(fit_2,
         what             = "std",
         layout           = "tree",
         rotation         = 2,
         sizeMan          = 5,
         sizeLat          = 9,     # groter verbergt de buitenste dubbele pijl (.24) achter de ovalen
         nCharNodes       = 0,
         edge.label.cex   = 0.9,
         residuals        = TRUE,
         intercepts       = FALSE,
         title            = FALSE,
         style            = "lisrel",
         label.scale.equal = TRUE,
         mar              = c(1, 8, 1, 8),
         DoNotPlot        = TRUE)
q_model_2 <- kale_errors(q_model_2)
plot(q_model_2)
errorletters(q_model_2, items)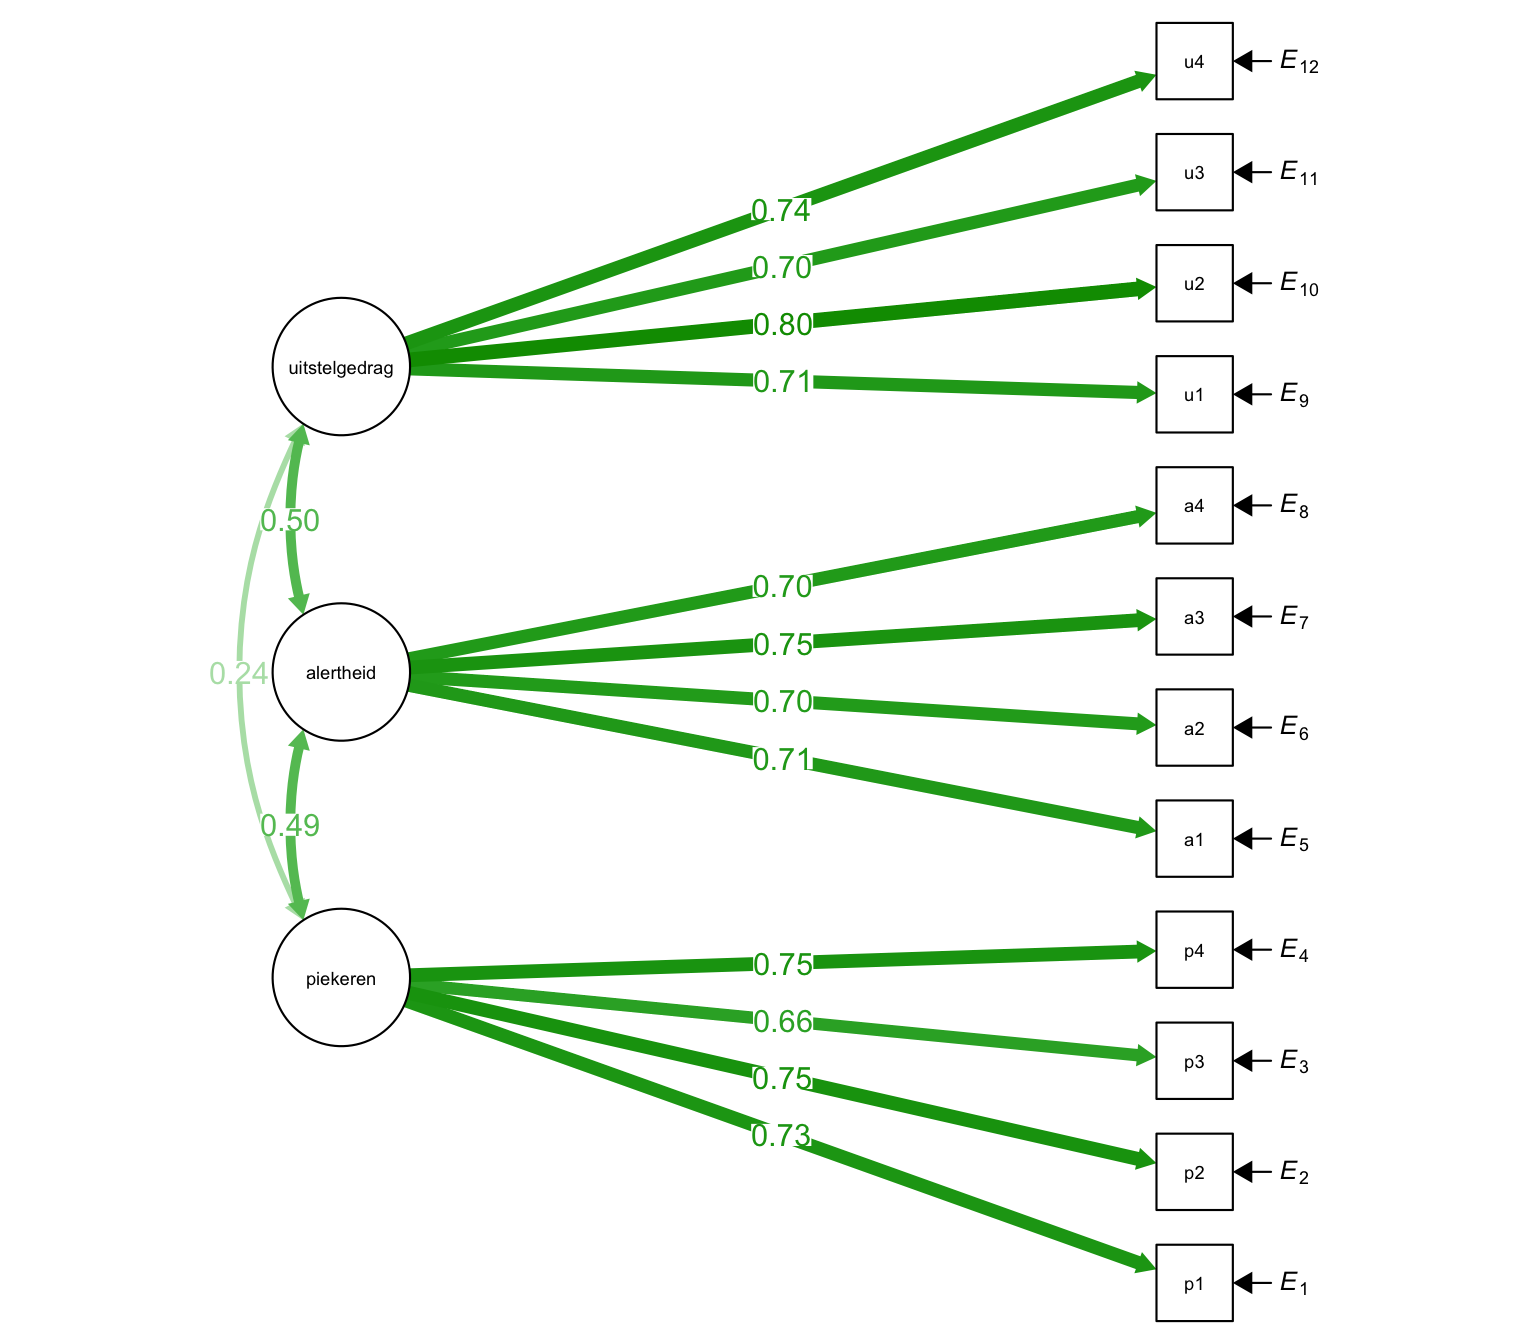
Is die pijl echt? De toets op één lading
Wat zou zeggen over de relatie tussen piekeren en p1? Hetzelfde als altijd: geen relatie. Het regressiegewicht is nul.
Stel dat waar is en je neemt een steekproef. Dan vind je niet precies nul, maar iets in de buurt — en hoe het varieert bij herhaling, dat zegt de standaardfout. Hier is die (de kolom se in de gestandaardiseerde oplossing hierboven). Wij hebben één steekproef genomen en vonden . Hoe ver is dat van nul, in standaardfouten? “Hoe vaak past die standaard error erin?” Dat is de -waarde: ; lavaan rekent met de ongeronde getallen en zegt . Grofweg twee keer erin is al significant; dit is 17 keer. p < .001, dus verwerpen: piekeren heeft een echte relatie met p1.
Toon code (de klokcurve)
x  <- seq(-5 * t_se, t_a + 0.05, length.out = 600)
kc <- data.frame(x = x, y = dnorm(x, 0, t_se))
ggplot(kc, aes(x, y)) +
  geom_area(fill = "#cfe3f0") +
  geom_line() +
  geom_vline(xintercept = t_a, colour = "firebrick", linewidth = 0.8) +
  annotate("text", x = t_a, y = max(kc$y) * 0.6, hjust = 1.1, colour = "firebrick",
           label = sprintf("gevonden: a = %s", fmt_r(t_a))) +
  annotate("segment", x = 0, xend = t_se, y = max(kc$y) * 0.3, yend = max(kc$y) * 0.3,
           arrow = arrow(length = unit(0.15, "cm"), ends = "both")) +
  annotate("text", x = t_se / 2, y = max(kc$y) * 0.36, label = sprintf("SE = %s", se3(t_se)), size = 3.2) +
  labs(x = "lading van p1 op piekeren, als H0 waar is", y = NULL) +
  theme_minimal(base_size = 11) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank())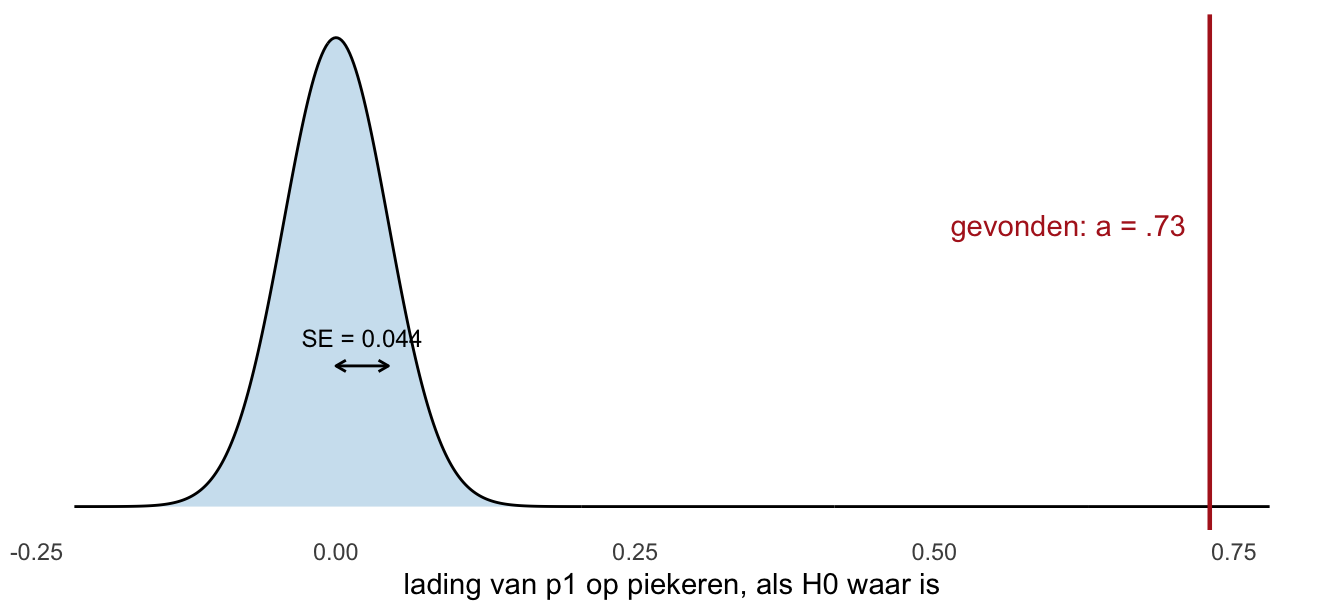
Dat is dezelfde tekening als bij een regressiehelling — een klokcurve rond nul, de standaardfout als stapje, en je eigen ergens in de staart. Die tekening is voor allebei precies dezelfde, en dat is de bedoeling: een lading is een regressiegewicht moet je niet geloven maar zien.
De ladingen lopen hier van (p3) tot (u2), en ze zijn allemaal significant. Voor de ondergrens geldt dezelfde vuistregel als in thema 4: vanaf telt een item mee bij zijn factor. Een streep voor hoog trekt dit oefenboek niet. Kwadrateer een lading en je hebt het deel van de variantie in dat item dat de factor verklaart — de van dat item, net als bij regressie. Wat overblijft is de residuvariantie uit de uitvoer; samen zijn ze .
Speel zelf lavaan: waar vandaan komt
Loop met je vinger langs de pijlen in de figuur met de schattingen erop, en vermenigvuldig wat je tegenkomt. Van p1 naar piekeren staat , van piekeren naar p2 staat . Vermenigvuldig die twee — schatten mag, keer is genoeg. En dan een langere route: van p1 naar piekeren (), over de dubbele pijl naar alertheid ( — die samenhang tussen twee factoren heet φ, phi), en dan naar a1 (). Drie getallen, vermenigvuldigen.
Dat eerste product is — met de ongeronde ladingen; met en kom je op , en dat is precies goed genoeg. Dat is de teruggeschatte correlatie tussen p1 en p2. Twee items op dezelfde factor: hun voorspelde correlatie is het product van hun ladingen. Het tweede product is , en dat is de teruggeschatte correlatie tussen p1 en a1: twee items op verschillende factoren delen alleen wat via de dubbele pijl loopt, dus lading keer φ keer lading. Vergelijk met wat lavaan teruggeeft:
r_hat <- cov2cor(fitted(fit_2)$cov)
round(r_hat[c("p1", "p2", "a1"), c("p1", "p2", "a1")], 3)
p1 p2 a1
p1 1.000 0.549 0.253
p2 0.549 1.000 0.261
a1 0.253 0.261 1.000Dit is de hele machinerie achter de residuen. De teruggeschatte matrix is niets geheimzinnigs: elke cel is een paar ladingen met elkaar vermenigvuldigd, langs de pijlen van jouw tekening. In model 1 stond tussen de factoren geen pijl, dus daar kwam er tussen de blokken nul uit — en daarom waren die residuen zo groot.
Waar wringt het nog? Het grootste residu
stap 5 · herspecificatie
De das fronst
Zoek in deze matrix het getal dat het verst van nul ligt. Positief of negatief, maakt niet uit. Doe het systematisch — alle kolommen af, of alle rijen — want wie zomaar wat rondkijkt, mist er een.
round(residuals(fit_2, type = "cor")$cov, 2) p1 p2 p3 p4 a1 a2 a3 a4 u1 u2 u3 u4
p1 0.00
p2 0.00 0.00
p3 0.01 0.00 0.00
p4 0.00 0.00 -0.01 0.00
a1 0.00 0.01 0.00 0.00 0.00
a2 -0.13 -0.09 -0.05 -0.03 0.03 0.00
a3 0.08 0.00 0.00 0.02 -0.03 0.01 0.00
a4 0.00 0.05 0.04 0.08 0.02 -0.02 -0.01 0.00
u1 -0.02 -0.05 0.00 -0.01 0.01 0.05 0.05 0.04 0.00
u2 0.03 -0.03 -0.01 0.06 -0.01 0.04 0.08 -0.03 -0.02 0.00
u3 -0.03 -0.05 -0.02 0.05 -0.06 -0.03 -0.06 -0.08 0.00 0.01 0.00
u4 -0.03 -0.02 0.01 0.07 -0.03 -0.02 0.01 -0.03 0.01 0.00 0.01 0.00Gevonden? Het is a2 met p1: . En het is het enige residu dat buiten de band van valt; alle andere blijven erbinnen, en er zijn er 30 positief tegen 36 negatief.
Die laatste telling hoort bij een vraag die je vaker ziet: zijn de residuen ongeveer normaal verdeeld? Rol de matrix uit tot één rij getallen en maak er een histogram van:
hist(lav_matrix_vech(residuals(fit_2, type = "cor")$cov),
     breaks = seq(-0.15, 0.15, by = 0.02) + 0.01,    # nul midden in een staaf
     xlab = "residu op correlatieschaal", ylab = "aantal cellen", main = "")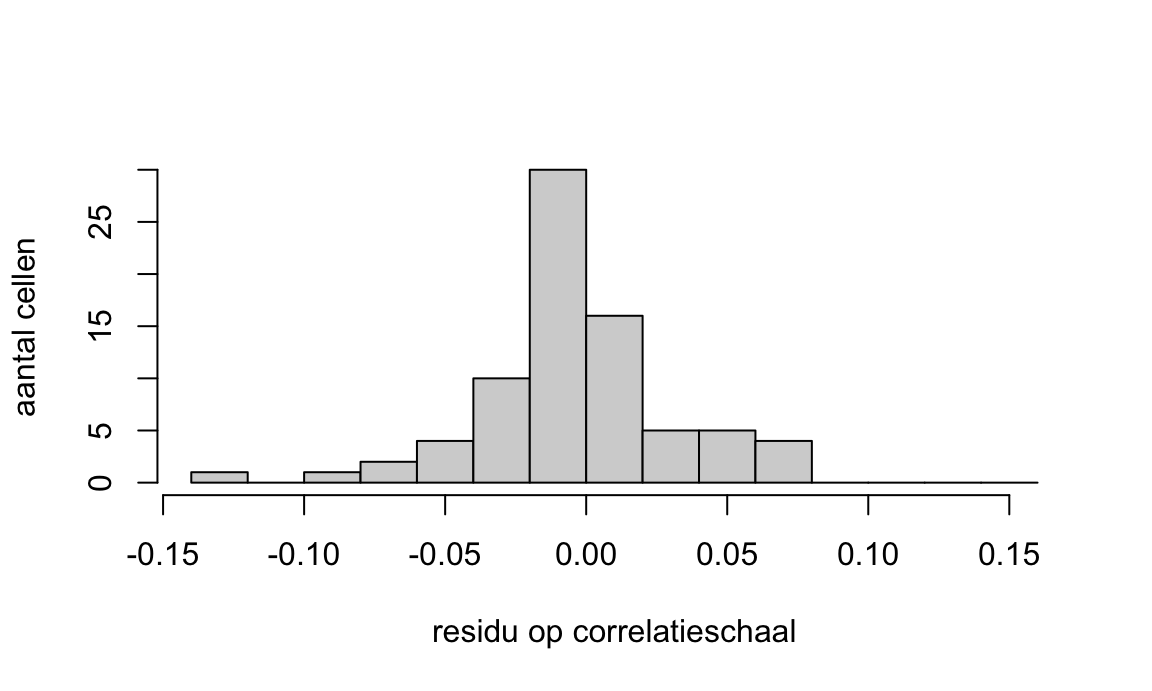
Is dit normaal verdeeld? “Op het moment dat jij New York ziet, dan zeg je nee. Alleen als jij ziet zo’n mooie klokkurve, dan zeg je ja. Maar je ziet nooit zo’n mooie klokkurve.” Wat je wél kunt zeggen: bijna alles ligt tussen en , en plus en min houden elkaar aardig in evenwicht — 30 tegen 36. Dat is wat een redelijk passend model in zijn residuen laat zien. (Let op dat lav_matrix_vech() de diagonaal meeneemt: 12 van de 78 waarden in dit histogram zijn de nullen van elk item met zichzelf, en die zitten allemaal in de staaf rond nul — daarom is die zo hoog.)
Verzin nu twee getallen die dit verschil geven. Een waargenomen correlatie en een teruggeschatte, zó dat waargenomen min teruggeschat op uitkomt. Welke van de twee moet de grootste zijn?
Verzonnen: . Klopt qua som, en je ziet meteen wie er groot was: de teruggeschatte. Nu de echte, allebei op te zoeken — de eerste in de correlatiematrix van de weddenschap, de tweede in fitted(fit_2):
“Heeft het model de werkelijke correlatie overschat of onderschat?” Het model zei , in het echt is het maar . Het model zat te hoog: overschat. Wie de eik van vijftig op tweeënvijftig schat, overschat ook.
En je weet nu waar dat vandaan komt: , langs de dubbele pijl tussen alertheid en piekeren. Die pijl zegt: alle alertheiditems hangen via de factor met alle piekeritems samen, en wel ongeveer even sterk. Maar a2 doet dat minder dan de rest — kijk naar zijn hele rij tegen de piekeritems: , , , . Allemaal negatief. Dat is geen losse cel, dat is een rij.
Twee reparaties, en de das doet ze geen van beide
Er zijn er twee, in twee kleuren. Geel: een extra pijl — hier zou dat a2 óók op piekeren laten laden. Groen: de errors van a2 en p1 mogen samenhangen, zonder dat je zegt waarom. “Of zullen we allebei, dat weet ik eigenlijk niet. Maakt ook niet uit.” In lavaan is elk van de twee één regel:
# geel -- een kruislading: het item laadt op een tweede factor
model_2_kruis <- '
  piekeren      =~ p1 + p2 + p3 + p4 + a2
  alertheid     =~ a1 + a2 + a3 + a4
  uitstelgedrag =~ u1 + u2 + u3 + u4
'
# groen -- samenhangende errors: één regel erbij, verder niets
model_2_err <- '
  piekeren      =~ p1 + p2 + p3 + p4
  alertheid     =~ a1 + a2 + a3 + a4
  uitstelgedrag =~ u1 + u2 + u3 + u4
  a2 ~~ p1
'
Allebei kosten ze één vrijheidsgraad, en allebei zijn ze genest in model 2 — er komt alleen een pijl bij. De kruislading haalt de omlaag met (p = .012), de errorsamenhang met (p = .014). Significant, allebei. De kruislading die eruit komt is : negatief, zoals de rij al zei.
En nu snauwt de das, en hij heeft gelijk.
Oefeningen
Pen-en-papier eerst, dan R
T1 — CFA, EFA, PCA of regressie?
T2 — Tellen op een tekening
T3 — De maten zijn het oneens
T4 — Een residu lezen
T5 — Genest of niet?
OpmerkingVraag T5 — Pen-en-papier
Drie tekeningen op de items van de das — A, B en C, los van de nummering in het hoofdstuk.
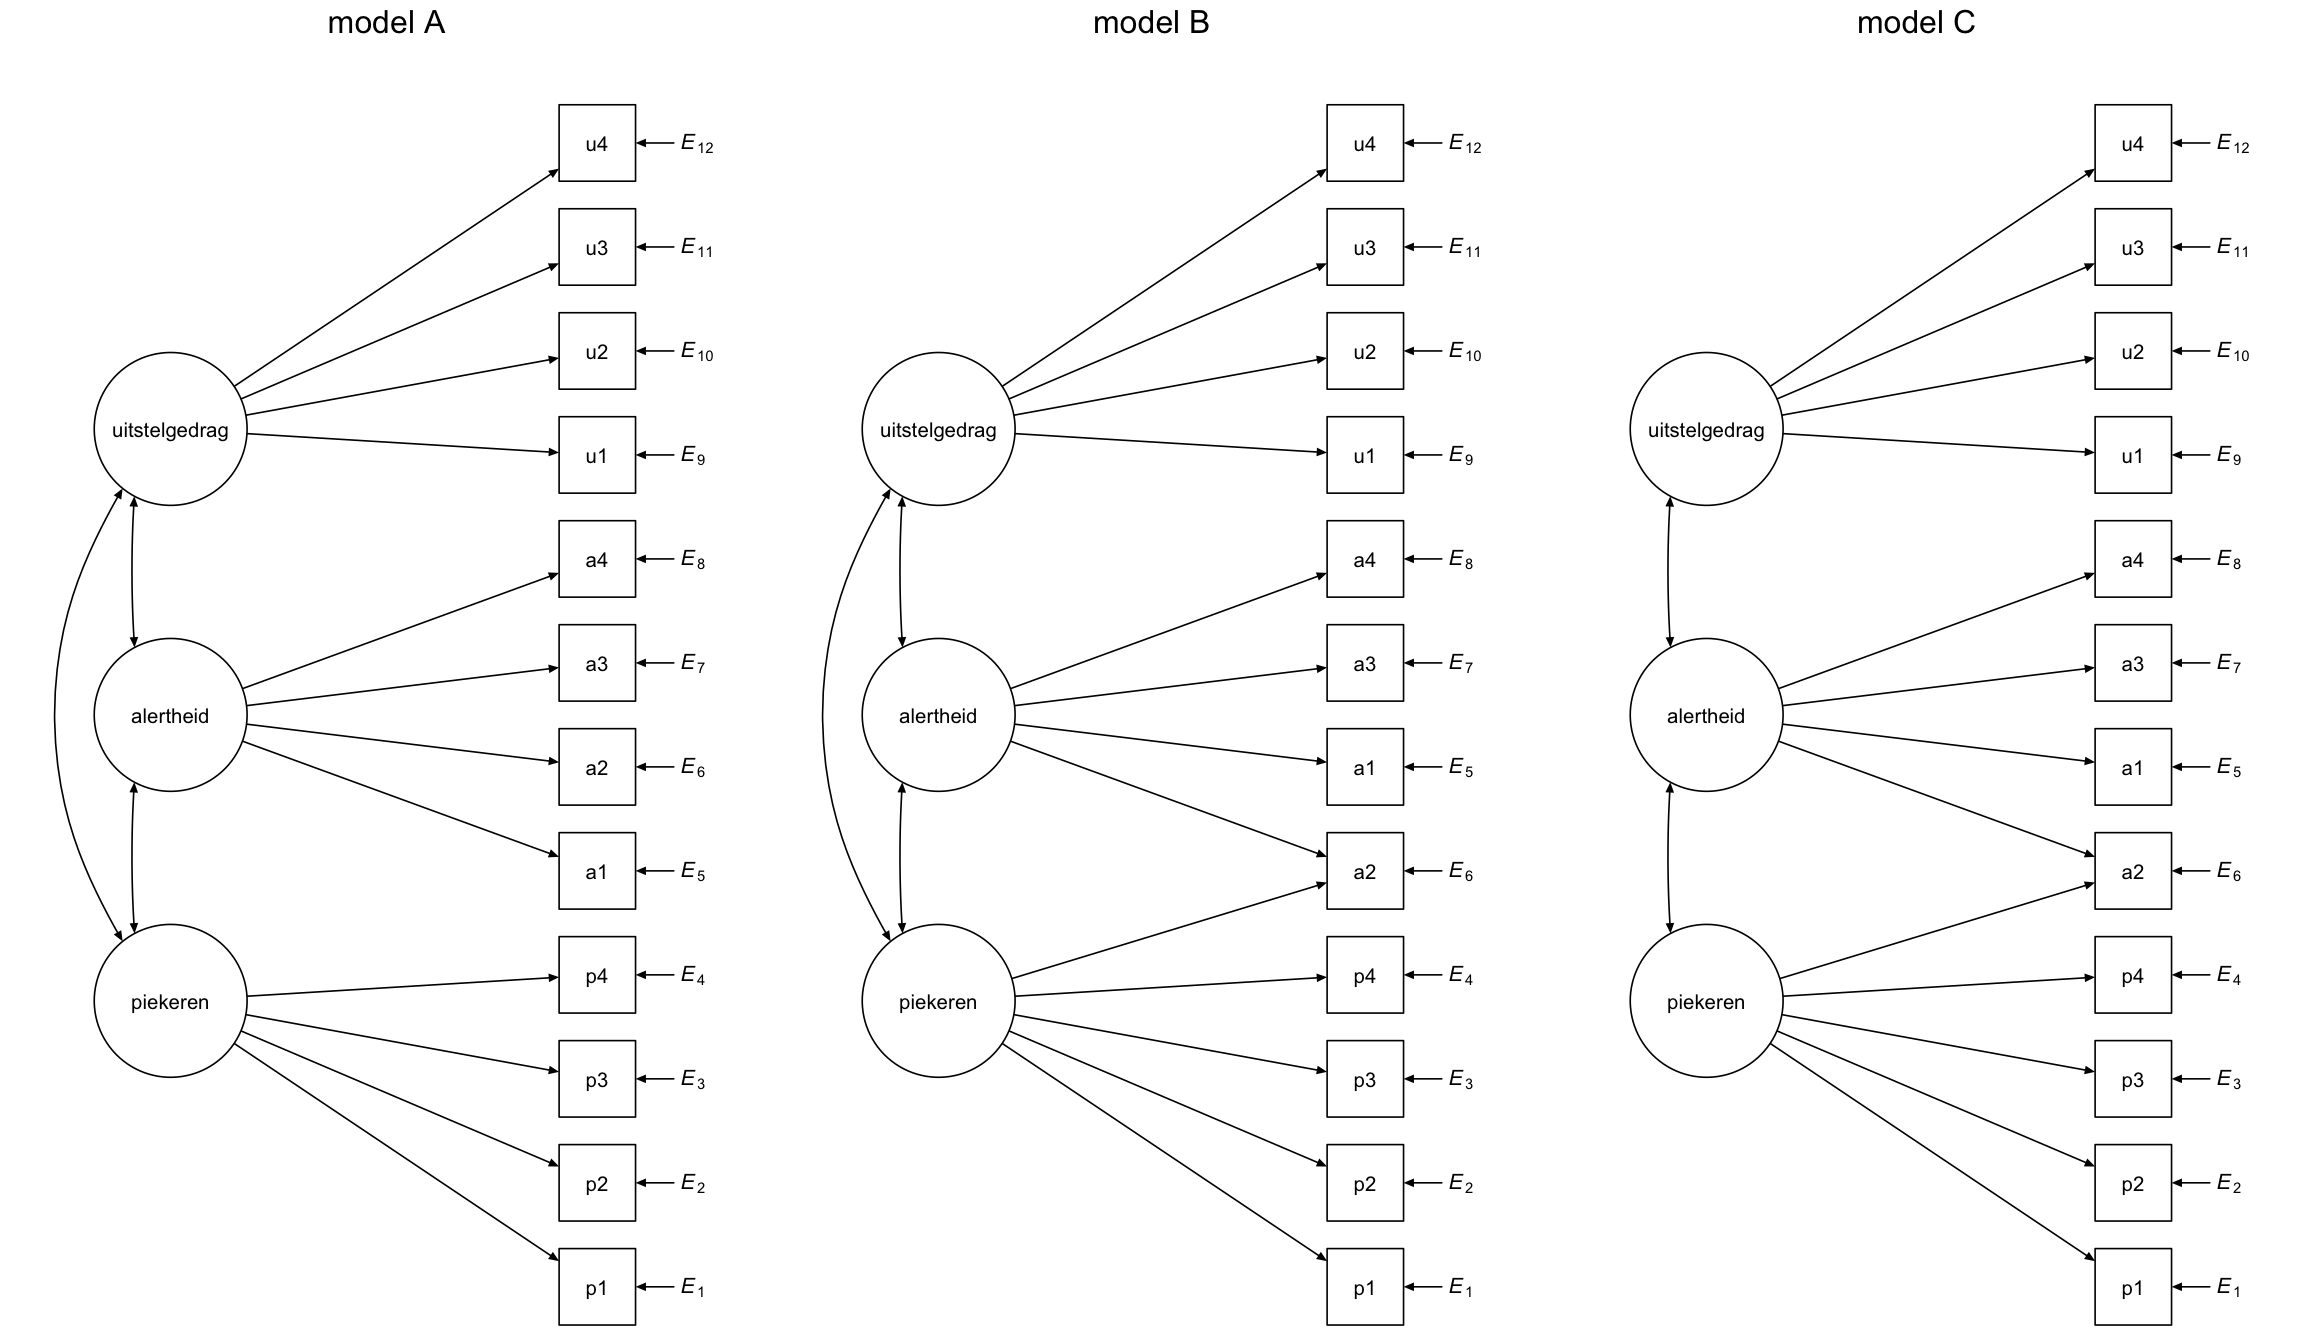
a2 staat in B en C op een andere plek dan in A, omdat hij daar aan twee factoren hangt; dat is de pijl erbij. Zijn errornummer verhuist niet mee — a2 is item 6 en houdt in alle drie de panelen.
a) Zijn A en B genest?
b) Zijn A en C genest?
c) Zijn B en C genest?
d) Voor welke paren mag je gebruiken?
T6 — Van df terug naar de tekening
E1 — De toets en de drie maten lezen
E2 — Ladingen
E3 — Modelvergelijking
E4 — Wat vorige week anders was
E5 — Mini-CFA bij de das
E6 — De fitmeter: dezelfde tekening, meer dieren
R-spiekblad — CFA van begin tot eind
# 1. Pakketten en data ---------------------------------------------------
library(tidyverse)
library(lavaan)
library(semPlot)
load("data/bos_dieren_dimensies.RData")

# 2. Het model tekenen in tekst ------------------------------------------
model <- '
  piekeren      =~ p1 + p2 + p3 + p4      # =~  : is gemeten door
  alertheid     =~ a1 + a2 + a3 + a4
  uitstelgedrag =~ u1 + u2 + u3 + u4
  piekeren      ~~ 0*alertheid            # ~~ 0* : deze samenhang staat op nul
'                                         # (laat weg wat mag samenhangen)

# 3. Fitten, met de factoren op variantie 1 -------------------------------
fit <- cfa(model, data = bos_dieren_dimensies, std.lv = TRUE)

# 4. Toets en maten ------------------------------------------------------
fitMeasures(fit, c("npar", "chisq", "df", "pvalue", "nfi", "cfi", "rmsea"))
summary(fit, fit.measures = TRUE, standardized = TRUE)   # lees Std.all

# 5. Waar wringt het? ----------------------------------------------------
residuals(fit, type = "cor")$cov        # residuen op correlatieschaal
fitted(fit)$cov                          # de teruggeschatte matrix zelf

# 6. Tekenen -------------------------------------------------------------
# style = "lisrel" tekent de error als een kale E met één rechte pijl;
# laat je hem weg, dan krijg je een dubbele zelflus aan elk vierkantje.
semPaths(fit, what = "std", layout = "tree", rotation = 2, style = "lisrel")

# 7. Twee geneste modellen vergelijken ------------------------------------
anova(fit_klein, fit_groot)
pchisq(chi_klein - chi_groot, df_klein - df_groot, lower.tail = FALSE)
Wat blijft liggen
- Modificatie-indices — de andere route naar waar past het niet, waar dit oefenboek niet mee rekent. Wat hij is en waarom dat zo is, staat in het dichtgeklapte kader bij het grootste residu. Wat hier blijft liggen is het gebruik ervan in onderzoek waar je hem wél tegenkomt: hoe je een aanpassing die uit zo’n lijst komt netjes rapporteert.
- Measurement invariance — hetzelfde model in meerdere groepen, en toetsen of het overal hetzelfde werkt.
- SEM — meetmodel plus structureel model: pijlen tussen factoren, en dan mag je voorspellen in plaats van correleren.
- Item Response Theory — thema 6.
Voor verdieping: Brown (2015, Confirmatory Factor Analysis for Applied Research); Kline (2016, Principles and Practice of Structural Equation Modeling).
Aan het eind van de dag
De das zat met zijn rug tegen de stam en keek naar zijn tekening. Er stonden drie pijlen op die er vanochtend niet stonden.
“Je had ongelijk,” zei de bunzing.
“Op één punt.” De das gromde. “Ik dacht dat ze los van elkaar stonden. De residuen zeiden van niet, drie blokken lang. Dus die heb ik erbij getekend, en nu past het.”
“En dat ene vakje, dat rode?”
“Dat laat ik staan.” Hij tikte erop. “Ik weet niet waarom a2 bij piekeraars lager uitvalt. Ik zou een pijl kunnen tekenen en dan wordt het mooier. Maar dan teken ik wat de data zeggen, niet wat ik weet.”
De rat, op zijn tak: “Vorige week vond ik dezelfde drie.”
“Jij vond ze. Ik heb ze getoetst.” De das keek omhoog. “En morgen komt de uil. Die kijkt niet naar twaalf items tegelijk, die kijkt naar één item per keer: hoe moeilijk het is, en hoe scherp het onderscheidt.”
De bunzing knikte en kroop weg. Boven het bos werd het donker, en de das liet de tekening liggen zoals hij was.
Verantwoording
Dit oefenboek is geschreven voor studenten die psychometrie leren via R. Het is materiaal van CountCamp, geen officieel onderdeel van een opleiding. De voorbeelden, datasets, vragen en formuleringen zijn origineel; de didactische volgorde is dat bewust niet — die volgt de gangbare opbouw van Nederlandse universitaire psychometrie-cursussen: eerst tekenen, dan tellen, dan pas rekenen. Ook de uitleg over snoeien en fit verbeteren, de drie patronen in de residuen en de waarschuwing dat de data een model wel kunnen weerleggen maar nooit bevestigen, volgen bestaand lesmateriaal. Dat geldt ook voor de keuze om met gestandaardiseerde residuen te werken in plaats van met modificatie-indices, al kiezen veel handboeken daar juist de modificatie-index.
Waar dit thema een eigen weg gaat. De data zijn van ons — dezelfde bosdieren als in thema 4, met opzet, zodat de ladingen van vorige week naast die van deze week kunnen liggen. De fit-maten zijn NFI, CFI en RMSEA — drie en niet vier — elk met drie banden in plaats van één grens. Waar de RMSEA-banden geen etiket geven, tussen en , zegt dit hoofdstuk dat erbij in plaats van een grens te verzinnen. Veel handboeken trekken per maat één streep, en de literatuur legt de lat nog weer anders; dat staat er waar het hoort.
De ladingen heten hier en niet of λ: λ is in dit oefenboek al de eigenwaarde uit thema 4, en houdt de ladingen van thema 4 en thema 5 op dezelfde letter zodat je ze naast elkaar kunt leggen. De andere twee letters staan er één keer naast, in het kader over de drie letters. En het woord stap betekent in dit hoofdstuk maar één ding: een van de vijf stappen van de CFA-cyclus, die meteen aan het begin getekend staan. De stukken waarin dit hoofdstuk de stof loopt dragen geen eigen nummer; ze heten naar wat je er doet — tekenen, voorspellen, tellen — en onder elke kop staat de stap waar dat onder valt. Ze staan in de volgorde waarin het went en niet in die van de cyclus, en daarom springt die labelregel. Tot eind september 2026 droegen die stukken zelf ook een nummer, en dan betekende stap 2 twee verschillende dingen.
Zegt ander materiaal dat je gebruikt iets anders dan dit oefenboek, reken dan met wat daar staat. Meestal is het verschil een afspraak — een drempel, een letter, de naam van een model — en geen rekenfout.
Versie: oktober 2026 — CountCamp Lab