Van één egel naar een hele steekproef
Tot nu toe keken we naar de score van één egel. Nu nemen we een hele steekproef — zeg 25 egels — en kijken naar hun gemiddelde. Want in de praktijk zien we de populatie nooit; we hebben alleen een steekproef, en daarmee willen we iets zeggen over alle egels. Dit is de stap naar inferentie: van steekproef naar populatie.
De pienterheid is normaal verdeeld met en (thema 4). We trekken steekproeven van egels en kijken naar het steekproefgemiddelde .
Drie verdelingen — niet door elkaar halen
Dit is hét struikelpunt van het hele vak, dus we maken het scherp. Er zijn drie verdelingen:
- Populatieverdeling — de pienterheid van alle egels, met als centrum (een parameter: één vast getal, meestal onbekend — de p–p uit thema 1, populatie → parameter). .
- Steekproefverdeling (let op de enkelvoudige -proef-) — de verdeling binnen één steekproef: de 25 losse -scores in één steekproef, met als centrum het steekproefgemiddelde van díe steekproef (een statistiek: de st–st uit thema 1, steekproef → statistiek — en hij valt per steekproef anders uit). Een klein, hobbelig wolkje. (Eén letter verschil met nummer 3 hieronder, en het verschil tussen “deze 25 egels” en “alle denkbare steekproeven van 25 egels”. Lees dat woord dus altijd twee keer.)
- Steekproevenverdeling — de verdeling van het stéékproefgemiddelde over heel veel steekproeven. Op het bordje staat geen , maar .
Die derde is de nieuwe, en de belangrijkste. Voel het verschil tussen de twee centra: is één vast getal (al kennen we het meestal niet), terwijl per steekproef opnieuw uitvalt — en juist omdat varieert, krijgt hij zélf een verdeling. Dat is precies nummer 3.
De bordjes — het spelletje, opnieuw
Herinner je het spelletje uit thema 1 (er komt iets binnen, wat is je beste gok?). Nu schalen we het op:
Jullie nemen állemaal een steekproef van 25 egels, rekenen het gemiddelde uit, schrijven dat op een bordje, en hangen het op. Ik kom langs en gok wat erop staat. Mijn beste gok: 100 (het populatiegemiddelde). Maar het ene bordje zegt 103, het andere 97 — ze wijken af.
Vroeger (thema 1) vroegen we: hoeveel mist één egel het gemiddelde? Nu vragen we: hoeveel mist één bordje (één steekproefgemiddelde) het echte gemiddelde? Die afwijking van een bordje is weer een gokfout. En de gemiddelde gokfout van een bordje is de standaardafwijking van het steekproefgemiddelde — die noemen we de standaardfout, .
Eén egel wijkt af met . Eén bórdje (een steekproefgemiddelde) wijkt af met — en dat is kleiner, want een gemiddelde “middelt de uitschieters weg”. Het is nog steeds gewoon een standaardafwijking (de gemiddelde gokfout) — alleen van een ander soort gebeurtenis: niet een individu, maar een steekproefuitkomst.
De standaardfout
(Herinner je uit thema 3: een variantie schaalt met het kwadraat van een factor. Een gemiddelde is een gewogen optelling; daar valt de uit — dáárom .) Speel met en je ziet de theorie:
Hoe groter de steekproef, hoe dichter de bordjes bij elkaar liggen — hoe preciezer je schatting.
Het bijzondere (en eigenlijk flauwe): als je steekproef groot genoeg is (vuistregel ), dan is de steekproevenverdeling bij benadering normaal — hoe lelijk of scheef de populatie ook is. Daarom mogen we voor gewoon de z-tabel pakken. Let op het woordje bij benadering: bij een lelijke, scheve populatie is de steekproevenverdeling niet magisch perfect normaal, maar bij genoeg egels vaak dichtbij genoeg om ermee te rekenen.
Het betrouwbaarheidsinterval
Stel: je trekt 25 egels en meet hun pienterheid. Het gemiddelde is . Dat is je enige echte steekproef: de enige die je ooit krijgt.
Die 106 is je puntschatting van . Maar één getal is te stellig — we geven een range eromheen waarvan we redelijk zeker zijn dat de ware erin ligt:
Voor 95% zekerheid is (de heilige z-waarde). Leiden noemt ook de kritische z-waarde, en de kritische t-waarde (die komt in thema 9). Dus:
Dat stuk dat je naar links én rechts gaat, , heet de foutenmarge (de halve breedte).
Op het formuleblad bij het tentamen staat deze formule zonder subscripts:
x̄ ± z * σ/√n
Drie vertalingen:
- σ is onze : hoe ver losse egels van elkaar liggen.
- σ/√n is onze : de standaardfout, het lineaaltje.
z * is , z-ster: de grens die je opzoekt. Het sterretje hoort bij de z; het is geen keer-teken. Tussen en σ/√n moet je wél vermenigvuldigen — alleen staat dat keer-teken er niet.
Met onze getallen: .
De -waarden uit je hoofd: 90% → 1,645; 95% → 1,96; 99% → 2,576.
Bij 99% geven tabel A en tabel D je een iets ander getal. Dat is geen fout van jou, en het verschil is klein. (Tabel D is de t-tabel op je formuleblad. Die heb je pas in thema 9 echt nodig, maar de onderste rij, , kun je nu al gebruiken.)
Hoe kom je in tabel A aan twee antwoorden? In stapjes:
99% in het midden laat 0,5% over in elke staart. Onder de rechtergrens ligt dus 99,5%: je zoekt de kans .
Die kans staat niet in tabel A. Zijn twee buren wel:
| 2,57 |
|
| 2,58 |
|
Jouw valt precies in het gat ertussen. Tabel A kan dus niet kiezen: 2,57 of 2,58.
Tabel D heeft een decimaal meer en geeft in de rij : 2,576.
Wij rekenen met 2,576.
Hoeveel scheelt het? Met ons lineaaltje van 3 geeft 2,57 een foutenmarge van 7,71, 2,58 geeft 7,74 en 2,576 geeft 7,73. Het verschil zit pas in de tweede decimaal.
Een betrouwbaarheidsinterval is gewoon de richtings-engine uit thema 4, maar nu met de standaardfout als lineaaltje. Je krijgt een kans (het CI-niveau) en zoekt een gebeurtenis (de grenzen): dus . Het fietsje vertrekt nu vanuit , met snelheid , en je wandelt lineaaltjes naar links en naar rechts.
De gewone lezing — ik noem hem de gezellige — is: met 95% zekerheid ligt het populatiegemiddelde tussen 100,12 en 111,88. Zo zeg je het, en zo vraagt Leiden het ook. Op het tentamen is dit het goede antwoord.
Let op over wie die zin gaat: over het gemiddelde van álle egels. Niet over losse egels, en niet over de 25 egels in je steekproef.
Daaronder ligt een strengere lezing, als achtergrond: neem je 100 keer een steekproef en bereken je telkens een 95%-interval, dan bevatten 95 van die 100 intervallen de ware . (Als een hoefijzer dat je 100 keer naar de paal gooit en 95 keer raak.) Dat hoefijzer is geen reden om de gewone lezing af te keuren. Staat de gewone lezing tussen de antwoorden, dan kies je de gewone lezing.
Data om mee te spelen: egels_pienterheid.sav — of de hele zip. Hier rekenen we het interval met de hand, maar SPSS geeft ’m ook — verstopt in de t-toets. Klik:
Analyze → Compare Means → One-Sample T Test → de variabele naar rechts → bij Options… het Confidence Interval Percentage op 95 (of wat je wilt) → OK.
Het CI lees je af in de tabel One-Sample Test, onder 95% Confidence Interval of the Difference — let op: dat is het interval rond het verschil met de testwaarde, dus tel die testwaarde er weer bij op.
Foutenmarge en steekproefgrootte
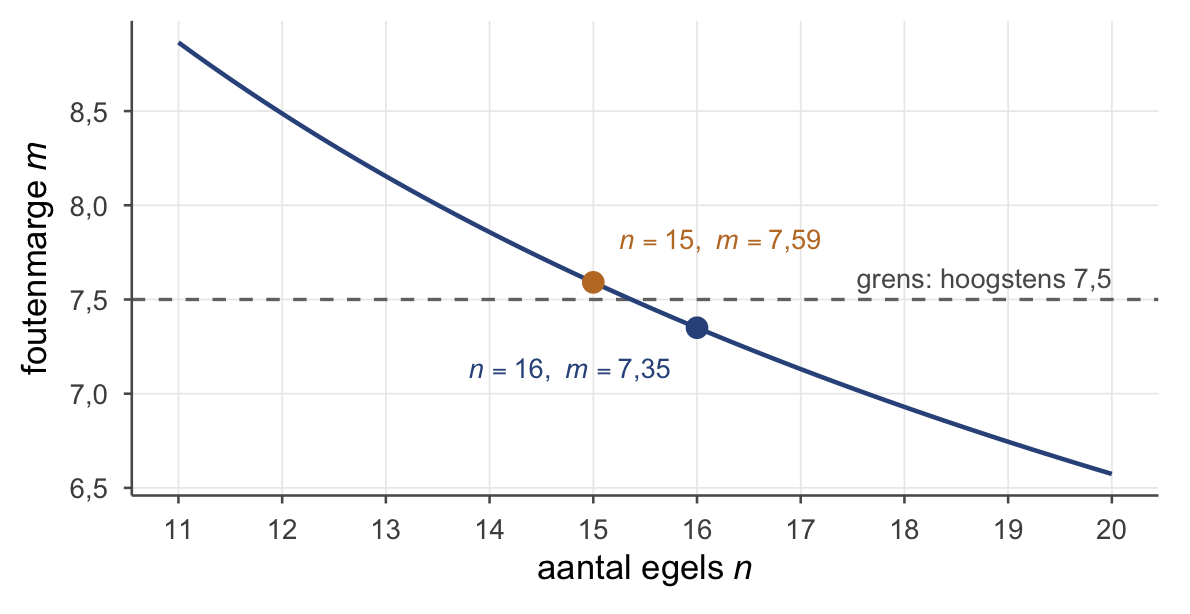
De foutenmarge hangt af van : meer egels → kleinere . Andersom kun je vooraf uitrekenen hoeveel egels je nodig hebt voor een gewenste precisie. Stel: je wilt de pienterheid schatten met een foutenmarge van hoogstens 7,5 punt, bij 95% (). Hoeveel egels heb je minstens nodig? (Let op dat woordje hoogstens — of maximaal. Daar hangt de hele afronding aan.)
Je gebruikt dezelfde formule als hierboven, , alleen omgedraaid: nu is gegeven en zoek je .
n = (z * σ / m)²
Dezelfde vertaling als bij het interval: σ is , en z * is — het sterretje hoort bij de z. Tussen en σ vermenigvuldig je wél; dat keer-teken staat er alleen niet. De kleine m is de foutenmarge die je hoogstens wilt.
Met onze getallen: .
En nu komt de val.
15,37 egels. Je hand wil 15 opschrijven, want ,37 is minder dan ,5. Dat is de gewone afrondregel — en die geldt hier niet. Een steekproefgrootte rond je altijd naar boven af, ook als er ,01 achter de komma staat. Dus: 16 egels.
Waarom? Reken de foutenmarge uit met allebei de kandidaten, :
| 15 (naar beneden) |
7,59 |
nee — breder dan je had toegestaan |
| 16 (naar boven) |
7,35 |
ja |
Rond ik naar beneden af, dan krijg ik een kleinere steekproef, en een kleinere steekproef geeft een grotere foutenmarge — en dat mag niet. Zie 15,37 als een streep: precies daar is de marge 7,5. Elk heel aantal egels vóór die streep geeft een te brede marge; 16 is het eerste hele aantal erna.
Oefenen
De pienterheid heeft .
Wat is de standaardfout bij ? En bij ?
Waarom wordt het interval smaller als groter wordt?
(a) ; en .
(b) Een groter middelt de uitschieters sterker weg, dus de bordjes (steekproefgemiddelden) liggen dichter bij elkaar → kleinere → kleinere foutenmarge → smaller interval. Meer informatie, preciezere schatting.
Een steekproef van egels geeft (). Bouw het 95%-betrouwbaarheidsinterval voor . Ligt 100 erin?
. Foutenmarge . Interval: . Wandel je van links naar rechts, dan kom je 100 tegen — dus ja, 100 ligt erin. (In thema 8 zie je: dat betekent dat we bij een toets H₀: niet zouden verwerpen.)
Data: egels_pienterheid_n9.sav — 9 egels, kolom pienterheid met en (exact).
Analyze → Descriptive Statistics → Explore → zet pienterheid bij Dependent List → OK. (Of via Compare Means → One-Sample T Test, Test Value 100.)
Aflezen: SPSS geeft Mean = 108,00, en daaronder het 95% Confidence Interval for Mean. Let op — dit wijkt bewust af van je handwerk: wij rekenden met bekend (dus de -waarde 1,96 → interval ), maar SPSS kent nooit en schat ’m met — dus gebruikt het de t-verdeling (), wat een iets breder interval geeft (). Precies het verschil dat in thema 9 centraal staat: als je kent, als je ’m schat. In beide gevallen ligt 100 erin.
Een collega heeft genoeg aan wat losser en wil geen 95%- maar een 80%-betrouwbaarheidsinterval rond de gemiddelde pienterheid van egels. Wat is de kritische z-waarde (oftewel ) voor dat 80%-betrouwbaarheidsinterval?
- in het midden → wat overblijft voor de twee staarten samen:
- Per staart de helft:
- Bij 10% in één staart hoort
- Antwoord: — kleiner dan de 1,96 van 95%, dus een lossere eis geeft een smaller interval.
Het CI-niveau () is niks anders dan: hoeveel kans wil je in het midden, tussen de twee grenzen? De rest verdeel je symmetrisch over de twee staarten. Drie stapjes:
- Wat zit er in het midden? — die wil je tussen de grenzen hebben.
- Wat blijft over voor de staarten? , samen in de twee staarten.
- Symmetrie → per staart de helft: in elke staart. Bij 10% in één staart (dus 90% eronder) hoort .
Dat is precies de -wandeling uit thema 4, alleen lees je ’m nu af als de die je in élk interval stopt. De vaste rij om uit je hoofd te kennen:
| 80% |
10% |
1,28 |
| 90% |
5% |
1,645 |
| 95% |
2,5% |
1,96 |
| 99% |
0,5% |
2,576 |
Val op: hoe zékerder je wilt zijn, hoe verder naar buiten schuift (99% → 2,576) → breder interval. 80% is juist de lósste eis in de rij → de kleinste → het smalste interval. Meer zekerheid koop je met minder precisie, en andersom.
Welke van deze twee beweringen is juist?
Hoe groter de steekproef, hoe kleiner de spreiding van de steekproevenverdeling van het gemiddelde.
Als de steekproef maar groot genoeg is, is élke variabele normaal verdeeld.
Alleen (1) is juist.
Waarom (1) klopt:
- — een grotere staat in de noemer, dus de standaardfout wordt kleiner.
- Kleinere = de bordjes (steekproefgemiddelden) klitten dichter samen. Precies de tabel bij “De standaardfout” (, , ).
Waarom (2) onjuist is:
- De centrale limietstelling maakt de verdeling van het steekproefgemiddelde (bij benadering) normaal — níét de ruwe variabele .
- Een scheve populatie blíjft scheef, hoeveel egels je ook trekt. Wat normaal wordt is de muur van bórdjes, niet de losse egels.
- Dit is de drie-verdelingen-val: bewering (2) verwart verdeling 1 (populatie van ) met verdeling 3 (steekproevenverdeling van ).
Een collega rapporteert standaard een 95%-BI, maar stapt voor een gevoelige uitkomst over op een 99%-BI. Waarom zou zij dat willen? En wat zeg je tegen de collega die roept: “Doe niet, dan wordt je interval juist nauwkeuriger — lekker smal”?
Waarom een 99%-BI:
- Grotere kans dat het interval de ware bevat: 99 van de 100 intervallen raak, tegen 95 van de 100 (het hoefijzer, maar met meer treffers).
- Je wilt zekerder zijn dat je ’m echt te pakken hebt — handig als een misser duur is.
De prijs — en meteen de weerlegging van de afleiders:
- “Smaller/nauwkeuriger”? Fout: juist breder. gaat van 1,96 → 2,576, dus wordt wijder. Nauwkeuriger (smaller) krijg je niet door meer zekerheid te eisen, maar door meer egels ( omhoog → omlaag).
- “Dan is de kans dat erin ligt maar 1%”? Fout: het is 99%, niet 1%. Met 99% zekerheid ligt in het interval — die zin is op het tentamen gewoon goed. (Het hoefijzer is de strenge achtergrond, geen reden om hem af te keuren.)
Je wilt de gemiddelde pienterheid van egels schatten ().
Hoeveel egels heb je minstens nodig voor een foutenmarge van hoogstens 5,25 bij 95%?
En hoeveel voor een foutenmarge van hoogstens 4 bij 99% ()?
Een studiegenoot vindt bij (b) 93,32 en schrijft 93 op: “,32 is onder de ,5, dus naar beneden.” Reken uit welke foutenmarge je krijgt met 93 egels, en welke met jouw antwoord uit (b). Houd twee decimalen aan. Welke van de twee haalt de eis?
(a) → 32 egels. Niet 31: ook bij ,36 rond je naar boven af.
(b) → 94 egels.
(c)
- Met 93 egels: . Dat is meer dan 4 — eis niet gehaald.
- Met 94 egels: . Hoogstens 4 — eis gehaald.
Waarom twee decimalen? Rond je 4,01 af op één decimaal, dan staat er 4,0 en lijkt de eis gehaald. Net erover is erover — maar alleen als je genoeg decimalen aanhoudt om het te zien.
De pienterheid van egels is normaal verdeeld met en .
Hoe groot is de kans dat één willekeurige egel hoger scoort dan 106?
Hoe groot is de kans dat het gemiddelde van 25 egels hoger uitkomt dan 106?
(a) Eén egel wijkt af met , dus dat is je lineaaltje:
. Tabel A geeft bij links ; jij wilt rechts: .
(b) Een bordje wijkt af met de standaardfout: . Op je formuleblad staat de z-formule als z = (x̄ − μ)/(σ/√n):
. Tabel A geeft bij links ; rechts: .
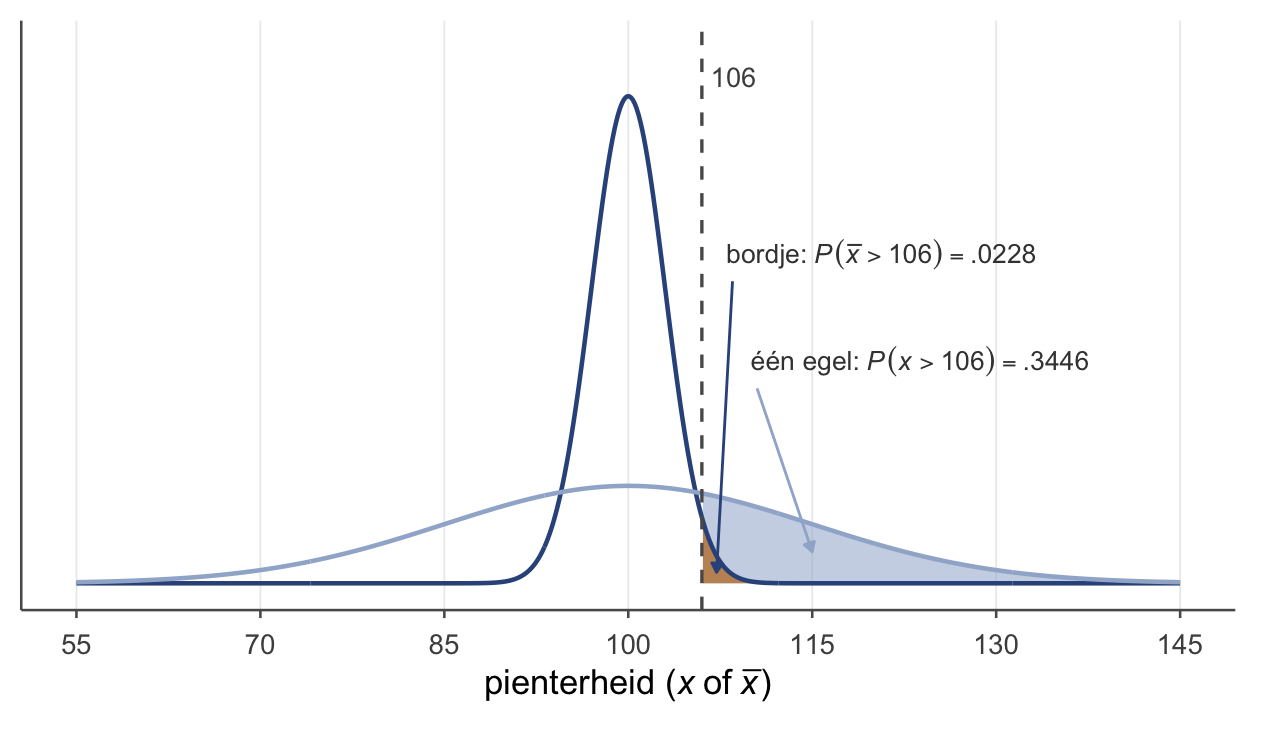
Dezelfde 106, een ander lineaaltje: 5 keer zo kort. Daardoor ligt 106 voor een bordje veel verder weg, en is de kans ongeveer 15 keer zo klein. (Waarom geen 5 keer? Een normaalverdeling wordt naar buiten toe steeds sneller dun: elke stap verder de staart in levert veel minder op dan de vorige.) Eén pientere egel kom je vaak tegen; een heel bordje van 25 pientere egels bijna nooit.
In de figuur hieronder zie je dat zo: bij 106 staat de brede curve nog bijna op zijn top, en de smalle ligt daar al bijna op de grond.
Je steekproef van 25 egels geeft het 95%-betrouwbaarheidsinterval . Welke uitspraak klopt?
95% van alle egels heeft een pienterheid tussen 100,12 en 111,88.
95% van de 25 egels in je steekproef scoort tussen 100,12 en 111,88.
Met 95% zekerheid ligt de gemiddelde pienterheid van alle egels tussen 100,12 en 111,88.
Met 95% zekerheid scoort minstens één egel tussen 100,12 en 111,88.
(c) — het interval gaat over het populatiegemiddelde .
- (a) gaat over losse egels. Die wijken af met , niet met het lineaaltje van 3. 15 is 5 keer 3, dus is de middelste 95% van alle egels 5 keer zo breed als dit interval.
- (b) gaat over je steekproef. Ook binnen die 25 egels liggen de losse scores met ongeveer uit elkaar. Het interval gaat over hun gemiddelde, niet over henzelf.
- (d) gaat over één egel. “Minstens één” zegt niets over het gemiddelde.
- (c) is de gewone lezing uit “Wat betekent ‘95%’ precies?”, en op het tentamen het goede antwoord.
Pak het formuleblad erbij dat je bij het tentamen krijgt. Wijs op het formuleblad de formule aan waarmee je T7.2 uitrekent. Wat vul je in voor elk symbool?
x̄ ± z * σ/√n — de formule van het betrouwbaarheidsinterval.
- x̄ = 108, de uitkomst van je steekproef.
z * = 1,96, de kritische z-waarde bij 95%. Geen keer-teken.- σ = 15, de van losse egels.
- n = 9, dus σ/√n = : het lineaaltje .
Samen: .
Wat blijft liggen
Hier gebruiken we alsof we ’m kennen. In de echte wereld ken je de populatie-standaardafwijking nooit (alleen God) — dan schat je ’m met uit de steekproef, wordt het lineaaltje de standaardfout , en gebruik je de -verdeling in plaats van . Dat komt in thema 9. En in thema 8 draaien we de vraag om: niet “wat is ?”, maar “ís gelijk aan een bepaalde waarde?” — dan toetsen we.
Tot slot
Hang al die bordjes op en je ziet het: ze klitten samen rond de 100, veel dichter dan losse egels ooit doen — want een gemiddelde middelt de uitschieters weg. Hoe meer egels per bordje, hoe strakker dat klitten, en die strakheid is precies de standaardfout . Daar hang je je betrouwbaarheidsinterval omheen, en zelfs dat is geen nieuwe truc: hetzelfde fietsje van thema 4, alleen rijdt het nu met de standaardfout als lineaaltje.
Tot nu toe vroegen we: wat is ? Een getal, met een marge eromheen. In het volgende thema draaien we ’m om — ís eigenlijk wel die ene waarde die ze beweren? Dan zijn we aan het toetsen.
Oefenboek OZP 1 · Thema 7, versie 0.1 (handrekenen & theorie). Doorlopend voorbeeld: de egels.
Terug naar boven