Van getallen naar categorieën
Tot nu toe verdiende elke meting een getal op een schaal: pienterheid, lengte, leeftijd. Maar veel waarnemingen zijn categorisch: bruin / grijs / zwart, geslaagd / gezakt, dorp / bos. Daar begin je niet met gemiddelden, maar met tellen. En daar past één toetsfamilie: de chi-kwadraat.
Die toets komt in dit thema in één gedaante: de kruistabel. Je zet twee categorische variabelen naast elkaar en vraagt of ze samenhangen — hangt roken samen met geslacht, hangt de woonplek van een egel samen met waar hij eet. Dat is ook de gedaante op je formuleblad, waar bij chi-kwadraat alleen staat: rijen en kolommen, dus een tabel.
Er is nog een tweede gedaante, voor één categorische variabele tegen een verwachte verdeling. Die vind je verderop in de uitklapper Voor wie verder wil; voor de route van dit thema heb je hem niet nodig.
Het recept: vergelijk geobserveerd met verwacht onder , en tel de gestandaardiseerde afwijkingen op. Het is opnieuw DATA = FIT + RESIDU: wat zien we (), wat verwacht het model (), en hoeveel blijft er over ()? En we kwadrateren die afwijkingen, zodat plus en min elkaar niet wegvlakken — net als bij de blauwe vierkantjes van de variantie in thema 1.
Chi-kwadraat onafhankelijkheid (kruistabel)
We vragen 400 mensen of ze roken, en noteren hun geslacht. Hier heeft iedereen al een onderbuikgevoel bij: roken mannen vaker? Vraag: hangt roken samen met geslacht?
| mannen |
40 |
160 |
200 |
| vrouwen |
20 |
180 |
200 |
| kolom-totaal |
60 |
340 |
400 |
Voel eerst wat “verwacht” betekent. In het algemeen rookt 60 van de 400 — 15% (iedereen die binnen kan wandelen én rookt). Stel nu dat roken en geslacht onafhankelijk zijn, dat het één niks met het ander te maken heeft: dan zou je verwachten dat in élke groep gewoon diezelfde 15% rookt. Je past die kans niet aan omdat er toevallig een man of een vrouw komt binnenwandelen. 200 mannen → je verwacht rokers. Maar er roken er 40. Méér dan verwacht — precies wat je onderbuik al fluisterde. En bij de vrouwen andersom: verwacht 30, geobserveerd 20, minder. Juist in dat gat tussen verwacht en geobserveerd zit het verhaal — en daar mag je van schrikken. Die verwachte aantallen zijn het meest informatief: heb je ze eenmaal, dan vertelt de rest zich vanzelf.
Ruwe aantallen liegen zodra de groepen niet even groot zijn. Daarom zet je een kruistabel eerst om in percentages, en dat heet percenteren. De vraag is alleen: percenteren waarover?
Regel: percenteer over de variabele die de oorzaak zou kunnen zijn — de voorspeller. Dan tellen de percentages per groep op tot 100% en vergelijk je groepen mét elkaar. Hier staat geslacht in de rijen, dus percenteer je over de rijen: van de 200 mannen rookt 20%, van de 200 vrouwen 10%. Die twee mag je naast elkaar leggen. (Die 20 en 10 zijn wat je zág; de 15% hierboven is wat voorspelt — in beide groepen dezelfde.)
Had je over de kolommen gepercenteerd, dan kreeg je “van de rokers is 67% man” — waar en volstrekt nutteloos, want dat zegt vooral iets over hoeveel mannen er meededen.
En bij het interpreteren draai je ’m om: heb je over de rijen gepercenteerd, dan lees je je conclusie over de kolommen — en dat betekent: van boven naar beneden binnen één kolom. Kijk de kolom rookt omlaag, zie 20% tegen 10%, en schrijf mannen roken relatief vaker dan vrouwen. Niet rokers zijn vaker man: dat zou je over de rijen lezen, en dat is de richting waarin je net gepercenteerd hebt.
Het rekenen zelf is een beweging, geen formule om te stampen. Voor een cel: kijk naar zijn rijtotaal (opzij) en zijn kolomtotaal (omlaag), vermenigvuldig die twee, en deel door . Cel → rij → kolom → delen door .
- (man, rookt) — precies die 15% van zojuist
- (vrouw, rookt)
- (man, niet) , (vrouw, niet)
Eén ding, drie jasjes. Die 15% rokers is hetzelfde als de proportie , en dat is weer hetzelfde als de kans dat een willekeurige bezoeker rookt. Een percentage is gewoon een proportie maal honderd: (keer 100), (deel door 100). Proportie en kans zijn één pot nat — allebei een getal tussen 0 en 1.
Daarom zijn er twee routes naar precies hetzelfde verwachte aantal:
- Korte route (de formule): .
- Lange route (via de proportie): bepaal eerst de proportie rokers over iederéén — (= 15%) — en leg die over het rijtotaal: .
Ze geven hetzelfde, want . De lange route laat alleen zien wáár de formule vandaan komt: onder rookt in élke groep diezelfde 15%.
De val (waar veel mensen op stuk lopen): die is een proportie (15%), nog géén aantal. Het verwachte aantal krijg je pas ná het vermenigvuldigen met het kolomtotaal. Verwar die twee niet — en onthoud: een kolomtotaal krijg je door de cellen op te tellen (), niet te vermenigvuldigen.
Vervolgens over alle vier de cellen:
Ook hier volgt uit het aantal categorieën — nu in twee richtingen: het aantal rijen en het aantal kolommen. Voor een kruistabel met rijen en kolommen: . Hier een -tabel, dus . (Intuïtie: liggen de rij- en kolomtotalen vast, dan kun je nog cellen vrij invullen; de rest volgt dwingend.) Kritieke waarde . Onze 7,84 is groter → verwerp de nulhypothese: roken hangt samen met geslacht — mannen roken vaker dan je onder onafhankelijkheid zou verwachten, precies wat iedereen al dacht.
De -tabel heeft een naam die je moet kennen, want zo heet hij op je tentamen: bij Moore & McCabe is dit tabel F. Die letter heeft niets met een F-toets te maken; het is gewoon de letter die dat boek aan deze tabel gaf, net zoals de -tabel daar tabel A heet.
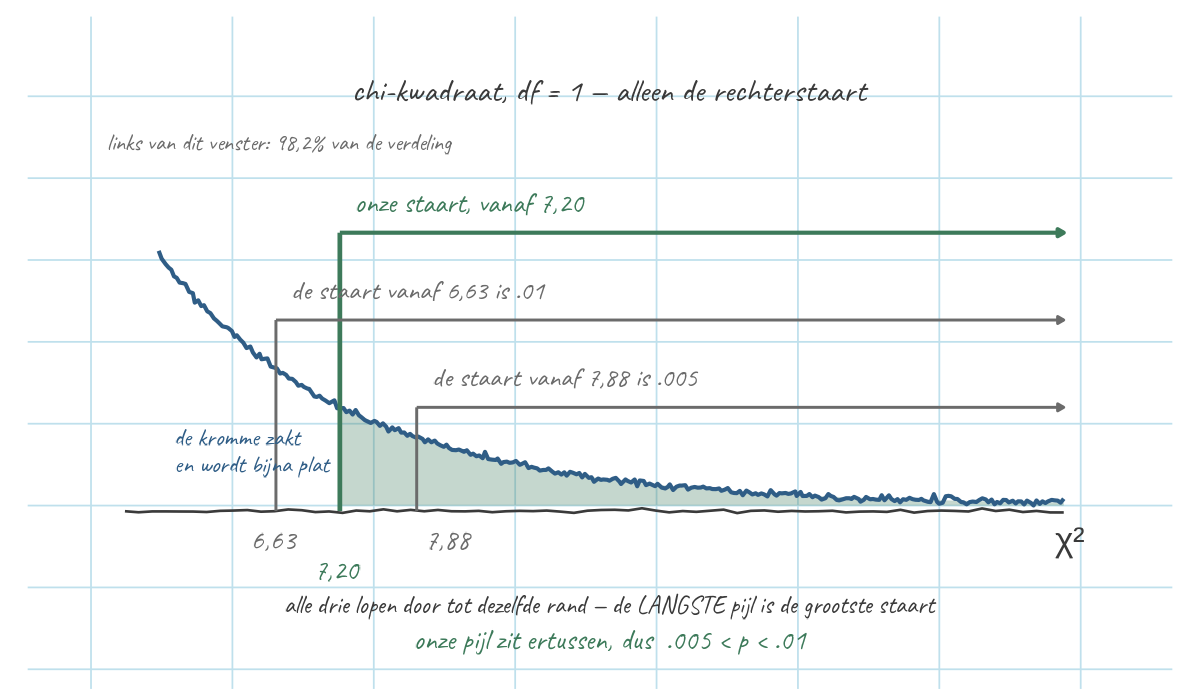
Hij heeft één rij per en één kolom per rechterstaartkans. En hij geeft je geen ; hij geeft je grenzen, en jij zegt waar je kans tussen ligt.
Loop de rij langs en je ziet onze tussen twee kolommen vallen: in de kolom en in de kolom .
En let nu op welke kant dat op werkt, want de getallen lopen op terwijl de kansen aflopen:
- onze staat rechts van → er blijft minder staart over → is kleiner dan ;
- onze staat links van → er blijft meer staart over → is groter dan .
Samen: . Verder naar rechts betekent altijd minder staart, dus een kleinere kans — dat is de hele leesregel, en je gebruikt hem bij elke chi-kwadraat die je opzoekt.
Welke cel drijft dat? Bij een -tabel: geen enkele in het bijzonder — en dat is geen slap antwoord maar een stelling. Met ligt de hele tabel vast zodra één cel vastligt, dus alle vier de gestandaardiseerde celresiduen zijn even groot: hier , in élke cel. Wie hier per cel gaat toetsen, toetst vier keer hetzelfde.
Wat je wél mag zeggen lees je uit de rijpercentages: van de mannen rookt 20%, van de vrouwen 10%. Vandaar de afspraak — een post-hoc toets doe je pas bij , en alleen als significant is.
De ruwe celresiduen blijven wel nuttig, niet om cellen te toetsen maar omdat hun kwadraat precies de celbijdrage aan is: bij de rokende mannen, bij de vrouwen, bij de niet-rokers.
Die is een ruw residu. Mooi, want z’n kwadraat is precies de celbijdrage aan — maar hij heeft één vervelende eigenschap: zijn standaarddeviatie is niet 1. En je weet het inmiddels: ruw is ruk. Wil je ’m tegen leggen (de uit thema 4), dan moet hij éérst écht gestandaardiseerd worden.
Waarom is te groot? is de spreiding van een vrije cel — een telling die los mag fluctueren (variantie = gemiddelde = , zoals bij een vrij oplopende telling). Maar jouw cel is niet vrij. Hij hangt vast aan zijn rijtotaal en zijn kolomtotaal: die liggen vast, en dat bindt de cel. Een gebonden cel kan minder ver afdwalen dan een vrije, dus zijn echte spreiding is kleiner dan . Deel je alleen door , dan deel je door te véél → je residu wordt te klein → je bent te voorzichtig en mist échte uitschieters.
Het gestandaardiseerde celresidu corrigeert dat: hij deelt óók door de bindingsfactor . Pas díé mag je als een gewone aflezen. Dat cel-voor-cel nakijken heet een post-hoc toets — achteraf, want hij mag pas ná een significante . En zelf heet daarom een omnibustoets: hij zegt alleen dát er iets is, nooit wáár.
Op de rokers. De man-rookt-cel: ruw — netjes ónder ±2, je zou ’m bijna laten lopen.
Maar de bindingsfactor is , en dus: Voorbij ±2. Reken nu de andere drie cellen uit: overal , alleen wisselend van teken. Dát is wat betekent — en meteen de reden dat een post-hoc toets hier niets toevoegt.
En de cirkel sluit: weet je nog dat bij een -tabel ? Dáár is die . , en . Rond. De ruwe 1,83 was alleen de cel z’n hapje van ; de gestandaardiseerde 2,80 ís de hele .
Eén waarschuwing: wordt vanzelf groter bij een grotere steekproef. Een hoge betekent dus significant, niet automatisch een sterk verband — maten voor de sterkte (zoals Cramérs V) leer je later.
Strikvraag. kent geen richting: door het kwadrateren telt elke afwijking — een cel té hoog of té laag — even hard mee. De toets vraagt niet “hoger of lager?” maar “wijkt het af, hoe dan ook?”. In die zin is stiekem tweezijdig (bij meer dan twee categorieën eigenlijk: alle kanten tegelijk).
Maar juist omdat beide kanten al in dat kwadraat zitten, lees je één staart (de rechter) en doe je nooit ×2 — de “keer 2” van een tweezijdige z-toets is hier al gedaan door het kwadrateren.
Mooiste bewijs: bij deze -tabel () is het létterlijk tweezijdig. Daar geldt , en de rechterstaart-kans van is exact de tweezijdige van die . De ×2 zit er dus echt al in.
Dezelfde acht stappen als bij de z- en de t-toets (thema 8 en 9), nu met tellingen in plaats van gemiddelden.
- Onderzoeksvraag: hangen de twee variabelen samen?
- Hypothesen. : de twee variabelen zijn onafhankelijk. : ze hangen samen.
- Toetskeuze: chi-kwadraat op een kruistabel.
- Onder : bereken de verwachte aantallen per cel.
- Toetsingsgrootheid: , met — rijen, kolommen.
- Opzoeken: leg je naast de grenzen in tabel F, op de rij van jouw — altijd de rechterstaart. Valt hij tussen twee kolommen, dan weet je tussen welke twee kansen je p ligt; valt hij vóór álle kolommen, dan is groter dan de grootste.
- Statistische beslissing: is je groter dan de kritieke waarde (oftewel )? Dan verwerp je . Is hij kleiner, dan verwerp je niet. Schrijf die beslissing op; hij is een eigen stap en geen onderdeel van je conclusie.
- Inhoudelijke conclusie: de samenhang tussen X en Y — zeg wélk verband (richting en welke cellen beoordeel je uit de tabel en de residuen, niet uit zelf).
Data om mee te spelen: roken_geslacht.sav — of de hele zip. Met de hand snap je nu wat er gebeurt; in SPSS doe je dezelfde toets met twee categorische variabelen.
Analyze → Descriptive Statistics → Crosstabs → één variabele naar Row(s), de andere naar Column(s) → Statistics… → Chi-square aanvinken → Continue → Cells… → Expected aanvinken → Continue → OK.
Je leest de toets af in de regel Pearson Chi-Square: de waarde van , en de bijbehorende kans (Asymptotic Significance). En met Expected aan zet SPSS in elke cel het verwachte aantal onder je geobserveerde aantal, zodat je de vier getallen die je zelf uitrekende naast de zijne kunt leggen.
Chi-kwadraat kan ook met één categorische variabele: past de verdeling die je telde bij een verdeling die je verwachtte? Dat heet een goodness-of-fit-toets. Je hebt hem voor dit thema niet nodig — bij chi-kwadraat staat op je formuleblad alleen , en dat zijn rijen en kolommen. Maar het is dezelfde machine, en je ziet er goed aan waar de vrijheidsgraden vandaan komen.
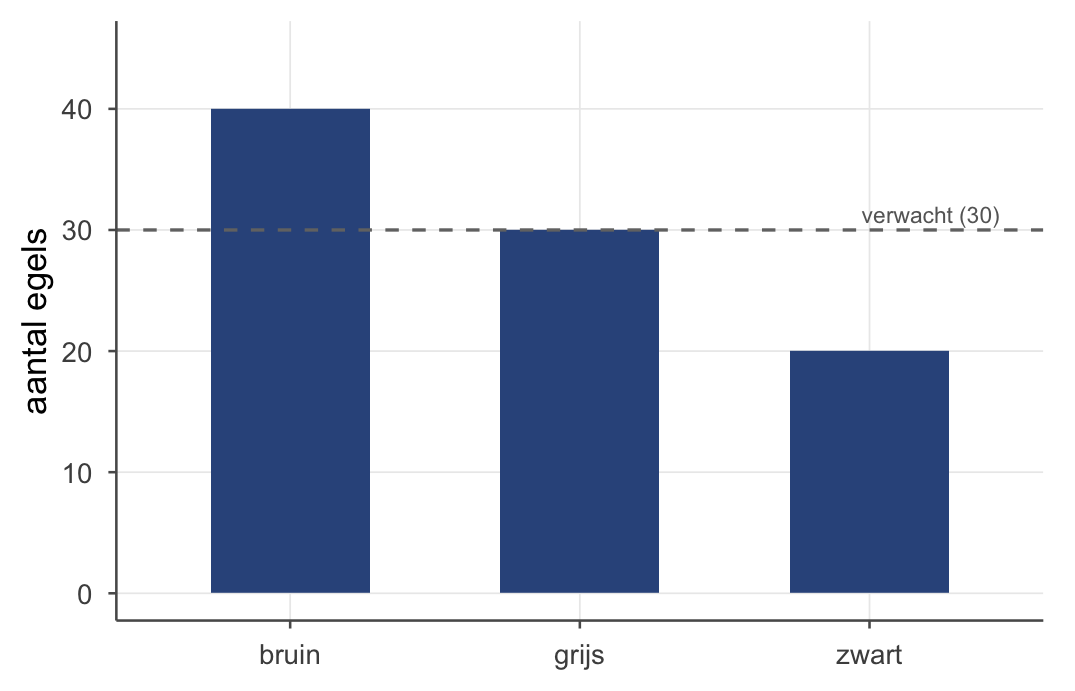
De egels — drie pelskleuren. Onder egels zien we drie pelskleuren: bruin, grijs en zwart. De biologen vermoeden dat ze in de natuur gelijk verdeeld zijn (een derde elk). Wij vangen er 90 en zien: 40 bruin, 30 grijs, 20 zwart. Klopt die gelijke verdeling?
Onder verwachten we egels per kleur — geen rijtotaal maal kolomtotaal meer, want er is maar één rij. De rest is hetzelfde:
| bruin |
40 |
30 |
+10 |
+1,83 |
3,33 |
| grijs |
30 |
30 |
0 |
0 |
0 |
| zwart |
20 |
30 |
−10 |
−1,83 |
3,33 |
|
|
|
|
|
= 6,67 |
Hier volgt uit het aantal categorieën in één richting: , met het aantal categorieën (drie kleuren), niet het aantal egels. Kritieke waarde . Onze 6,67 is groter → verwerp de nulhypothese dat de drie pelskleuren gelijk verdeeld zijn.
En net als bij de kruistabel vertellen de cellen waar het aan ligt. Lees de ruwe celresiduen (de vierde kolom): bruin zit +1,83 boven verwachting, zwart −1,83 eronder, grijs precies goed. Kwadrateer zo’n residu en je hebt exact die cel z’n bijdrage aan : — samen weer 6,67. (Kwadrateer je het afgeronde residu , dan kom je op : de afronding zit in het residu, niet in de bijdrage.)
In SPSS gaat dit niet via Crosstabs, want daar heb je twee variabelen voor nodig. Met egel_pelskleur.sav: Analyze → Nonparametric Tests → Legacy Dialogs → Chi-square → zet pelskleur bij Test Variable List → onder Expected Values staat All categories equal aan, en dat is precies de gelijke verdeling uit → OK.
De val van Simpson — een verband dat omkeert
Alles wat we sinds correlatie (thema 5) doen heeft één gevaar: een globaal verband kan subgroepen verbergen. Een kruistabel laat het globale plaatje zien. Maar soms verbergt dat plaatje een omgekeerd verband dat binnen subgroepen leeft. Dat is Simpson’s paradox, en je moet ’m kennen — anders trek je serieus de verkeerde conclusie.
Een universiteit kijkt naar de slaagpercentages van jongens en meisjes bij twee opleidingen.
Opleiding A (makkelijk): jongens 480/800 = 60% geslaagd; meisjes 140/200 = 70% geslaagd. → meisjes scoren beter.
Opleiding B (moeilijk): jongens 40/200 = 20% geslaagd; meisjes 200/800 = 25% geslaagd. → meisjes scoren beter.
Totaal: jongens 520/1000 = 52%; meisjes 340/1000 = 34%. → jongens scoren beter ?!
Binnen elke opleiding doen meisjes het beter; maar in het totaal lijken jongens beter. Hoe kan dat? Doordat de groepen zich anders verdelen over de opleidingen. Veel meisjes deden de moeilijke opleiding (waar iederéén slechter scoort), en veel jongens de makkelijke. Dat trekt het meisjes-gemiddelde naar beneden en het jongens-gemiddelde omhoog.
Een derde variabele (hier: opleiding) die met beide andere samenhangt, kan een verband doen kantelen. Aggregeer dus nooit zonder na te denken: kijk altijd binnen relevante subgroepen. Dit is ook precies wat een covariaat doet in latere analyses — controleren voor zo’n meelopende variabele.
Oefenen
Een egelwerkgroep vangt in het najaar 120 egels: 40 in het dorp en 80 in het bos. Elke egel krijgt een merkje, en bij álle voerbakjes in de streek — in de dorpstuinen én bij de boerderijen aan de bosrand — staat een camera. Zo weten ze van elke egel of hij dat najaar weleens uit zo’n bakje heeft gegeten.
Vraag: hangt de woonplek van een egel samen met of hij uit een voerbakje eet?
| dorp |
16 |
24 |
40 |
| bos |
14 |
66 |
80 |
| kolom-totaal |
30 |
90 |
120 |
Bereken het verwachte aantal in elk van de vier cellen: rijtotaal maal kolomtotaal, gedeeld door .
Bereken als de som van over alle vier de cellen.
Hoeveel vrijheidsgraden heeft deze tabel?
Zoek je op in tabel F. Tussen welke twee kritieke waarden ligt hij, en wat zegt dat over p?
Beslis op .
Schrijf één zin over de egels, zonder symbolen.
Percenteer over de voorspeller — dat is hier de woonplek, want dát is de variabele die de oorzaak zóu kunnen zijn: waar een egel woont kan bepalen wat hij tegenkomt, en niet andersom. Zeg met die twee percentages hoe groot het verschil is.
- : woonplek en voerbakje-gebruik zijn onafhankelijk
- : ze hangen samen
- = 10 en 30 (dorp), 20 en 60 (bos)
- ·
- tabel F, rij : ligt tussen () en () →
- → verwerpen
- Antwoord: waar een egel woont hangt samen met of hij uit een voerbakje eet — van de dorpsegels at 40,0% uit een bakje, van de bosegels 17,5%
- / — de opgave vraagt er niet om, maar het stappenplan begint hier (elk op een regel):
= woonplek en voerbakje-gebruik zijn onafhankelijk
= woonplek en voerbakje-gebruik hangen samen.
- (a) Verwachte waarde per cel . Let op de beweging: voor elke cel eerst opzij naar het rijtotaal, dan omlaag naar het kolomtotaal, dan delen door 120.
- dorp, at uit een bakje:
- dorp, at niet:
- bos, at uit een bakje:
- bos, at niet:
Controle: de vier ’s hebben dezelfde randtotalen als je tabel (40 en 80 opzij, 30 en 90 omlaag). Kloppen die niet, dan is er één verkeerd gerekend.
- (b) per cel — in een tabel, zo zie je elke stap terug:
| dorp, at uit een bakje |
16 |
10 |
+6 |
3,60 |
| dorp, at niet |
24 |
30 |
−6 |
1,20 |
| bos, at uit een bakje |
14 |
20 |
−6 |
1,80 |
| bos, at niet |
66 |
60 |
+6 |
0,60 |
|
|
|
|
7,20 |
Dezelfde afwijking van 6 levert per cel een andere bijdrage — 3,60 tegenover 0,60 — en dat komt van het delen door : 6 egels te veel op een verwachte stapel van 10 is een grote afwijking, dezelfde 6 op een stapel van 60 valt nauwelijks op.
(c) .
(d) Opzoeken in tabel F, rij — altijd de rechterstaart (richtingloos, nooit ×2). Onze ligt tussen en , en die twee kolommen dragen en . Kijk eerst naar het plaatje, dan zie je meteen welke kant dat op werkt:
Ons vlak is dus kleiner dan en groter dan : .
(e) Beslissen: → verwerpen. (Je had het ook aan de kritieke waarde kunnen zien: , en 7,20 is ruim groter.)
(f) Conclusie: waar een egel woont hangt samen met of hij uit een voerbakje eet.
(g) Percenteren over de voorspeller — woonplek staat in de rijen, dus over de rijen: van de dorpsegels at 16 van de 40 uit een bakje (40,0%), van de bosegels 14 van de 80 (17,5%). Dat scheelt 22,5 procentpunt, oftewel: een dorpsegel deed het 2,3 keer zo vaak. Onder was het in beide groepen 25,0% geweest — de 30 bakjes-eters gedeeld door alle 120 egels. Dat de bakjes in het dorp staan is natuurlijk geen nieuws; dat de toets het oppikt en hoe groot het gat is, is het.
Data: egel_voerbakje.sav — 120 egels, twee kolommen: woonplek (1 = dorp, 2 = bos) en voerbakje (0 = at niet uit een bakje, 1 = at uit een bakje). Eén rij per egel, dus je hoeft niets te wegen.
Analyze → Descriptive Statistics → Crosstabs → woonplek naar Row(s), voerbakje naar Column(s) → Statistics… → Chi-square aanvinken → Continue → Cells… → Expected aanvinken → Continue → OK.
Aflezen: in de kruistabel staat onder elk geobserveerd aantal het verwachte (10, 30, 20, 60) — je vier getallen uit (a). In de tabel eronder is Pearson Chi-Square jouw toets: 7,200, df = 1, Asymp. Sig. = ,007.
En kijk wat dat met je antwoord op (d) doet. Jij sloot de kans in tussen en ; SPSS zet er ,007 neer, en dat zit er precies tussenin. Je tabel-aflezing klopte dus — SPSS is alleen preciezer, want die heeft alle kolommen. (SPSS schrijft zijn kansen met een komma; in een APA-zin schrijf je diezelfde kans als p = .007.)
Bij een 2×2-tabel zet SPSS er ongevraagd nog een regel Continuity Correction bij, en die staat op 6,050. Dat is een andere, iets voorzichtiger toets (van Yates) en niet jouw handwerk; de beslissing is hier dezelfde, maar het getal dat je met je eigen som vergelijkt staat op de regel Pearson Chi-Square.
Een schoolinspecteur bekijkt twee scholen op één-jaars-doorstroom. School X: 80%. School Y: 65%. School X lijkt beter. Maar binnen elke leerlingcategorie (laag / hoog vooropleidingsniveau) doet School Y het juist iets beter. Hoe kan dat?
School X heeft waarschijnlijk veel meer leerlingen met een hoog vooropleidingsniveau (die sowieso vaker doorstromen, op elke school). Het aggregaatcijfer reflecteert dus vooral de samenstelling van de leerlingen, niet de kwaliteit van de school. Net als bij Simpson: een meelopende derde variabele (vooropleiding) verklaart het schijnverschil. Wie scholen eerlijk wil vergelijken, vergelijkt binnen vooropleidingsniveau — niet over de hoofden heen.
In het bos is aan 300 dieren gevraagd of ze bang zijn voor onweer. Alleen de randtotalen staan vast:
| ja |
? |
? |
120 |
| nee |
? |
? |
180 |
| kolom-totaal |
180 |
120 |
300 |
Welk deel van alle dieren is bang voor onweer? Geef je antwoord als proportie én als percentage.
Onder (bang-zijn staat los van soort): hoeveel dassen verwacht je die bang zijn? Doe het via de proportie-route (proportie kolomtotaal).
Controleer met de formule — krijg je hetzelfde?
Een medestudent zegt: “die ,40 ís het verwachte aantal bange dassen.” Klopt dat? Leg in één zin uit.
(a) , oftewel 40% is bang voor onweer (proportie = percentage 40% = de kans dat een willekeurig dier bang is).
(b) Onder is in élke soort 40% bang. Dassen: .
(c) . Hetzelfde — want .
(d) Nee. is een proportie (40%), géén aantal. Het verwachte aantal is — je moet de proportie eerst nog over het kolomtotaal leggen.
Is er in het bos een verband tussen pootvoorkeur (rechts / links / nog geen) en soort (das / uil)? Bij 200 jonge dieren:
| rechts |
60 |
50 |
110 |
| links |
15 |
16 |
31 |
| nog geen |
25 |
34 |
59 |
| kolom-totaal |
100 |
100 |
200 |
Toets op .
- : geen verband (soort en pootvoorkeur onafhankelijk)
- : wel verband
- ·
- -tabel (rechterstaart): de .25-grens () →
- → niet verwerpen
- Antwoord: geen significant verband tussen soort en pootvoorkeur
- / (elk op een regel):
= geen verband (onafhankelijk)
= wel verband (afhankelijk).
- Verwachte waarde per cel . Beide kolommen zijn hier 100, dus per rij:
- rechts: (das én uil)
- links:
- nog geen:
- per cel — in een tabel, zo zie je elke stap terug:
| rechts, das |
60 |
55 |
0,455 |
| rechts, uil |
50 |
55 |
0,455 |
| links, das |
15 |
15,5 |
0,016 |
| links, uil |
16 |
15,5 |
0,016 |
| nog geen, das |
25 |
29,5 |
0,686 |
| nog geen, uil |
34 |
29,5 |
0,686 |
|
|
|
2,31 |
Hier gaat het anders dan in T11.1: géén van deze zes bijdragen komt rond uit — is en stopt nooit. Reken ze dus onafgerond in je rekenmachine door en rond pas het eindantwoord af. En let op waar dat aan ligt: niet aan de halve ’s. Een hele helpt niets — de hierboven is heel, en zijn bijdrage is net zo oneindig als die van . Wát netjes uitkomt zie je pas als je deelt, en daarom is pas afronden aan het eind geen vuistregel maar gewoon de regel. Daarom staat deze kolom ook op drie decimalen waar die van T11.1 er twee had: op twee zou hij geven, en dat spreekt de som eronder tegen.
- .
- Opzoeken in de -tabel — altijd de rechterstaart (richtingloos, nooit ×2): ligt vóór (de .25-grens bij ) → .
- Beslissen: → niet verwerpen.
- Conclusie: er is geen significant verband tussen soort en pootvoorkeur; de kleine verschillen zijn toeval.
Tot slot
Geen gemiddelden meer, gewoon tellen — maar onder de motorkap is er niks veranderd. Je zet wat je ziet () naast wat het model verwacht (), en in dat gat ertussen zit het hele verhaal. Te groot een gat, gekwadrateerd en opgeteld, en je gooit “het is toeval” overboord. De fiets in de bakker, nu in een kruistabel. En onthoud dat ene: kent geen richting, alles wordt gekwadrateerd, dus nooit Pippi.
En dan Simpson, helemaal aan het eind, als een waarschuwing die je nooit meer kwijtraakt: aggregeren is een vorm van vergeten. De subgroepen zwijgen niet — je hoort ze alleen niet meer.
Oefenboek OZP 1 · Thema 11, versie 0.1 (handrekenen & theorie). Doorlopend voorbeeld: de egels (+ alledaagse voorbeelden: roken, school).
Terug naar boven